Soll ein verpasster cron-Lauf nachgeholt werden? grace_minutes antwortet pro Job
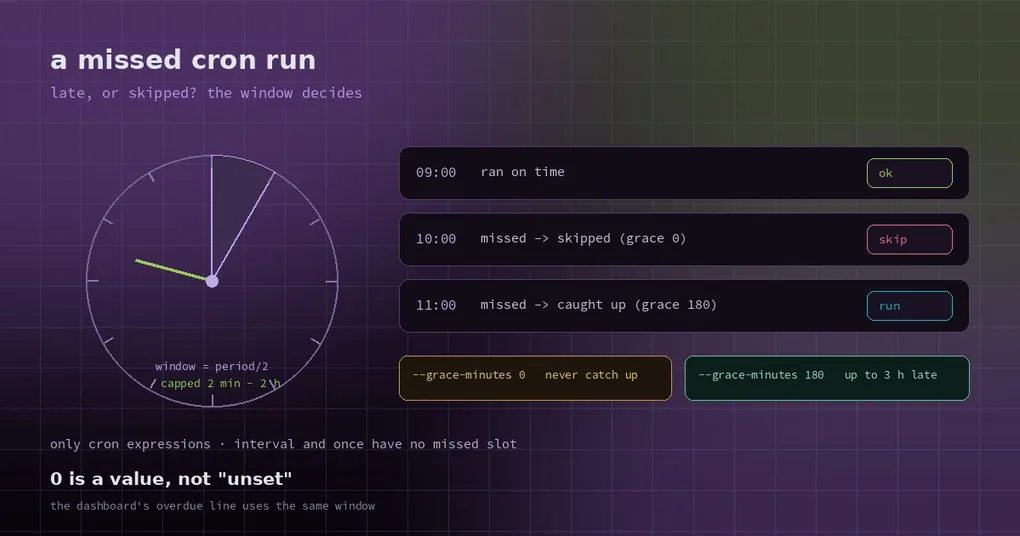
Du klappst den Laptop für ein zweistündiges Meeting zu. Beim Aufklappen warten zwei identische Tagesberichte auf dich – der 15-Uhr-Job hat seinen Slot im Schlaf verpasst, beim Aufwachen nachgeholt und dann um 16 Uhr noch einmal gefeuert. Du löschst das Duplikat und denkst: „nächstes Mal einfach überspringen“.
Nur gibt es das Nachholen aus gutem Grund. Wenn der 03-Uhr-Datensync ausfällt, weil die Kiste neu gestartet ist, soll er kurz nach dem Boot laufen und nicht erst morgen. Die Frage war nie, ob Nachholen gut ist, sondern wie lange ein bestimmter Job bereit ist zu warten. Hermes hat früher eine Regel auf alle Jobs angewendet. Jetzt kann jeder Job seine eigene setzen.
Was der Standard tatsächlich tut
Der Scheduler findet einen fälligen Zeitpunkt in der Vergangenheit und hat zwei Möglichkeiten: jetzt ausführen oder überspringen und am nächsten Termin neu verankern. Die Entscheidung fällt über ein Nachholfenster:
- die halbe Periode des Jobs,
- begrenzt auf 2 Minuten bis 2 Stunden.
Ein Job, der jede Minute läuft, hat also ein 2-Minuten-Fenster: Alles Spätere ist veraltet, und er springt auf die nächste Minute, statt eine Salve von Nachhol-Läufen abzufeuern. Ein Tagesjob bekommt 12 Stunden, das Aufklappen des Laptops am Vormittag gilt also noch als „spät, aber gültig“. Ein Stundenjob bekommt 30 Minuten.
| Zeitraum | Standard-Nachholfenster |
|---|---|
| Jede Minute | 2 Minuten (Untergrenze) |
| Alle 15 Minuten | 7,5 Minuten |
| Stündlich | 30 Minuten |
| Täglich | 12 Stunden |
| Wöchentlich | 2 Stunden (Obergrenze) |
Einmal-Jobs sind ein Sonderfall: Sie bekommen 120 Sekunden Kulanz und verfallen danach.
Die Regel ist vernünftig – lange Perioden vertragen mehr Verspätung, kurze spurten vor –, passt aber in zwei häufigen Fällen schlecht:
- Tages- oder Wochenberichte, die höchstens einmal am Tag laufen dürfen. Ein 12-Stunden-Fenster bedeutet, dass der Lauf beim Aufwachen startet, obwohl du die Zahlen längst am Handy erledigt hast – doppelte Benachrichtigungen.
- Zeitkritische Jobs. Marktdaten 30 Minuten vor Handelsbeginn zu ziehen ist um 11 Uhr sinnlos. Besser überspringen.
Das Fenster pro Job überschreiben
Der Override wird in Minuten angegeben:
# nie nachholen: ein verpasster Termin wird übersprungen
hermes cron edit market-open --grace-minutes 0

# bis zu drei Stunden Verspätung erlaubt
hermes cron edit nightly-sync --grace-minutes 180
Beim Anlegen geht es genauso:
hermes cron create "30 9 * * 1-5" "Kurse vor der Eröffnung abrufen und das Briefing schreiben" \
  --name market-open \
  --grace-minutes 5
Der Bereich reicht von 0 bis 1440 Minuten (ein voller Tag). 0 ist ein echter Wert und bedeutet „nie nachholen“. Zurück zum berechneten Fenster kommst du mit einem leeren String:
hermes cron edit nightly-sync --grace-minutes ""Das gilt nur für cron-Ausdrücke. once- und interval-Zeitpläne haben keinen verpassten Wanduhr-Slot – interval zählt ab dem letzten Lauf, once ist ein absoluter Zeitpunkt – die Einstellung bewirkt dort also nichts, und die CLI sagt dir das, statt sie stillschweigend zu schlucken.
Drei typische Einstellungen
Tages- und Wochenberichte: 0. Dich interessiert, ob er heute gelaufen ist, nicht ob die Kopie von gestern irgendwann auftaucht. Mit 0 wird der verpasste Termin übersprungen, der Skip protokolliert, und der nächste Slot läuft normal. Doppelte Benachrichtigungen hören auf.
Nächtliche Jobs auf einer Maschine, die schläft: großzügig setzen. Laptop-Nutzer sind der klassische Fall: Sync um 23 Uhr, Boot um 08 Uhr. Das Standardfenster deckt einen Tagesjob ab, ein Wochenjob ist aber bei 2 Stunden gedeckelt – mit --grace-minutes 600 holt er am Morgen trotzdem nach.
Zeitkritische Jobs: klein halten. Jobs vor Handelsbeginn, vor einem Launch oder vor dem Abgleich sind spät wertlos. Gib ihnen 5 oder 10 Minuten und lass sie überspringen. Ein veralteter Bericht, der erfolgreich durchläuft, ist gefährlicher als ein Job, der gar nicht lief, weil es niemandem auffällt.
Nachholen global abschalten
Wenn du nirgends nachholen willst:
hermes config set cron.catch_up_missed falseEin wiederkehrender Job jenseits seines Fensters wird dann am nächsten zukünftigen Termin neu verankert, statt zu feuern, und der Skip wird protokolliert. Jobs innerhalb des Fensters und manuelle Trigger verhalten sich normal. Zum Verhältnis beider Schalter: Der globale Schalter ist ein Ausschalter, der Wert pro Job lockert oder verschärft das Fenster eines einzelnen Jobs – ist das Nachholen global aus, hat ein großzügiges Fenster pro Job nichts mehr, worauf es wirken könnte.
Bei gehosteten Deployments mit einem gemanagten cron-Provider kommt eine weitere Ebene dazu: cron.misfire_grace_minutes (Standard 10) legt fest, wie lange das Gateway auf den Retry des Providers wartet, bevor es lokal nachholt – eine gescheiterte Übergabe kostet also Minuten statt eines ganzen Tages.
Vier Fallstricke
0ist ein Wert, kein „nicht gesetzt“. Die Code-Kommentare weisen ausdrücklich darauf hin:0 == False, also verwirft jede Prüfung nach dem Muster „leer heißt löschen“ stillschweigend die0und stellt das Standardfenster wieder her. CLI und Config-Parsing behandeln eine explizite0als gesetzt – wenn dujobs.jsonper Skript bearbeitest, sei genauso vorsichtig.- Nur cron-Ausdrücke.
interval- undonce-Zeitpläne ignorieren die Einstellung; sie steuert nicht, wie ein „alle 5 Minuten“-Job nachholt. - Profil-Verteilung wirft unbekannte Felder weg. Wenn du Job-Definitionen exportierst und über Profile verteilst, muss
grace_minutesin der Liste der erlaubten Felder bleiben, sonst fällt die Empfängerseite auf das Standardfenster zurück. - Der Health-Check wandert mit. Die Zeile „dieser Job ist überfällig“ im Dashboard nutzt dasselbe Fenster wie der Scheduler. Eine Änderung der Kulanz verschiebt also auch die Alarmschwelle – was richtig ist (sonst würden Jobs gemeldet, die der Scheduler als pünktlich ansieht), aber dein Alarm-Timing ändert sich mit.
Prüfen, ob es gewirkt hat
hermes cron list                 # die Zeile Grace erscheint nur bei gesetztem Override
hermes cron doctor               # meldet einen unbrauchbaren Wert oder einen auf falschem Zeitplan
In hermes cron list bekommt jeder Job-Detailblock eine Grace-Zeile, etwa mit 180 min. Jobs ohne Override haben keine solche Zeile. hermes cron doctor prüft zwei Fehlerbilder: einen unbrauchbaren Wert und einen Wert auf einem Zeitplan, der ihn nicht nutzen kann. Ob wirklich übersprungen wurde, siehst du an der Log-Zeile Skipping missed occurrence – sie nennt die Ursache (grace_minutes oder das globale cron.catch_up_missed=false) und den nächsten Laufzeitpunkt.
Eine vollständige Health-Check-Runde findest du im Leitfaden zum cron doctor; zu Fehlläufen durch Zeitzonen im Beitrag zu Zeitzonen und Sommerzeit; zum Aufbau von Jobs von Grund auf im Leitfaden zur cron-Automatisierung.
Status
grace_minutes ist am 2026-10-28 auf main gelandet und mit v0.22.6 (2026-11-02) in ein Release gekommen – ein normales Update genügt, dann lässt sich das Nachhol-Fenster pro Job setzen. Auf älteren Builds bleibt als Ausweg der globale Schalter cron.catch_up_missed: eine Lösung für alle, aber genug, um doppelte Nachhol-Läufe zu stoppen.