Dijo que el trabajo estaba creado. El trabajo nunca existió.
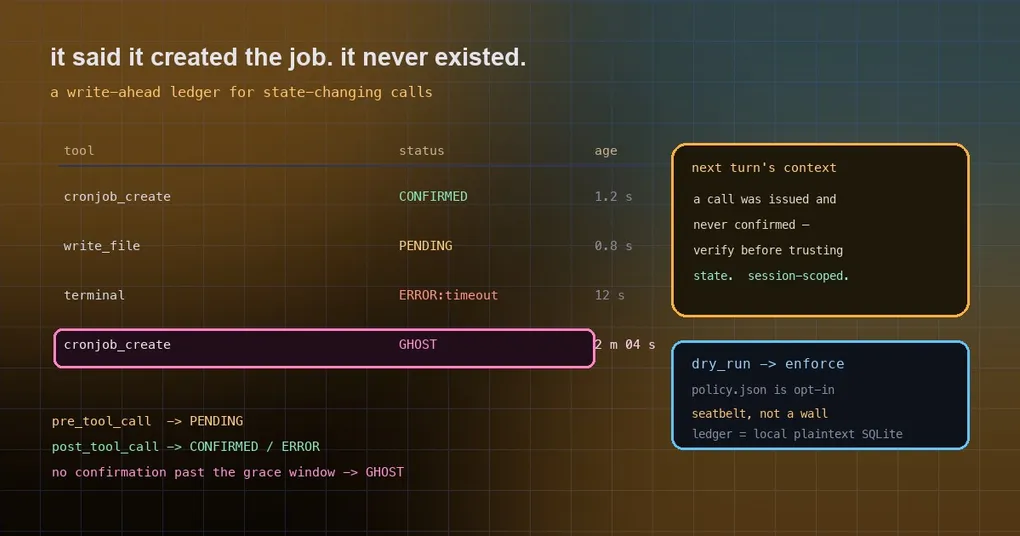
Le pides al agente que prepare un trabajo que se ejecute cada mañana. Responde: creado, empieza mañana a las 8. A las 8 del día siguiente no pasa nada. Abres jobs.json y ese trabajo no existe. Miras los registros de ejecución y están vacíos. El log parece decir que nunca ocurrió nada. No te mintió: sí llamó a la herramienta. Simplemente el resultado nunca llegó, porque la compactación de contexto sustituyó todo ese turno por un resumen, y con él se fueron tanto «se emitió la llamada» como «el trabajo existe».
Lo que hace desagradable a esta clase de fallo no es la operación perdida. Es que nadie sabe que se perdió. El agente cree que nunca hizo la cosa, tú crees que nunca la hizo, y por eso nadie vuelve a arreglarla. El plugin de la comunidad agent-ledger, que esta semana ha entrado en el catálogo oficial de plugins, vigila exactamente ese hueco, y de paso saca a la luz una pregunta más general: ¿qué ha hecho tu agente que cambiara algo de verdad?
Qué es una llamada fantasma
Primero, un poco de contexto. Cuando una sesión se acerca a su umbral de contexto, Hermes compacta: los turnos más antiguos se sustituyen por un resumen para que la conversación pueda seguir. Ese mecanismo es necesario, pero tiene un caso límite. Cuando la compactación se dispara en mitad de una llamada a herramienta ya emitida cuyo resultado todavía no está confirmado, el turno se sustituye entero. Las consecuencias:
- la operación nunca se completó;
- ni error, ni reintento, ni una línea de log;
- el estado de la sesión dice que la herramienta nunca se llamó.
El issue upstream #90985 documenta un caso real: se emitió un cronjob_create a las 20:39:07Z y el trabajo no existía en ningún sitio, ni en jobs.json, ni en executions.db, ni en cron/output/. La ruta plausible que describe el issue: un turno emite varias llamadas a herramientas, su salida empuja el contexto más allá del umbral de compactación, se dispara la comprobación previa, la historia se reescribe como un resumen y el resultado de la llamada se evapora con ella. Ni rastro de que se intentara nada.
Hasta que el núcleo cierre esa ventana (y, si se quiere, también después), un registro que sepa qué pudo perder se gana su sitio. Esa es la premisa de agent-ledger.
Cómo los detecta: un registro write-ahead
El plugin se engancha a cuatro hooks y registra cada llamada a herramienta que cambia estado en un registro local:
| Hook | Qué hace |
|---|---|
pre_tool_call |
escribe una entrada PENDING (herramienta, argumentos, marca de tiempo, sesión) |
post_tool_call |
pasa la entrada a CONFIRMED, o registra ERROR:<type> |
pre_llm_call |
reconcilia: una entrada PENDING más antigua que su periodo de gracia es un fantasma |
on_session_start |
cuadra las cuentas al inicio de la sesión |
Solo se siguen las herramientas que cambian estado: write_file, patch, terminal, cronjob, delegate_task, las mutaciones de kanban y todas las herramientas MCP (reconocidas por el prefijo mcp__). Las herramientas de solo lectura no cuestan nada.
Los periodos de gracia son por herramienta en vez de un único número global: dos minutos por defecto, pero 30 minutos para delegate_task y 15 para terminal, para que las llamadas largas no queden mal etiquetadas. Una llamada reportada por error como fantasma que luego se confirma se revive en lugar de duplicar su fila. Las entradas son inserciones en SQLite en modo WAL, por debajo de 10 ms según el autor, y el registro nunca bloquea ni reescribe argumentos: es una caja negra, no una puerta.
Para mirarlo tú mismo:
sqlite3 ~/.hermes/plugin-data/agent-ledger/ledger.db "
  SELECT ts, tool_name, status, substr(args_json,1,60)
  FROM ledger ORDER BY id DESC LIMIT 20;"
Existen cuatro estados: PENDING, CONFIRMED, ERROR:<type> y GHOST_REPORTED (ya comunicado al agente).
Por qué se lo cuenta al agente en el siguiente turno en lugar de parar la llamada
Esta es la decisión de diseño que merece copiarse.
Cuando se detecta un fantasma, ese turno ya ha terminado: no puedes volver atrás y rehacerlo. Así que el plugin empuja el hecho al turno siguiente: el hook pre_llm_call puede devolver un valor context, que se inyecta en el mensaje de usuario del turno actual en lugar de en el prompt de sistema. El prompt de sistema es sensible a la caché; tocarlo la invalida. Pon el aviso en el mensaje de usuario y el agente se entera dentro de la conversación, donde todavía puede actuar: se emitió una llamada que nunca se confirmó; verifica el estado antes de confiar en él.
La segunda decisión es igual de contenida: ¿por qué no rechazar las llamadas sospechosas en pre_tool_call? Porque Hermes hace fallar ese hook de forma cerrada tras un timeout de 30 segundos; un registro lento acabaría bloqueando herramientas legítimas. Una caja negra no debería tener ese poder. El bloqueo es una función aparte y opcional, que comentamos más abajo.
Ponerlo en marcha
Instálalo desde el catálogo oficial (la entrada llegó esta semana):
hermes plugins install agent-ledger
hermes plugins enable agent-ledger
Para usar en su lugar la versión del repositorio del mantenedor, el README la clona en ~/.hermes/plugins/agent-ledger/, la activa y reinicia el gateway para que el plugin se cargue en la siguiente sesión.
Luego ejecuta el autotest para comprobar las firmas de los hooks contra tu versión:
python3 selftest.pyVerifica el emparejamiento emisión-confirmación, la confirmación de reserva por nombre de herramienta, la detección de fantasmas, la inyección de contexto y que solo se registren las herramientas que mutan.
El extra: una puntuación de postura OWASP
El plugin también incluye un script que puntúa la actividad registrada contra el OWASP Top 10 para Aplicaciones Agénticas 2026:
python3 posture.py                        # puntúa el registro en vivo
python3 -m posture ~/.hermes/plugin-data/agent-ledger/ledger.db
Con solo los metadatos del registro puede cubrir el uso indebido de herramientas (ASI02), la ejecución de código inesperada (ASI05), los fallos en cascada (ASI08) y los agentes descontrolados (ASI10), más una extensión de la comunidad para la agencia excesiva etiquetada ASI11: la lista oficial termina en ASI10, y el autor lo dice allí donde aparece. La puntuación es auditable: score = 100 − Σ severity_weight(finding), con CRITICAL 25 / HIGH 15 / MEDIUM 8 / LOW 3, sin deduplicar nunca los hallazgos, y con la lista completa de hallazgos siempre devuelta para que puedas recalcularla a mano.
Su modelo de confianza se declara sin rodeos, y es la frase que hay que recordar: el registro lo escribe el agente que se está puntuando. Un observador no puede puntuar a un agente que no registra nada, así que una puntuación de 100 significa «nada sospechoso en la actividad registrada», no «este agente se comportó bien». Trátalo como una señal de higiene, no como una prueba.
Aplicación de políticas: empieza con una simulación
Observar es lo que hace el núcleo; aplicar es la capa opcional que añade este plugin. Instala un paquete de políticas y observa durante unos días qué se habría bloqueado:
cp policy.example.json ~/.hermes/plugin-data/agent-ledger/policy.json
echo dry_run > ~/.hermes/plugin-data/agent-ledger/policy_mode   # solo registra, no bloquea nada
Cuando el informe te muestre cosas que de verdad quieres parar, pasa a enforce: las llamadas que coincidan se rechazan antes de ejecutarse, con el motivo devuelto al agente.
La honestidad del autor sobre la cobertura merece difundirse: la coincidencia se basa en firmas sobre el comando extraído, así que trátalo como un cinturón de seguridad, no un muro. Se conocen al menos tres formas de saltárselo: componer la cadena destructiva con sh -c (el texto literal nunca aparece en el comando), la indirección a través de variables de entorno (rm -rf $TARGET) y partir una acción peligrosa en dos llamadas individualmente inofensivas. Lo que sí detecta con fiabilidad es la clase del desastre accidental: borrados recursivos, pipe-to-shell, lecturas de credenciales. Para eso está exactamente el informe de simulación.
Dónde viven los datos y cómo tratarlos
- El registro es una base de datos SQLite local en texto plano en
<hermes_home>/plugin-data/agent-ledger/ledger.db. Guarda argumentos de herramientas de hasta 4000 caracteres (comandos de terminal, contenidos de archivos, argumentos MCP) más un resumen del resultado de 300 caracteres. Cualquiera con acceso al sistema de archivos puede leerlo: trátalo como tu historial de shell. - Los avisos de fantasmas están acotados a la sesión: una sesión solo ve sus propias llamadas sin confirmar.
- El registro nunca se poda automáticamente. Pon tu propio límite si lo quieres, por ejemplo conservar las 50.000 filas más nuevas:
sqlite3 ~/.hermes/plugin-data/agent-ledger/ledger.db \
"DELETE FROM ledger WHERE id NOT IN (SELECT id FROM ledger ORDER BY id DESC LIMIT 50000)"- Para un informe de postura diario,
posture_daily.pylo programas tú, no el plugin, y usa sus propias credenciales de bot (POSTURE_TELEGRAM_BOT_TOKEN/POSTURE_TELEGRAM_CHAT_ID). Nunca lee el.envde Hermes ni reutiliza el token de bot de tu agente.
Cómo se relaciona con lo que Hermes ya hace
Hermes tiene sus propias protecciones en torno al trabajo programado: qué proceso reclamó un trabajo, en qué estado se ha quedado atascado, cuánto tiempo lleva callado; contamos la mecánica en integridad de la compactación a mitad de turno y en la referencia de cron. agent-ledger lo aborda desde el otro lado: no le importa el estado de un trabajo, le importa si se emitió una acción que cambia estado sin confirmación, y cubre mucho más que cron: toda herramienta que muta. Los dos no chocan, e instalarlo no cambia nada del comportamiento de Hermes a menos que actives la aplicación de políticas de forma explícita.
La versión corta
- «La operación no ocurrió» y «la operación ocurrió pero nadie lo sabe» son fallos distintos, y el segundo suele salir más caro porque nada lo saca a la luz.
- Un registro write-ahead PENDING → CONFIRMED, ventanas de gracia por herramienta e inyección de contexto acotada a la sesión convierten una llamada fantasma en una línea de consejo: verifica antes de confiar.
- La puntuación de postura es una lente de auditoría útil, pero el registro lo escribe la parte que se está midiendo: léelo como higiene, no como veredicto.
- La aplicación de políticas es opcional y basada en firmas, con las formas de saltársela documentadas por el autor. Ejecútala primero en modo simulación y mira qué detectaría realmente.