Antes de apagar uma session de três meses, o Hermes agora pergunta primeiro
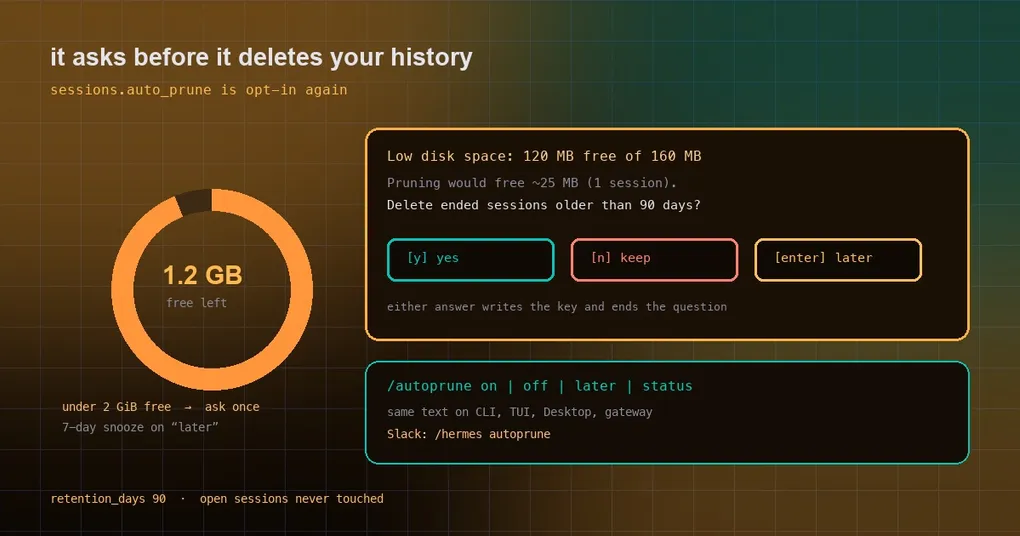
Um dia você vai procurar uma session de debugging de três meses atrás e o /resume simplesmente não a tem. Aí você lembra: sessions.auto_prune estava ligado, e tudo além de 90 dias foi apagado em algum startup — sem aviso, sem confirmação. Isso acabou de mudar. O prune automático voltou a ser opt-in, e ele só te interrompe quando o disco está realmente acabando.
O que mudou: nada é apagado por padrão
A mudança é direta: sessions.auto_prune volta ao padrão false. Os três estados de instalação se comportam assim:
| Sua configuração | Antes | Agora |
|---|---|---|
Nunca definiu sessions.auto_prune |
prune aos 90 dias, em silêncio | sem prune; pergunta uma vez quando o disco está baixo |
Definiu auto_prune: true |
prune | prune, sem mudança |
Definiu auto_prune: false |
mantido | mantido, nunca perguntado |
Repare na segunda linha: se você ligou de propósito, nada no seu setup mudou. O que mudou é o grupo grande que nunca deu opinião — o histórico deles deixou de ser tratado como espaço livre por padrão.
Quando ele se manifesta
A lógica vive num módulo novo, hermes_cli/prune_advisor.py, e o hot path é deliberadamente barato: um os.stat, um shutil.disk_usage e uma leitura pequena de YAML. Ele dispara só quando tudo isto vale:
- o disco está mesmo baixo: menos de 2 GiB livres, ou menos de 10% livres e também menos de 20 GiB de folga (um disco de 4 TB com 10% livres está bem, e essa cláusula existe exatamente para esse caso);
- seu
config.yamlnão tem a chavesessions.auto_prune; - não existe snooze ativo.
Só então ele abre o banco em modo somente leitura para estimar quanto um prune realmente liberaria — sessions encerradas além de retention_days, ponderadas pela fatia de mensagens de cada uma. Essa estimativa entra na própria pergunta, inclusive no caso incômodo: “o prune não vai resolver este disco”, seja porque nada é velho o bastante, seja porque há pouco reclaimável para tirar o disco da faixa baixa.
Uma pergunta, quatro superfícies
- CLI clássico: uma pergunta y / n / Enter (depois) no startup, só em TTY, ao lado da oferta de imagem de sandbox.
- TUI e Desktop: uma notificação fixa com a chave
sessions.auto_prune, por profile por processo. A estimativa do banco roda fora da thread para a UI nunca ficar esperando por ela. - Gateway de mensageria: a pergunta é postada no home channel do profile atendido. Um detalhe que importa — o snooze de “depois” só é registrado após um post entregue, então um gateway sem home channel não consegue engolir em silêncio a pergunta que o CLI está prestes a fazer.
- Slash command:
/autoprune on | off | later | status, com texto idêntico em todas as superfícies porque passa por um único executor de registro. O limite de 50 slash commands do Slack está cheio, então lá é/hermes autoprune.
O que cada resposta realmente faz
ongravasessions.auto_prune: truee faz prune das sessions encerradas e inativas além deretention_days(padrão 90). Sessions abertas, fixadas ou em meio a um turn nunca são tocadas.offgravafalse, mantém tudo e aposenta a pergunta para sempre.lateradia por 7 dias e pergunta de novo.
Para ver onde você está:
hermes config get sessions.auto_prune
/autoprune status
Disco ainda apertado? Limpe em camadas
O prune automático é uma camada. Quando você precisa mesmo de espaço, vá do menos para o mais destrutivo:
hermes sessions optimize          # junta segmentos FTS5 + VACUUM, sem mudar dados
hermes sessions optimize-storage  # migra o índice de busca para o layout compacto
hermes sessions archive           # ocultação em massa, sem apagar nada
hermes sessions prune             # exclusão de verdade, filtrável por janela / origem / título
optimize e optimize-storage reconstroem índices e recuperam fragmentação sem tocar no histórico, então rode esses primeiro. archive esconde sessions da lista sem apagá-las. prune é a coisa de verdade — verifique se o session_search ainda precisa daquele histórico antes de rodar.
Um jeito prático de escolher
A pergunta por trás dessa mudança é simples: quanto vale o seu histórico em comparação com o seu disco?
- Disco cronicamente apertado (um VPS pequeno, um container com algumas dezenas de GB) e você raramente olha para trás:
/autoprune ondá menos trabalho. - Você depende do
session_searchou mantém trilhas de auditoria: deixe o padrão (mantido, sem perguntar) e rodeoptimizede vez em quando. - Em dúvida: não escreva nada. O padrão é o estado conservador.
Se o state.db já está se comportando mal — digamos, o Hermes reporta outro processo segurando um WAL antigo — o prune não é a solução; comece pelo passo a passo de recuperação do session store. Para entender como funcionam os limites de session, leia o guia de limites de session, e para as flags exatas, a referência de hermes sessions.
Uma nota de status que vale dizer sem rodeios: isso entrou na main em 2026-10-16, depois do lançamento da v0.22.2 em 10-15, então ainda não está em nenhuma versão lançada — chega no build que o seu próximo hermes update puxar.