每条命令都先等 6.7 秒:Hermes 把启动时的三笔杂活搬走了
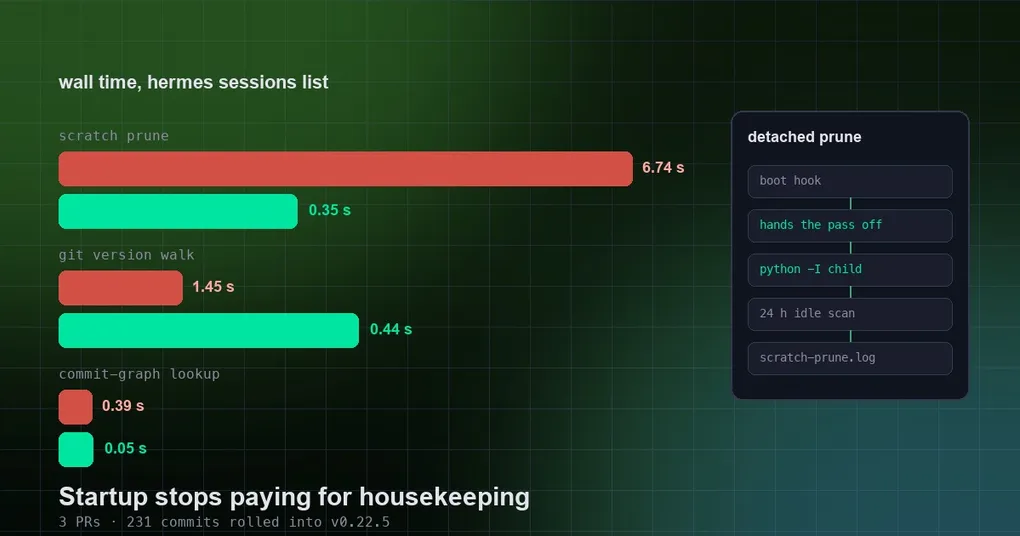
一个脚本里连着跑十几条 hermes sessions list,本该几秒钟结束,在某一台机器上却明显拖长——而且什么都没报错。每一次调用只是在干正事之前先交了一笔过路费。把 TUI 后端、hermes serve、gateway 和 Hermes 派生的每个子进程都算进来,“这工具怎么这么沉”就不再是感觉,而是一笔可以算清的账。2026-10-26 合并进 main 的三个 PR,各自结清了其中一笔;第四个小改动则修掉了藏在第一笔后面的一个更烦人的 bug。这四个 PR 都还没有进入任何正式版本,文末会说清楚。
“启动开销”到底是什么
每个 Hermes 进程——你敲的 CLI、TUI 背后的后端、hermes serve、gateway,以及它派生出来的每一个子进程——在碰到你的请求之前,都要先跑完同一套准备工作。启动开销就是 exec 到“第一件有用的事”之间的全部动作:读配置、导入模块、判断当前跑的是哪一份代码,以及,后来才发现,还包括删旧目录。
这笔钱容易被低估,因为你从来不会把它看成一次等待。一条每天跑两百次的命令,多一秒就是三分钟,但它表现出来的是“工具有点钝”,而不是“工具很慢”。下面这三笔之所以都压在关键路径上,原因跟正确性无关——它们只是恰好都是“第一个调用者”。
第一笔:临时目录清理挡在最前面
Hermes 给每个 profile 一个临时目录 ~/.hermes/cache/scratch,并把 TMPDIR/TMP/TEMP 指向它——但只在这三个变量原本没设的时候才这么做。
问题出在“扫”的时机。get_scratch_dir() 默认 prune=True,而几乎所有进程里它的第一个调用者就是启动钩子:hermes_bootstrap → export_scratch_tmp_env → apply_scratch_tmp_env。于是“找出闲置条目、rmtree 掉”这件事被内联到了其它一切开始之前。PR 作者记录了一个真实案例:某台机器上 hermes --worktree 卡了 13 秒,原因是它在删一个 34 GB 的临时条目。没有东西坏掉,命令只是在等一个 rmtree。
修法保留策略、只挪位置:清理那一趟仍然是每进程一次、最多每小时一次,但改由一个 detached 子进程去做(python -I,命令退出后重新挂到用户的 session manager 下),所以命令本身立刻返回。用真实进程、假的 HOME/HERMES_HOME、两棵 git archive 出来的树实测,在存在一个 60 万文件闲置条目的情况下,hermes sessions list 从 6.74 s 降到 0.35 s。
0.35 s 不是妥协出来的数字:没有该条目的对照组同样是 0.35 s,而那个条目是在启动后 5.8 s 才被 detached 子进程删掉的。换成一共有 4 个闲置条目(每个 1.5 万文件)、进程起来就退出,则从 0.64 s 降到 0.05 s,进程退出时 4 个条目全都还在,子进程随后才把它们清完。
没变的是保护你的那部分。你自己搬进来、或者用 tar 解出来的老 mtime 文件仍然保留;闲置条目里跑着没人认领的 sleep,仍然会先被 TERM 再删目录;启动 Hermes 的那个 shell(连同它的父进程)所在目录仍然保留;Hermes 自己跟踪的后台进程、gateway、CLI 会话永不停止;如果 psutil 导入不了,则一律不删——fail closed,日志里留一句 process check failed …, nothing deleted this pass。
策略本身也值得知道,它能解释这个目录为什么有时看起来“没人管”:条目要闲置 24 小时才删,最后一天里任何位置有过写入就保留;硬链接不算写入——这是刻意的,否则 git clone --local 与源仓库共享 pack 文件时,源仓库一活跃,这份 clone 就永远留着。每次删除、停止、保留都会写进 ~/.hermes/logs/scratch-prune.log。你无权读写的条目(常见是容器以 root 写进 bind mount 的输出)不会被盲目删除,只给一条提示和一句建议的 sudo rm -rf '<path>'。这些临时文件到底落在哪、环境变量怎么串起来,可以看终端临时目录那篇。
第二笔:每条命令都跑一遍完整的 git 版本查询
如果你是从 git checkout 里跑的 Hermes,每条命令都快了大约 1 秒:hermes sessions list 从 1.453 s 到 0.435 s(两个版本交错各跑 6 次的均值),每条命令的 git 子进程从 15 个降到 2 个。
两个根因,其实是同一个 bug 换了件衣服。它们各自在启动路径上跑了一遍完整的版本查询——7 次 git 调用,其中 git tag --merged HEAD 在大仓库里单次就要约 0.35 s。
第一个是导入时就急着算。import hermes_cli.config 会列出所有 provider 插件,其中几个在模块层就构造 HermesAgent/<release> 这样的 User-Agent:Fireworks、GMI、xAI、router、Kimi、OpenCode。为了把这个 release 填进字符串,它们在导入时就去 git 里解析版本;auth_constants、models、model_catalog、auxiliary_client、gemini_native_adapter、web_server_messaging、Slack、Yuanbao、Perplexity 也做了一样的事。一次 config 导入,一堆 git 子进程,而你的命令连参数都还没读。配置层导入成本这件事,配置缓存那篇讲得更细,这里是同一个病在另一个器官上。
第二个是“为了比一个字符串花了不该花的钱”。启动时那条“有待重启的更新”提示会调 _current_checkout_sha(),它走 get_code_identity(refresh=True)——清掉缓存再跑一遍完整查询,每次启动都跑,哪怕根本没有更新回执要比。
修法由三小块组成。providers.base.LazyHeaders 是一个 dict 子类:导入时只把键存住,第一次读值时才执行可调用值,于是带 release 的 User-Agent 只在真正构造请求时才算出来;同时 .copy()、|、update、json.dumps、pickle、isinstance(x, dict) 这一整套行为看到的仍然是真 dict。version_info.hermes_user_agent(product) 在构造请求时计算。version_info.read_checkout_sha() 用一次 git 调用拿到与原来相同的 SHA。hermes --version、User-Agent、归因头的内容都没有变——这是一次调度上的调整,不是重设计。
第三笔:commit-graph 两个月没更新过
git tag --merged HEAD 在启动时和 hermes update 时都会用到。在真实的安装 checkout 上,它从 0.39 s 降到 0.05 s。
三件事同时出了问题。partial clone 下 git 自己的 commit-graph 写入被有意关掉了(上游 #127711);Hermes 的 pack 维护流程也从没写过 graph;再加上一个被 kill 的 git 留下的 objects/info/commit-graph.lock 在那里躺了两个月,因为 gitlock 的陈旧锁清扫没有覆盖它。于是每次 tag 查询都在做最贵的那件事,而且有个锁文件保证它会一直这么做下去。
修法是:每次 hermes update 之后、以及每次 hermes -w 启动时,在后台刷新 commit-graph(git commit-graph write --reachable --split --no-changed-paths);同一趟顺手清掉被 kill 的 git 留下的 commit-graph / multi-pack-index 锁和 tmp_graph_* 临时文件;退出时先给进程树 SIGTERM,5 秒宽限之后才 SIGKILL(其它调用者的默认行为不变),这样“被 kill 的 git”从一开始就少留残骸。
实测结果:_run_post_update_maintenance 这一阶段从 2.82 s 降到 2.01 s,阶段返回后 3 秒内写出 split graph,commit-graph verify 通过;hermes -w 的后台维护从“什么都不做”变成 3.47 s 写出 graph,并清掉了那个两个月的陈旧锁。既然这项维护现在挂在 hermes update 上,那条命令的其它行为可以看平滑升级那篇。
三笔账放在一起看
| 你在做什么 | 修复前 | 修复后 |
|---|---|---|
hermes sessions list,存在一个 60 万文件的闲置条目 |
6.74 s | 0.35 s |
| 4 个闲置条目(各 1.5 万文件),进程起来就退出 | 0.64 s | 0.05 s |
从 checkout 跑版本查询(hermes sessions list) |
1.453 s | 0.435 s |
| 每条命令的 git 子进程数 | 15 | 2 |
真实安装 checkout 上的 git tag --merged HEAD |
0.39 s | 0.05 s |
_run_post_update_maintenance(含真实 tag 拉取) |
2.82 s | 2.01 s |
这三笔的共同点是:没有一件事本身是错的,也没有一件事是多余的。它们只是待错了地方。
顺手修掉的第四个:时钟跳变不再踢掉 gateway
第四个 PR 改起来小得多,但它制造的是那种“查不出原因”的 bug。系统时钟跳变之后,临时目录清理那一趟会把正在运行的 gateway 误判成“遗弃”对象,然后照章处理。现在不会了。如果你有过这种经历——笔记本唤醒或者 NTP 校时之后,某个跑了很久的后台服务莫名其妙消失了——这算是一个说得通的解释,而且它跟前面三笔是一批修的。
你现在能做什么
先把状态说清楚:四个 PR 都是 2026-10-26 合并的,晚于 v0.22.5(2026-10-23 发布)。它们不在任何正式版本里——不是 v0.22.5,也不是你今天能装到的任何一个版本,只存在于 main 上。想现在吃到这个提速就跟随 main,否则等下一个版本。
如果你打算在一段时间内留在某个 release 上,这些数字仍然有用。它们可以当基准线:如果单条 hermes sessions list 要六七秒,原因几乎肯定是 ~/.hermes/cache/scratch 下有个很大的闲置条目,先看看里面是什么,再判断是不是 Hermes 本身变慢了。~/.hermes/logs/scratch-prune.log 记录了每一次删除、停止和保留,“是不是有什么东西吃掉了我的临时文件”因此有答案可查。如果你从 ~/.hermes/hermes-agent 这个 checkout 里跑,一个遗留的 objects/info/commit-graph.lock 就是实打实的减速,而 v0.22.5 上没有任何东西会替你清理它。另外,如果你自己 export 了 TMPDIR,注意 Hermes 只在这三个变量未设置时才改写——你自己的临时文件压根不在 scratch 策略的管辖范围内。
新装一套环境的话,安装指南同时覆盖 release 和 checkout 两种布局,而这里的区别很重要:版本查询和 commit-graph 这两笔收益只对 checkout 安装生效,临时目录清理那一笔则对所有人生效。