Dein Gateway verstummt nach ein paar hundert Turns — zwei Wrapper stapelten sich auf stdout
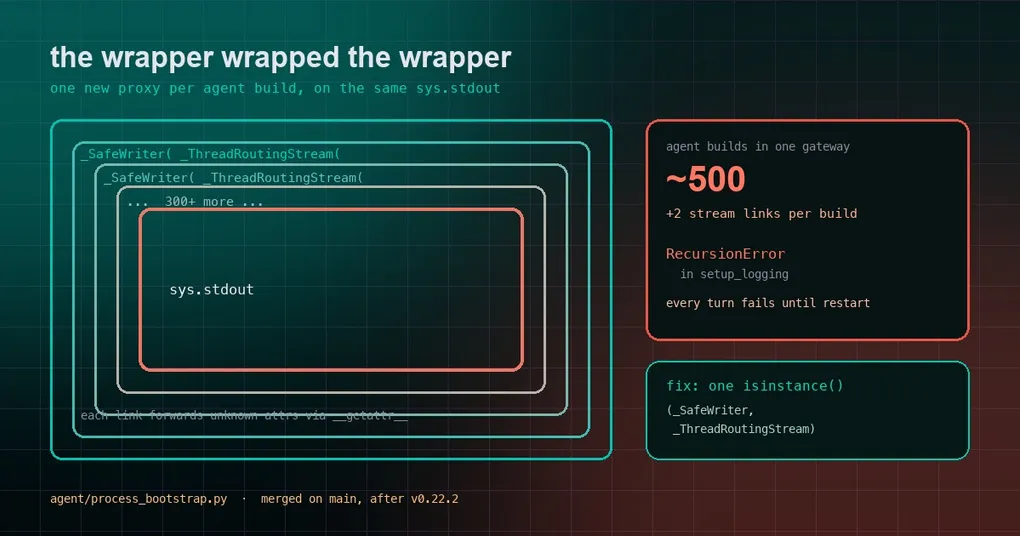
Dein Bot antwortet den ganzen Tag in einem gut besuchten Chat. Dann, irgendwo jenseits der 500. Nachricht, hört er auf. Der Prozess lebt, der Port lauscht, hermes gateway status meldet alles bestens — aber jede neue Nachricht scheitert. Du öffnest das Log und findest eine Zeile, die mit Chatten nichts zu tun hat: RecursionError: maximum recursion depth exceeded, und der Traceback endet in setup_logging. Gateway neu starten, und es läuft wieder. Morgen zur selben Zeit derselbe Ausfall.
Das ist kein Memory-Leak, kein wackeliges Modell und nichts, was du falsch konfiguriert hättest. Es ist Pythons Ausgabestream: zwei Proxy-Schichten, die sich übereinanderlegen, bis die Kette nach ein paar hundert Runden tief genug ist, um das Rekursionslimit des Interpreters zu reißen.
Das Symptom: nicht langsam, sondern kaputt
Das lohnt sich festzunageln, bevor du suchen gehst — denn die Symptome zeigen auf das falsche Subsystem:
| Was du siehst | Was wirklich passiert |
|---|---|
Gateway-Prozess lebt, status meldet running |
Dem Prozess fehlt nichts; jeder Agent-Build wirft |
RecursionError in setup_logging, immer wieder |
Ein Attribut-Lookup läuft eine sehr lange Proxy-Kette ab |
| Neustart hilft sofort | Die Kette wurde zurückgesetzt — und wächst wieder |
| Längere Uptime macht es schlimmer | Es skaliert mit Turns/Agent-Builds, nicht mit Zeit oder Last |
Das entscheidende Wort ist long-running. Startest du dein Gateway täglich neu oder nutzt Hermes nur ab und zu aus dem Terminal, wirst du das vermutlich nie sehen. Betreibst du es als Dienst mit Telegram, Discord, Slack, Cron-Jobs und aktiviertem Background-Review, ist es eine lange Zündschnur.
Was auf diesem Stream liegt
Zwei Entwürfe, jeder für sich vernünftig.
Der erste ist _install_safe_stdio(). Bei jedem Agent-Build werden sys.stdout und sys.stderr in einen _SafeWriter gepackt, damit eine gebrochene Pipe oder ein Encoding-Fehler beim Ausgeben von Fortschritt nicht den ganzen Agent mitreißt. Weil das bei jedem Build läuft, muss es „schon umwickelt“ erkennen — und die alte Prüfung war eng: ist der Stream bereits ein _SafeWriter, überspringen.
Der zweite ist der Thread-Routing-Proxy _ThreadRoutingStream, den das Background-Review installiert, wenn es die Ausgabe eine Weile stummschalten muss. Wenn thread_scoped_silence() fertig ist, setzt es wieder einen Router ein.
Die beiden Prüfungen sind sich uneins:
_install_safe_stdio()kannte nur_SafeWriter. Sah es oben einen_ThreadRoutingStream, entschied es „nicht meins“ und legte einen weiteren_SafeWriterdarüber.thread_scoped_silence()sah danach keinen Router mehr und installierte einen frischen über diesem Wrapper.
So fügte jeder Zyklus aus „Agent bauen, Scope stummschalten“ zwei Glieder an jeden Stream:
_ThreadRoutingStream( _SafeWriter( _ThreadRoutingStream( _SafeWriter( ... ) ) ) )Jedes Glied reicht unbekannte Attribute per __getattr__ an das nächste weiter. Ein Sprung ist nichts. Bei hunderten Gliedern muss eine einzelne Attributabfrage aber die ganze Kette durchlaufen — und nach ungefähr 500 Zyklen trifft die line_buffering-Abfrage in setup_logging auf das Rekursionslimit und wirft RecursionError. Ab dann scheitert jeder Turn, bis das Gateway neu startet und die Kette verworfen wird.
Ein Detail, das man leicht unterschätzt: Der Auslöser sind nicht „viele Nachrichten“, sondern Agent-Builds. Ein Turn, der Subagents startet, Background-Review laufen lässt und mehrere Tool-Iterationen durchläuft, baut weit mehr Agenten, als die Nachrichtenzahl vermuten lässt.
Der Fix: eine einzige isinstance-Prüfung
Die gemergte Änderung ist winzig und liegt in agent/process_bootstrap.py:
def _install_safe_stdio() -> None:
    """Wrap stdout/stderr so best-effort console output cannot crash the agent."""
    for stream_name in ("stdout", "stderr"):
        stream = getattr(sys, stream_name, None)
        # Der Routing-Proxy schluckt diese Fehler bereits; ihn zu umwickeln stapelt pro Build einen neuen Proxy.
        if stream is not None and not isinstance(stream, (_SafeWriter, _ThreadRoutingStream)):
            setattr(sys, stream_name, _SafeWriter(stream))
Die Prüfung erkennt jetzt die ganze Familie statt nur eines Mitglieds. Der Router fängt die beiden Fehler, für die es _SafeWriter überhaupt gibt (OSError und ValueError, behandelt im eigenen Weiterleitungspfad und in isatty()), bereits ab — eine zweite Schutzschicht braucht er nicht.
Es gibt keinen Cleanup-Durchlauf und kein Abspracheprotokoll zwischen den beiden Installern: Typ einmal prüfen, und die Kette bleibt für immer flach. Das gilt für jede Gateway-Oberfläche — Telegram, Discord, Slack, Desktop, den API-Server —, weil alle denselben Agent-Bootstrap durchlaufen.
Was du jetzt tun solltest
1. Bestätigen, dass es dieser Bug ist. Nicht raten, zählen:
hermes logs errors --since 7d | grep -c RecursionError
hermes logs errors --since 2d --level ERROR
Ein Zähler, der über Tage wächst, beim Neustart auf null springt und dann wieder klettert, ist die Signatur. Dann schau, wie viele Gateways du überhaupt betreibst:
hermes gateway status
hermes gateway list
2. Den Dienst zurückholen. Ein Neustart unterbricht laufende Turns, ist aber die einzige sofortige Rettung:
hermes gateway restart
# mehrere Profile parallel
hermes gateway restart --all
3. Wissen, wann der Fix ankommt. Die Änderung wurde am 19. Oktober 2026 nach main gemergt — nachdem v0.22.2 am 15. Oktober erschienen ist —, also enthält das aktuelle Release sie nicht. Dein nächstes hermes update auf einen Build mit diesem Commit nimmt sie mit; starte das Gateway danach neu. Läufst du aus einem Source-Checkout, der main folgt, pullen und neu starten.
4. Behandle ein Gateway als langfristigen Dienst. Dieser Bug ist kumulativ, nicht lastgetrieben: Er tritt in Prozessen auf, die Wochen laufen und zehntausende Agenten bauen. Gib dem Dienst eine Supervision, die ihn bei Fehlern neu startet (systemd Restart=on-failure, launchd KeepAlive), damit eine solche Bug-Klasse dich nicht über Nacht stumm zurücklässt. Hermes bringt eigene Watchdog- und Heartbeat-Mechanik mit, die sich gut damit kombinieren lässt — siehe Gateway-Loop-Watchdog-Guide und Erkennung stiller Disconnects per Heartbeat.
Warum man sich diesen Fall merken sollte
Zwei Lehren, keine davon Hermes-spezifisch.
Wrapper auf einem Hot Path müssen über die ganze Familie idempotent sein, nicht über ein einzelnes Mitglied. Jede Logik „umwickeln, falls nicht umwickelt“ mit enger Typprüfung wird still zu „bei jedem Aufruf umwickeln“. Unit-Tests fangen das nicht, denn ein Test baut einen Agenten; nur ein lange laufender Prozess legt es offen, und lange laufende Prozesse sind das Schwierigste zum Reproduzieren.
Fehlermeldungen lügen über ihre Schicht. RecursionError liest sich wie außer Kontrolle geratene Rekursion in der Fachlogik, kam hier aber aus einer Attribut-Weiterleitungskette in der I/O-Schicht. Wenn die Spitze des Tracebacks nichts damit zu tun hat, was der Code eigentlich tut, verdächtige angesammelten Infrastruktur-Zustand, bevor du die Fachlogik liest.
Wenn du Gateway-Verhalten debuggst, prüfe deine Befehle zuerst gegen die hermes-gateway-Referenz und nutze auf der geplanten Seite den cron doctor — Cron-Jobs sind meist das Erste, was sich beschwert, wenn ein Gateway ungesund wird.
Zusammenfassung
- Symptom: Ein lange laufendes Gateway scheitert nach ein paar hundert Builds bei jedem Turn,
RecursionErroraussetup_logging, Neustart räumt es auf. - Ursache:
_install_safe_stdio()undthread_scoped_silence()erkannten den Proxy des jeweils anderen nicht, also fügte jeder Zyklus zwei Glieder pro Stream hinzu; nach etwa 500 Zyklen überschreitet eine Attributabfrage das Rekursionslimit. - Fix: eine
isinstance-Prüfung, die die ganze Proxy-Familie abdeckt. Nachmaingemergt, nach v0.22.2. - Heute: mit
hermes logs errorsbestätigen, mithermes gateway restartretten, auf das nächste Update warten — und den Dienst überwachen.