网关跑到第 500 轮突然不说话了:两个「包装层」在同一个输出流上套娃
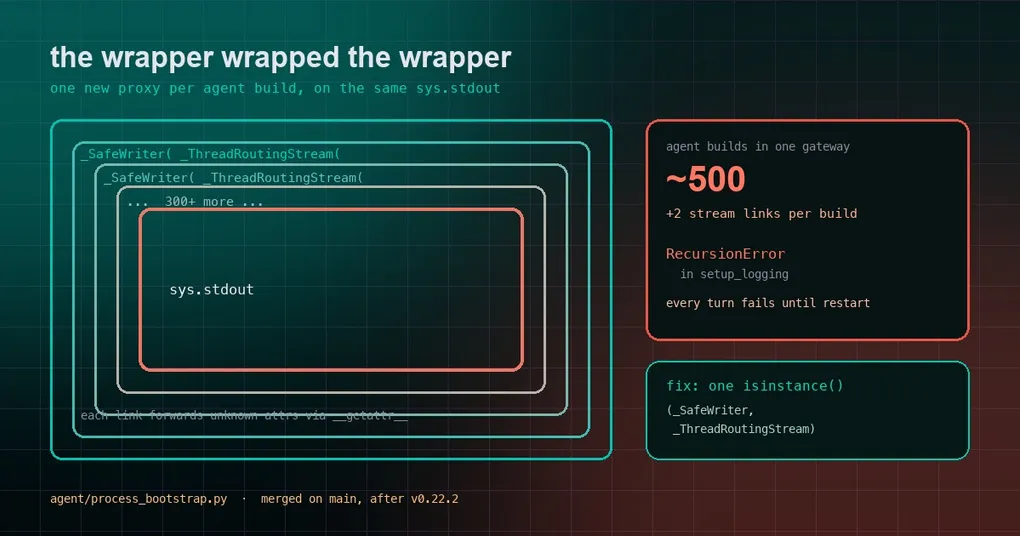
周五晚上,你的机器人一整天都在群里正常回话。到了第 500 多条消息,它突然不吭声了——进程还在,端口还在监听,hermes gateway status 显示一切正常,但每条新消息都失败。你打开日志,只有一行看起来和聊天毫无关系的错误:RecursionError: maximum recursion depth exceeded,栈顶停在 setup_logging。重启网关,一切恢复正常;第二天同一时间,它又犯了同样的病。
这不是内存泄漏,也不是模型抽风,甚至不是你的配置有问题。问题出在 Python 的输出流上:有两层代理被反复叠在一起,几百轮之后,这条链长得足以撑爆递归上限。
症状:不是变慢,而是每一轮都失败
先把现象说清楚,方便你对照自己的日志:
| 你看到的 | 实际情况 |
|---|---|
gateway 进程活着,status 显示 running |
进程没死,是每一轮构建 agent 时炸的 |
日志里反复出现 RecursionError,位置在 setup_logging |
输出链太深,取一个属性就递归爆栈 |
| 重启后立刻恢复 | 链被重置了,但下一次运行会重新变长 |
| 跑得越久越容易出问题 | 它跟“轮数”相关,而不是跟时间或负载相关 |
关键词是长跑。如果你每天重启一次网关,或者只是偶尔在终端里用用,大概一辈子碰不到这个问题;如果你把 gateway 当常驻服务,接了 Telegram、Discord、Slack,还开着定时任务和后台评审,那它就是一颗定时炸弹。
现场:同一个 stdout 上叠了两层代理
要理解这个 bug,只需要理解两个原本都很合理的设计。
第一层叫 _install_safe_stdio()。它的职责很朴素:agent 在构建时,把 sys.stdout 和 sys.stderr 包一层保护壳 _SafeWriter,这样当输出流遇到断管、编码错误这类问题时,不会把整个 agent 一起带走。它每次构建都会执行一次,所以它必须能认出“已经包过了”——旧代码的判据是:如果当前流已经是 _SafeWriter,就跳过。
第二层来自后台评审(background review)。它会在需要“静默”某段输出的时候安装一个线程路由代理 _ThreadRoutingStream,把输出按线程分流;thread_scoped_silence() 收尾时,又会在这条流上面装一个新的路由器。
问题就出在两个判据对不上:
_install_safe_stdio()只认_SafeWriter。当它看到_ThreadRoutingStream时,认为“这不是我包的类型”,于是又包了一层_SafeWriter。thread_scoped_silence()随后看不到路由器了(最上面是_SafeWriter),于是又装一个新的路由器。
于是每一次“构建 agent + 静默”的循环,都在 sys.stdout 和 sys.stderr 上各加两节:
_ThreadRoutingStream( _SafeWriter( _ThreadRoutingStream( _SafeWriter( ... ) ) ) )每节代理都用 __getattr__ 把不认识的属性转发给下一层。平时这没问题,转发一次就走一层。但当链上有几百节时,任何一次属性探测都要穿过整条链——大约 500 轮之后,setup_logging 里对 line_buffering 的探测就走到了递归上限,直接抛 RecursionError。之后每一轮都失败,直到网关重启、整条链被清空。
一个有价值的细节:触发条件不是“消息很多”,而是“agent 被构建了很多次”。一个 turn 里如果调用了子代理、后台评审、多个工具轮次,构建次数涨得比你想象的快得多。
修复:一行 isinstance
合入的修复非常小,位置在 agent/process_bootstrap.py 的 _install_safe_stdio():
def _install_safe_stdio() -> None:
    """Wrap stdout/stderr so best-effort console output cannot crash the agent."""
    for stream_name in ("stdout", "stderr"):
        stream = getattr(sys, stream_name, None)
        # The routing proxy already absorbs these errors; wrapping it stacks a new proxy per build.
        if stream is not None and not isinstance(stream, (_SafeWriter, _ThreadRoutingStream)):
            setattr(sys, stream_name, _SafeWriter(stream))
判据从“是不是 _SafeWriter“改成”是不是这一族代理中的任何一个“。路由器本身已经吞掉了 _SafeWriter 要防的那两类错误(OSError 和 ValueError,在它自己的转发路径和 isatty() 里),所以不再需要额外包一层保护壳。
这个修复的好处是它不需要给两条路径建立约定,也不需要在构建时做任何清理:只要判断一次类型,链就永远是平的。对所有的 gateway 形态(Telegram、Discord、Slack、Desktop 直连、API server)都一样生效,因为它们最终都会走到同一个 agent 构建入口。
你现在能做什么
一、先确认是不是同一个问题。 别猜,看日志:
hermes logs errors --since 7d | grep -c RecursionError
hermes logs errors --since 2d --level ERROR
如果计数在几天里稳步增长,而且每次重启后归零、跑一阵又涨回来,基本就是这个 bug。再看一眼进程状态和你有几个 profile 在跑:
hermes gateway status
hermes gateway list
二、先恢复服务。 重启会打断正在跑的 turn,但这是目前唯一能立刻恢复的手段:
hermes gateway restart
# 多 profile 并排跑的时候,一次重启全部
hermes gateway restart --all
三、什么时候能拿到修复。 这个修复在 2026 年 10 月 19 日合入主分支,晚于 v0.22.2(10 月 15 日发布),所以当前 release 里还没有它。等你下次 hermes update 到包含该提交的版本后,重启网关即可生效;如果你是从源码跑 main 分支的安装,拉取最新代码并重启就行了。
四、别把长跑服务当短跑进程用。 这个问题暴露的其实是一个运维现实:常驻网关可能连续跑几周、构建几万个 agent,它遇到的是“累积型”缺陷,而不是“负载型”缺陷。给服务配一个失败自动重启的监督策略(systemd 的 Restart=on-failure、launchd 的 KeepAlive),能让你在遇到这一类问题时至少不至于整夜失联。顺带一提,网关自己也有 watchdog 与心跳机制,可以配合着看:网关 loop watchdog 指南 和 静默断连的心跳检测。
为什么这类 bug 值得记住
它教给我们两件事,都和 Hermes 无关,和写长期运行的服务有关。
第一,热路径上的包装必须是幂等的,而且要认“一整族”,不能只认“一种”。 任何“如果没有就包一层”的逻辑,判据写窄了就会变成“每次调用都包一层”。这类 bug 不会在单测里暴露——单测只构建一次 agent;它只在长跑进程里暴露,而长跑进程恰恰最难复现。
第二,错误信息会骗人。 RecursionError 让人第一反应是“业务代码里是不是有递归”,实际上它来自 I/O 层的一条属性转发链。看到栈顶位置和业务逻辑无关时,先怀疑基础设施的累积状态,而不是先去读业务代码。
如果你在排查网关相关的问题,可以先从 hermes gateway 命令参考 对一遍你手上的命令,再用 cron doctor 检查定时任务这条链路——网关出问题时,定时任务通常是最先喊疼的那一批。
小结
- 症状:长跑网关在几百轮之后每轮失败,
RecursionError出现在setup_logging,重启即恢复。 - 原因:
_install_safe_stdio()与thread_scoped_silence()互相不认对方的代理,每次构建各加一层,链深约 500 轮后爆栈。 - 修复:一行
isinstance,让构建时的包装认得整族代理;已合入主分支,晚于 v0.22.2。 - 现在做:
hermes logs errors确认、hermes gateway restart恢复、等下一次更新,并给常驻服务配好自动重启。