Ein Update setzte drei Monate an Sitzungen auf Juli zurück — weil eine gesperrte Datei als beschädigt galt
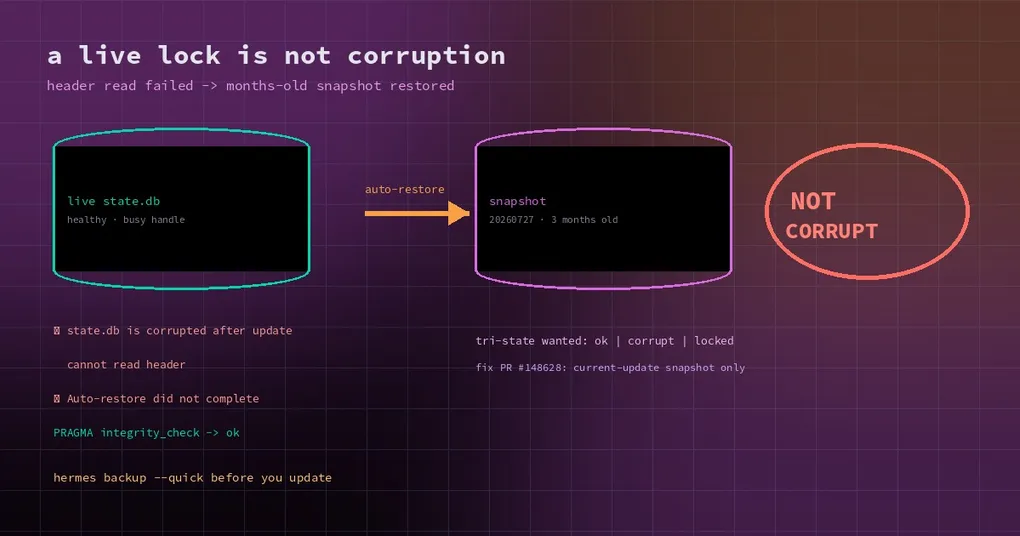
Am Mittwochmorgen öffnest du Hermes, um die Arbeit von gestern fortzusetzen. Die letzten Sitzungen sind weg; die Liste endet im Juli. Drei Monate an Gesprächen, Cron-Verlauf und Nachrichten fehlen. Im Update-Log stehen drei Zeilen: state.db is corrupted after update, cannot read header, Auto-restore did not complete.
Dein erster Gedanke ist, dass die Datenbank kaputt ist. Der zweite, ob diese drei Monate noch zu retten sind. Die Wahrheit ist seltsamer als beides: Die Datenbank war nie beschädigt. Die Update-Pipeline las „diese Datei wird gerade benutzt“ als „diese Datei ist defekt“, überschrieb sie mit einem Snapshot von vor drei Monaten und meldete anschließend einen Fehler für ein Überschreiben, das bereits erfolgreich war.
Die Chronologie eines Updates, das nichts tat
Der Incident-Bericht zitiert das Log wörtlich — ein routinemäßiges Windows-11-Update von v0.22.5 auf v0.22.6 im Standard-profile, state.db mit rund 1,19 GB:
22094  build ends — code no-op: apply/snapshot SKIPPED (so NO fresh snapshot was taken)
22098  ⚠ state.db is corrupted after update (default home): cannot read header
22100  ✗ Auto-restore did not complete
Diese drei Zeilen sind die ganze Geschichte. Das Update enthielt keine echte Codeänderung, also wurde die Snapshot-Phase übersprungen — es entstand kein neuer Wiederherstellungspunkt. Die Integritätsprüfung las dann während des Pausenfensters den Header der state.db, scheiterte und erklärte sie für beschädigt. Die Wiederherstellungslogik fand genau einen Snapshot auf der Platte, state-snapshots/20260718-132211-pre-update, dreieinhalb Monate alt. Er war gültig, also wurde damit die laufende Datenbank überschrieben. Das Überschreiben funktionierte (der runtime_epoch nach der Wiederherstellung war (44, 'offline-restore'), der Stempel, den dieser Pfad schreibt), aber die Prüfung danach wiederholte dasselbe Header-Lesen, scheiterte erneut, und der Lauf endete mit „Auto-Wiederherstellung nicht abgeschlossen“.
Ein zweiter Melder traf es 24 Stunden später mit einer größeren Installation: 531 Sitzungen und rund 81.500 Nachrichten wurden durch den Stand vom 27. Juli ersetzt.
Drei Defekte, gestapelt
Jeder einzelne davon wäre zu überleben. Zusammen vernichten sie Daten.
1. „In Benutzung“ und „beschädigt“ waren dieselbe Antwort
In hermes_cli/sqlite_safe_read.py gibt read_header_bytes_preopen() in zwei Fällen None zurück: im lesenden Prozess existiert eine aktive registrierte Verbindung zu dieser Datenbank, oder das direkte Lesen des Headers wirft irgendeinen OSError. Unter Windows ist eine Freigabeverletzung, weil ein anderer Prozess die Datei hält, genau dieser OSError.
backup.py::verify_sqlite_integrity() bildet None direkt auf einen cannot read header-Fehler ab, und der Aufrufer kann nicht erkennen, warum. Der Kommentar der Funktion selbst sagt, die Prüfung sei für Offline-Snapshots und Backup-Artefakte gedacht — doch der Update-Guard richtet sie auf das laufende profile-Verzeichnis, in einem Fenster, in dem das gateway nur pausiert und nicht beendet ist.
Liest du dieselbe Datei über eine Nur-Lese-Verbindung oder mit PRAGMA quick_check, ist alles in Ordnung. Im Nachhinein lieferten auf derselben Maschine und bei derselben Datei PRAGMA integrity_check ein ok und verify_sqlite_integrity ein gültig. Das ist kein Glück, sondern eine Fehlklassifikation.
2. Kein Snapshot bei einem Update ohne Änderungen
Die Wiederherstellungslogik setzt voraus, dass immer ein frisch erstellter Snapshot existiert. Wendet das Update keine Codeänderungen an, wird die Snapshot-Phase komplett übersprungen, und das einzige Wiederherstellungsziel ist das älteste Objekt auf der Platte. „Auto-Wiederherstellung“ wird damit selbst zum Datenverlust-Ereignis, und nichts prüft, wie viel älter dieser Snapshot ist als die Daten, die er gleich ersetzt.
3. Eine erfolgreiche Wiederherstellung als Fehler gemeldet
Die Wiederherstellung lief, und die Datenbank wurde tatsächlich gegen den alten Snapshot getauscht. Die Prüfung danach nutzte dasselbe Lesen, das scheitert, also gab der Lauf Auto-restore did not complete aus. Öffne die Datenbank am nächsten Tag, und du siehst eine gesunde, aber zurückgerollte Datei plus eine Logzeile, die in beide Richtungen falsch ist: Sie war nicht beschädigt, und die Wiederherstellung hat stattgefunden.
Deine Daten stecken wahrscheinlich noch im Snapshot — hör zuerst auf zu schreiben
Drei praktische Prüfungen:
- Hör auf, dieses profile zu benutzen. Jeder neue Schreibvorgang in die zurückgerollte Datenbank macht es schwerer, alte von neuen Daten zu unterscheiden.
- Schau ins Snapshot-Verzeichnis. Jeder Eintrag unter
state-snapshots/trägt einen Zeitstempel, der wiederhergestellte ist also offensichtlich. Die drei Monate alte Datenbank liegt noch dort, und sie ist kein Müll. - Prüfe die beschuldigte Datei erneut. Existiert die Datenbank von vor dem Update noch irgendwo, öffne sie im Nur-Lese-Modus und führe
PRAGMA integrity_checkaus. Sehr wahrscheinlich kommtokzurück — und das sagt dir, ob du eine falsch beurteilte, gesunde Datei in der Hand hast oder eine wirklich beschädigte.
War die Beurteilung falsch, ist das Zurücktauschen der alten Datenbank meist verlässlicher als das Patchen der aktuellen, und der Export der Sitzungen ist in jedem Fall das Sicherheitsnetz:
hermes backup --quick                  # a critical-state snapshot before updating
hermes sessions export backup.jsonl
Wo der Fix steht
Zwei Stränge sind in Bewegung:
- #148628 (PR, offen): Die automatische Wiederherstellung darf nur den Snapshot nutzen, den das aktuelle Update für dieses profile aufgezeichnet hat. Ist er nicht vorhanden, fehlt ihm die Datenbank oder scheitert er an der Validierung, lässt der Guard die laufende Datenbank unangetastet. Das entfernt auch das falsche Label „nicht abgeschlossen“, weil es keinen veralteten Snapshot gibt, auf den man zurückfallen könnte.
- #128350 (separat verfolgt): den SQLite-Lock-Zustand klassifizieren — das Header-Urteil dreiwertig machen (
ok/ beschädigt / vorübergehend nicht lesbar) und bei „nicht lesbar“ niemals wiederherstellen.
Keiner der beiden ist im Tag v0.22.7, der stabile Build, den du heute installierst, verhält sich also noch wie bisher. Das Risikofenster ist offen.
Wie du Updates ab jetzt fährst
Das ist ein Lehrbuchfall von Prüfcode, der auf ein Ziel gerichtet wird, für das er nie entworfen wurde. Vier Gewohnheiten decken das ab:
- Führe
hermes backup --quickvor dem Update aus, besonders unter Windows und bei Stores mit mehreren Gigabyte. Es dauert Sekunden und ist der einzige Schritt, der dich hier wirklich rettet. - Prüfe die Daten unter
state-snapshots/. Ist der neueste Snapshot einen Monat älter als deine Daten, hast du keinen Wiederherstellungspunkt. - Lies „Wiederherstellung erfolgreich“ nicht als „Daten sind sicher“. Eine Wiederherstellung ist ein Rollback, keine Reparatur; die erste Aufgabe danach ist herauszufinden, was verloren ging, nicht weiterzuarbeiten.
- Behandle
cannot read headerzuerst als Lock. Unter Windows ist es normal, dass ein anderer Prozess die Datei hält, nicht die Ausnahme.
Die Kurzfassung
Die Datenbank war in Ordnung. Das Urteil, sie sei kaputt, war es nicht. Gesperrt, beschädigt und vorübergehend nicht lesbar sind drei Zustände, die drei verschiedene Reaktionen brauchen; sie zu einem zu verschmelzen kostet drei Monate an Sitzungen. Der Fix ist unterwegs, aber der Schutz, den du heute hast, ist der alte: Sichere vor dem Update.
Weiterlesen: ein beschädigtes state.db selbst heilen, Sitzungen exportieren und sichern, eine sorgfältige Upgrade-Routine, was sonst im Fenster von v0.22.7 steckt.