Une mise à jour a ramené trois mois de sessions à juillet — parce qu'un fichier verrouillé a été déclaré corrompu
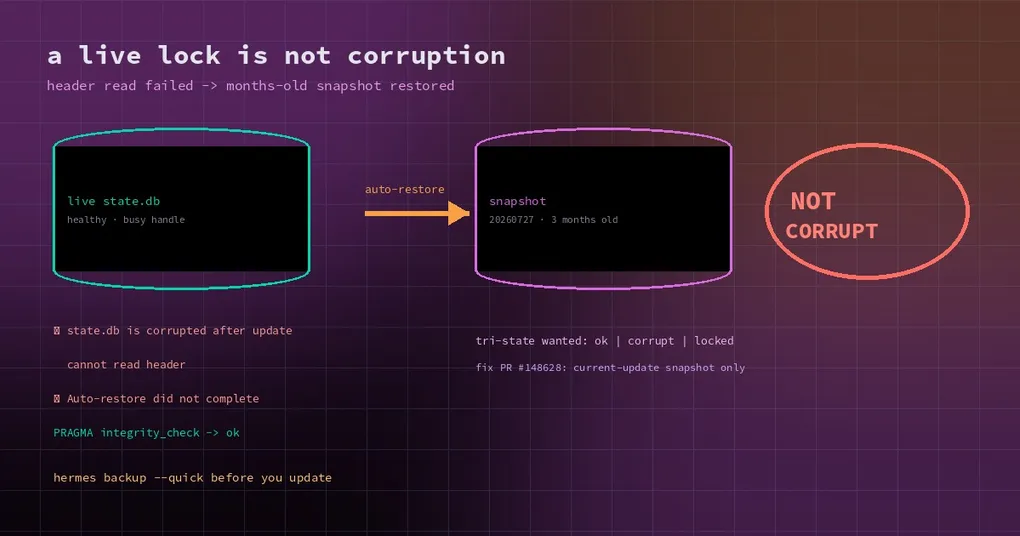
Le mercredi matin, vous ouvrez Hermes pour reprendre le travail de la veille. Les sessions récentes ont disparu ; la liste s’arrête en juillet. Trois mois de conversations, d’historique cron et de messages ne sont plus là. Le journal de mise à jour affiche trois lignes : state.db is corrupted after update, cannot read header, Auto-restore did not complete.
Votre premier réflexe est de penser que la base de données a lâché. Le second, de vous demander si ces trois mois sont récupérables. La vérité est plus étrange que ces deux hypothèses : la base de données n’a jamais été corrompue. Le pipeline de mise à jour a lu « ce fichier est en cours d’utilisation » comme « ce fichier est endommagé », l’a écrasée avec un snapshot de trois mois plus tôt, puis a signalé un échec pour un écrasement qui avait déjà réussi.
La chronologie d’une mise à jour qui ne fait rien
Le rapport d’incident cite le journal mot pour mot — une mise à jour Windows 11 de routine, de v0.22.5 à v0.22.6, profile par défaut, state.db d’environ 1,19 GB :
22094  build ends — code no-op: apply/snapshot SKIPPED (so NO fresh snapshot was taken)
22098  ⚠ state.db is corrupted after update (default home): cannot read header
22100  ✗ Auto-restore did not complete
Ces trois lignes sont toute l’histoire. La mise à jour n’apportait aucun changement de code réel, donc l’étape de snapshot a été sautée — aucun point de restauration frais n’a été créé. Le contrôle d’intégrité a ensuite lu l’en-tête de la state.db pendant la fenêtre de pause, a échoué, et a déclaré la corruption. La logique de restauration a trouvé exactement un snapshot sur le disque, state-snapshots/20260718-132211-pre-update, vieux de trois mois et demi. Il était valide, il a donc servi à écraser la base de données en production. L’écrasement a fonctionné (le runtime_epoch après restauration valait (44, 'offline-restore'), l’estampille que ce chemin écrit), mais la vérification d’après restauration a répété la même lecture d’en-tête, échoué de nouveau, et l’exécution s’est terminée sur « la restauration automatique ne s’est pas terminée ».
Un second rapporteur a rencontré le problème 24 heures plus tard avec une installation plus grosse : 531 sessions et environ 81 500 messages remplacés par l’état du 27 juillet.
Trois défauts, empilés
Pris isolément, chacun serait survivable. Ensemble, ils détruisent des données.
1. « En cours d’utilisation » et « corrompu » étaient la même réponse
Dans hermes_cli/sqlite_safe_read.py, read_header_bytes_preopen() renvoie None dans deux cas : une connexion suivie et active vers cette base existe dans le processus lecteur, ou la lecture brute de l’en-tête lève n’importe quel OSError. Sous Windows, une violation de partage provoquée par un autre processus qui tient le fichier est exactement cet OSError.
backup.py::verify_sqlite_integrity() traduit None directement en échec cannot read header, et l’appelant ne peut pas savoir pourquoi. Le commentaire de la fonction indique lui-même que la vérification vise des snapshots hors ligne et des artefacts de backup — mais le garde-fou de mise à jour la pointe vers le répertoire de base du profile en production, dans une fenêtre où le gateway est seulement mis en pause, pas arrêté.
Lisez le même fichier via une connexion en lecture seule ou avec PRAGMA quick_check : tout va bien. Après coup, sur la même machine et le même fichier, PRAGMA integrity_check a renvoyé ok et verify_sqlite_integrity un résultat valide. Ce n’est pas de la chance, c’est une erreur de classement.
2. Aucun snapshot lors d’une mise à jour sans changement
La logique de restauration suppose qu’un snapshot fraîchement pris existe toujours. Quand la mise à jour n’applique aucun changement de code, l’étape de snapshot est entièrement sautée, et la seule cible de restauration devient l’élément le plus ancien du disque. La « restauration automatique » devient alors elle-même l’événement de perte de données, et rien ne vérifie de combien ce snapshot est plus ancien que les données qu’il s’apprête à remplacer.
3. Une restauration réussie rapportée comme un échec
La restauration s’est exécutée, et la base a bien été remplacée par l’ancien snapshot. La vérification d’après restauration a réutilisé la lecture qui échoue, donc l’exécution a affiché Auto-restore did not complete. Ouvrez la base le lendemain : vous voyez un fichier sain mais rétrogradé, plus une ligne de journal fausse dans les deux sens — il n’était pas corrompu, et la restauration a bien eu lieu.
Vos données sont probablement encore dans le snapshot — arrêtez d’écrire d’abord
Trois vérifications pratiques :
- Cessez d’utiliser ce profile. Chaque nouvelle écriture dans la base rétrogradée rend plus difficile de distinguer les anciennes données des nouvelles.
- Regardez le répertoire des snapshots. Chaque entrée sous
state-snapshots/est horodatée, celle qui a été restaurée saute donc aux yeux. La base vieille de trois mois est toujours là, et ce n’est pas un déchet. - Revérifiez le fichier accusé. Si la base d’avant mise à jour existe encore quelque part, ouvrez-la en lecture seule et lancez
PRAGMA integrity_check. Elle renverra très probablementok— ce qui vous dit si vous tenez un fichier sain mal jugé ou un fichier réellement endommagé.
Si le jugement était faux, remettre l’ancienne base en place est généralement plus fiable que de rafistoler l’actuelle, et l’export des sessions reste le filet de sécurité dans tous les cas :
hermes backup --quick                  # a critical-state snapshot before updating
hermes sessions export backup.jsonl
Où en est le correctif
Deux chantiers sont en cours :
- #148628 (PR, ouverte) : la récupération automatique ne pourra utiliser que le snapshot que la mise à jour en cours a enregistré pour ce profile. S’il est absent, si sa base manque ou s’il échoue à la validation, le garde-fou laisse la base en production intacte. Cela supprime aussi la fausse mention « ne s’est pas terminée », puisqu’il n’y a plus de snapshot périmé sur lequel retomber.
- #128350 (suivi séparément) : qualifier l’état de verrou SQLite — rendre le verdict d’en-tête trivalent (
ok/ corrompu / temporairement illisible) et ne jamais restaurer sur « illisible ».
Aucun des deux n’est dans le tag v0.22.7, donc le build stable que vous installez aujourd’hui se comporte encore à l’ancienne. La fenêtre de risque est ouverte.
Comment lancer les mises à jour désormais
C’est un cas d’école de code de vérification pointé vers une cible pour laquelle il n’a jamais été conçu. Quatre habitudes suffisent :
- Lancez
hermes backup --quickavant de mettre à jour, surtout sous Windows et sur des stores de plusieurs gigaoctets. Cela prend quelques secondes et c’est la seule étape qui vous sauve vraiment ici. - Vérifiez les dates sous
state-snapshots/. Si le snapshot le plus récent a un mois de plus que vos données, vous n’avez aucun point de restauration. - Ne lisez pas « restauration réussie » comme « données en sécurité ». Une restauration est un retour arrière, pas une réparation ; la première tâche ensuite est de savoir ce qui a été perdu, pas de continuer à travailler.
- Traitez
cannot read headerd’abord comme un verrou. Sous Windows, qu’un autre processus tienne le fichier est normal, pas exceptionnel.
La version courte
La base de données allait bien. Le jugement qui l’a dite cassée, non. Verrouillé, corrompu et temporairement illisible sont trois états qui demandent trois réponses différentes ; les confondre coûte trois mois de sessions. Le correctif arrive, mais la protection disponible aujourd’hui est l’ancienne : sauvegardez avant de mettre à jour.
Pour aller plus loin : guérir soi-même une state.db endommagée, exporter et sauvegarder ses sessions, une routine de mise à jour prudente, ce qu’il y a d’autre dans la fenêtre v0.22.7.