Dein Agent sieht nur einen Dateinamen: Hermes Speech-to-Text auf Qwen umstellen
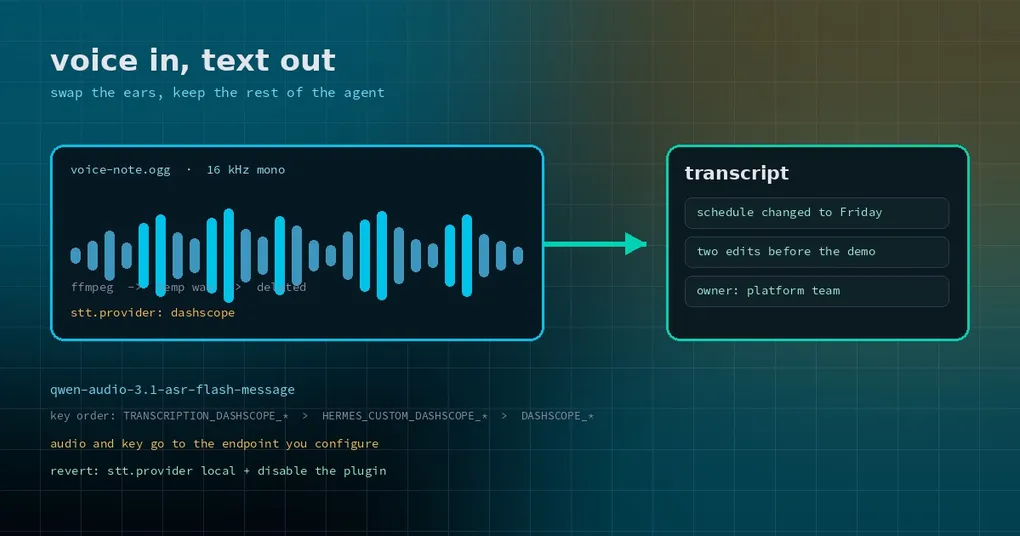
Eine Partnerin schickt dir eine zweieinhalb Minuten lange Sprachnachricht: den Zeitplan plus zwei Dinge, die sich ändern. Du leitest sie an Hermes weiter und bittest um eine Aufgabenliste. Es antwortet, dass es eine Audiodatei erhalten hat, und fragt dann, was darin stand. Aus Sicht des Agenten ist das genau das, was angekommen ist – eine .ogg.
Sprachnachrichten sind die häufigste Eingabe, die ein Agent stillschweigend fallen lässt. Hermes hat eine Speech-to-Text-Schicht mit einer lokalen Whisper-Option und mehreren Cloud-Backends, und jede hat ihren Preis: lokales Whisper frisst CPU und braucht Zeit zum Laden; Cloud-Backends wollen entweder einen Key in einem Netz, das du vielleicht nicht hast, oder eine Abrechnung pro Minute. Wenn dein Team ohnehin auf dem Qwen-/Alibaba-Stack lebt, gibt es jetzt einen dritten Weg – das Community-Plugin transcription-dashscope, das Hermes STT an Qwen-Audio-ASR auf der Qwen AI Platform (DashScope) anbindet.
Welche Schicht es ersetzt
Hermes teilt Sprache in zwei unabhängige Hälften: stt.* macht aus Klang Text, tts.* macht aus Text Klang. Standardmäßig ist stt.enabled an, und echo_transcripts ebenfalls – das Gateway transkribiert eine eingehende Sprachnachricht und schickt das Transkript als 🎙️-Nachricht zurück.
Das Backend ist austauschbar. Der Core bringt mehrere mit (lokales Whisper, Groq, OpenAI, Mistral, ElevenLabs, DeepInfra, xAI), und Plugins können weitere Provider-Namen registrieren. Dieses Plugin registriert dashscope, du änderst also nur stt.provider.
Es deckt zwei Abläufe ab: die automatische Transkription von Gateway-Sprachnachrichten und Diktat in Desktop oder der CLI mit laufendem Teiltext, wenn stt.streaming an ist. Das Standardmodell ist qwen-audio-3.1-asr-flash-message.
Drei Dinge vor der Installation
Ein API-Key der Qwen AI Platform. Ohne den läuft nichts.
ffmpeg auf der Maschine. Das Plugin nutzt es, um jede Aufnahme auf 16 kHz mono zu normalisieren – die Rate, die der Live-Transkriptions-Endpoint akzeptiert, und nicht das, was Telegram- oder WhatsApp-Sprachedateien zufällig mitbringen. Die Konvertierung schreibt eine temporäre wav-Datei und löscht sie danach.
Ein ausreichend neues Hermes. Der Katalog-Eintrag verlangt >=0.22.5. Erzwinge es nicht auf einem älteren Build; aktualisiere zuerst.
Dann in dieser Reihenfolge installieren:
hermes plugins install transcription-dashscope
hermes plugins enable transcription-dashscope
hermes gateway restart
Der Neustart ist nicht optional. Das Plugin bringt Python-Abhängigkeiten mit, und der laufende Prozess hat sie noch nicht geladen. Lässt du den Schritt weg, scheitert der nächste Befehl mit so etwas wie DashScope SDK is not importable in this process – das ist keine kaputte Installation, sondern ein Prozess, der noch nicht umgeschaltet hat.
Vier Zeilen zum Einschalten
Den Key in die .env des Profils:
DASHSCOPE_API_KEY=sk-your-keyDas Plugin liest drei Variablen, in dieser Priorität: TRANSCRIPTION_DASHSCOPE_API_KEY (plugin-spezifisch), HERMES_CUSTOM_DASHSCOPE_API_KEY (der Satz für eigene Provider), dann DASHSCOPE_API_KEY (der eingebaute Alibaba-Provider). Jede einzelne davon genügt, ein bestehendes Alibaba-Setup braucht also keinen neuen Key.
Dann STT darauf zeigen lassen:
hermes config set stt.provider dashscope
hermes config set stt.enabled true
hermes config set stt.streaming true
stt.streaming ist der Modus „Text erscheint, während du sprichst“. Wenn du nur Sprachnachrichten transkribieren willst, lass es auf false – das erspart dir auch das Rauschen von Korrekturen mitten im Satz.
Die Stellschrauben, die bei echtem Audio zählen
Das Standardmodell kommt mit Mandarin gut zurecht, aber echte Aufnahmen haben Füllwörter, Akzente und Hintergrundgeräusche. Das Plugin reicht die Erkennungsparameter von DashScope durch, und drei davon lohnen sich ab dem ersten Tag:
hermes config set stt.dashscope.disfluency_removal_enabled true
hermes config set stt.dashscope.max_sentence_silence 400
hermes config set stt.dashscope.vad_model near_meeting_16kdisfluency_removal_enabledentfernt „ähm“, „halt“, „weißt du“. Für Meeting-Notizen lohnt es sich.max_sentence_silencelegt fest, wie lange eine Pause dauern muss, um einen Satz zu beenden, in Millisekunden. Erhöhe den Wert bei langsamen, pausenreichen Sprecherinnen, dann wird die Segmentierung weniger zerhackt.vad_modelwählt das Modell für Sprachaktivität, das zur Segmentierung dient. Ein Nahfeld-Meeting-Modell wienear_meeting_16kist in einem Raum stabiler als ein generisches.
Ein paar weitere sind gut zu kennen: keep_dialect bewahrt den Dialekt, statt auf Standard-Mandarin zu normalisieren, speech_noise_threshold justiert die Schwelle zwischen Sprache und Rauschen, vocabulary_id hängt eine vorkompilierte Hotword-Liste an (ein großer Genauigkeitssprung bei Produktnamen und Fachjargon), und language_hints akzeptiert bis zu vier Sprachhinweise. Alles ohne eigenen Konfigurationsschlüssel lässt sich gesammelt über ein parameters-Wörterbuch durchreichen.
Setz die Sprache ebenfalls ausdrücklich. Der globale Standard von Hermes ist en, aus gutem Grund – die Auto-Erkennung von Whisper greift bei kurzen Clips daneben. Für chinesische Eingaben:
hermes config set stt.language zhNicht gesetzte Schlüssel unter stt.dashscope fallen auf Standardwerte zurück. Der Endpoint ist standardmäßig https://maas.qianwenaiapi.com/api/v1; gibst du eine HTTP-Adresse an, tauscht das Plugin selbst den Live-Endpoint ein. OpenAI-kompatible Adressen (mit /compatible-mode/v1) funktionieren ebenfalls, da das SDK nur den Hostnamen liest. workspace wird nur verwendet, wenn du es setzt.
Wohin das Audio geht
Sei dir darüber im Klaren: Das Audio und der API-Key gehen an den Endpoint, den du konfiguriert hast – standardmäßig die Qwen AI Platform – und nichts anderes verlässt die Maschine. Lokal gibt es eine temporäre wav-Datei für die Transkodierung, die nach dem Aufruf gelöscht wird. Das ist ein Cloud-Aufruf. Wenn die Aufnahmen sensibel sind, bleib entweder bei lokalem Whisper oder prüfe, ob der Weg zu deinen Compliance-Regeln passt, bevor du umstellst.
Wie du wieder rauskommst
Zwei Befehle:
hermes config set stt.provider local
hermes plugins disable transcription-dashscope
Du wirst sie in drei Fällen brauchen: Das Konto hat kein Guthaben mehr oder das Modell ist nicht freigeschaltet (Arrearage: Access denied); das Audio ist zu lang – dieses Modell zielt auf kurze Clips und erkennungsnahe Konversation, ein einstündiges Interview will ein eigenes Datei-Transkriptionsmodell; oder du willst schlicht nicht, dass Audio die Maschine verlässt.
Noch etwas, das du vorher wissen solltest: Die Voice-Schnittstelle von SDK 2.0 ist offiziell als Preview gekennzeichnet. Schick nach jedem SDK-Upgrade eine Sprachnachricht und prüfe, ob sie noch transkribiert, statt den Bruch während eines wichtigen Meetings zu entdecken.
Lohnt sich der Wechsel?
Wenn deine Spracheingabe überwiegend Chinesisch ist, nicht besonders viel Volumen hat und du Whisper lieber nicht lokal laufen lässt, ist das ein guter Tausch: zwei Installationsbefehle, vier Konfigurationszeilen, den Rest erledigt die Plattform. Oberhalb der STT-Schicht ändert sich nichts – Transkripte landen weiterhin in der Session und lösen dieselben Werkzeugaufrufe aus; nur die Ohren sind andere.
Wenn dein Audio überwiegend Englisch ist oder Datenschutz die einschränkende Größe ist, bleibt das eingebaute lokale Whisper die ruhigere Option, zum Preis eines langsamen ersten Ladens und stetiger CPU-Last. Wie du Stille vor dem Upload abschneidest und das Modell im Leerlauf entlädst, vertieft der Leitfaden zum Stille-Trimming und Idle-Unload bei STT. Die Ausgabeseite – Text zu Sprache – behandelt der Leitfaden zur Stimmauswahl.