群里一段三分钟语音,agent 只看到一个文件名:给 Hermes 换上千问语音识别
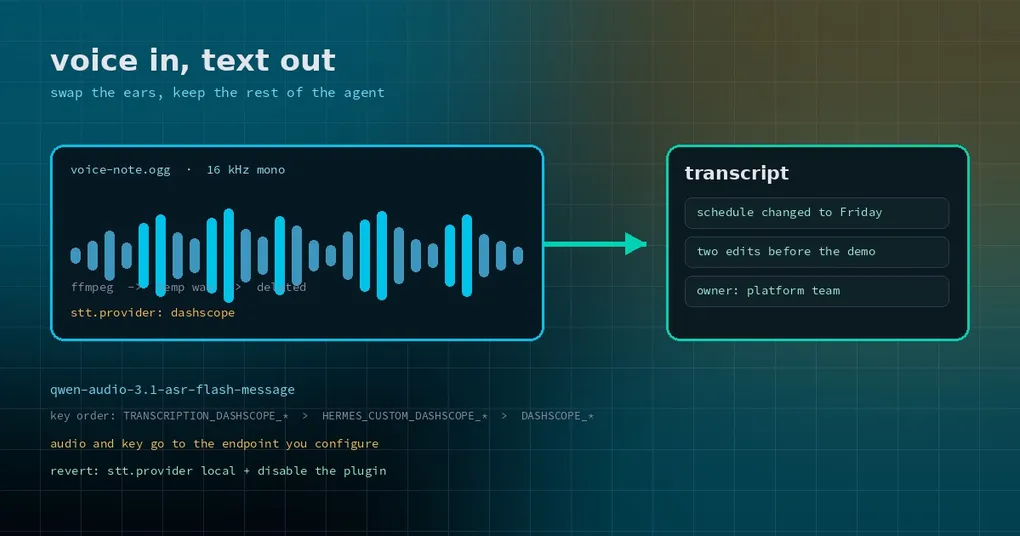
场景很具体:合伙人给你发了一段两分半的语音,说的是排期和两个要改的点。你把语音转给 Hermes,想让它整理成任务清单。它回你一句“我收到了一个语音文件”,然后开始问你文件里说了什么。因为对 Hermes 来说,那确实只是一个 .ogg。
语音消息是聊天里最常见、也最容易被 agent 忽略的输入。Hermes 本身有 STT(语音转文字)层,内置了本地 Whisper 和几个云端后端,但它们各有代价:本地跑 whisper 吃 CPU、模型加载慢;云端要么需要海外网络的 key,要么按分钟计费。如果你的团队日常用千问/阿里云那一套,现在多了一个新选择——社区插件 transcription-dashscope,把 STT 接到千问AI平台(DashScope)的 Qwen-Audio-ASR 上。
它替换的是哪一层
要理解这个插件,先看 Hermes 的语音链路是怎么分层的。stt.* 配置管的是“把声音变成文字”,tts.* 管的是“把文字变成声音”,两者互不干扰。默认配置里 stt.enabled 是开着的,echo_transcripts 也是开着的——也就是说,网关收到语音消息会转成文字,并把转写结果以一条带 🎙️ 的消息回显给你。
后端是可插拔的。核心内置了几种(本地 Whisper、Groq、OpenAI、Mistral、ElevenLabs、DeepInfra、xAI),插件可以再注册新的 provider 名字。这个插件注册的名字就叫 dashscope,所以你只需要把 stt.provider 指过去。
它做两件事:网关里的语音消息自动转写;桌面或 CLI 的听写模式(stt.streaming 打开后)边说边出字。模型默认是 qwen-audio-3.1-asr-flash-message。
装之前的三项准备
一个千问AI平台的 API key。 这是必须的,没有 key 就没有识别。
系统里要有 ffmpeg。 插件用它把所有录音格式统一成 16 kHz 单声道——实时识别接口只收这个采样率,微信/Telegram 的语音文件不会正好符合。转换用的是一个临时 wav,识别完就删掉。
Hermes 版本要够新。 目录里这条目的要求是 >=0.22.5。版本不够就别硬装,先把 hermes update 走一遍。
装上之后先别急着开听写,按顺序做:
hermes plugins install transcription-dashscope
hermes plugins enable transcription-dashscope
hermes gateway restart
重启网关这一步不能省。插件带 Python 依赖,装好之后当前进程还没加载它,重启才会生效。如果你跳过重启,下一步设置 provider 时会看到 DashScope SDK is not importable in this process 这类提示——那不是装坏了,是进程还没换。
四行配置打开它
key 放进 profile 的 .env:
DASHSCOPE_API_KEY=sk-your-key插件认三个环境变量,优先级从高到低是 TRANSCRIPTION_DASHSCOPE_API_KEY(这个插件专用)、HERMES_CUSTOM_DASHSCOPE_API_KEY(自定义 provider 那套)、DASHSCOPE_API_KEY(内置 DashScope 那套)。任意一套配好就能用,已经配过阿里云的不必再配一遍。
然后指向它:
hermes config set stt.provider dashscope
hermes config set stt.enabled true
hermes config set stt.streaming true
stt.streaming 是“边说边出字”,只想要语音消息转文字、不需要实时听写的话,保持 false 就行——它同时也能省掉一些中间结果的噪音。
中文场景的几个开关
默认模型对中文普通话没问题,但真实录音总有杂音、口音、语气词。插件把 DashScope 的识别参数基本原样透传,常用的几个:
hermes config set stt.dashscope.disfluency_removal_enabled true
hermes config set stt.dashscope.max_sentence_silence 400
hermes config set stt.dashscope.vad_model near_meeting_16kdisfluency_removal_enabled:去掉“那个、就是、嗯”这类语气词。整理会议记录时很值。max_sentence_silence:多久的停顿算一句话结束(毫秒)。说话慢、爱停顿的人,把它调大一点断句更自然。vad_model:断句用的 VAD 模型。会议场景用near_meeting_16k这类针对近场会议的模型,效果比通用模型稳。
另外还有几个值得知道的:keep_dialect 保留方言原文(不强行转成普通话)、speech_noise_threshold 调语音/噪音的判定阈值、vocabulary_id 用预编译热词表(专有名词、产品名识别率会明显提升)、language_hints 最多给 4 个语种提示。冷门参数如果配置里没有对应键,可以用 parameters 整体塞一个字典进去。
语言也要显式设置,因为 Hermes 的全局默认是 en——这是有原因的,Whisper 对短音频的语种自动检测经常判错。中文环境请设成:
hermes config set stt.language zh如果 stt.dashscope 下的键没写,插件用默认值;地址默认是 https://maas.qianwenaiapi.com/api/v1,填 HTTP 地址即可,插件自己会换成实时接口的地址,OpenAI 兼容风格的地址(带 /compatible-mode/v1)也认,SDK 只看主机名。填了 workspace 才走工作空间网关。
语音数据去了哪里
这个必须讲明白:音频和 API key 会发到你配置的那个端点(默认是千问AI平台),别的都不发。本地只留一个用来转码的临时 wav,识别完删除。也就是说,这是一次明确的云端调用——如果录音内容本身敏感,要么换本地 Whisper,要么提前确认这条链路符合你们的合规要求。
什么时候该退回去
装插件容易,退回去也只要两条命令:
hermes config set stt.provider local
hermes plugins disable transcription-dashscope
什么时候会想退?三种情况:账号欠费或模型没开通(表现为 Arrearage: Access denied);音频太长——这个模型面向短音频和会话级识别,一个小时的访谈录音请换专门的文件转写模型;或者你只是不希望音频离开本机。
还有一个细节值得提前知道:千问 SDK 2.0 的语音接口官方标注为 preview。升级 SDK 之后,先发一条语音消息验证一次,别等到重要会议才发现在报错。
值不值得换
如果你的语音输入主要是中文、量不大、又不想在本机跑 Whisper,这个插件的性价比很高:装两条命令,配四行,剩下的交给平台。它不改变 Hermes 的任何上层行为——转写出来的文字照样进会话、照样触发工具调用,区别只是“听”这一层换了耳朵。
如果你的语音是英文为主、或者对隐私要求高,内置的本地 Whisper 依然是最省心的选择,代价是首次加载慢、跑起来吃 CPU;相关的静音裁剪和空闲卸载,之前那篇 STT 静音裁剪与空闲卸载 讲得比这里细。语音输出的那一半——也就是 TTS——可以看 语音选择器指南。