Rotaste la clave, pero el proceso se quedó con la vieja: cómo Hermes corrigió un bug de caché obsoleta dentro del mismo tick
Son la una de la mañana y estás rotando tu clave de OpenRouter, porque la anterior se filtró y tiene que morir ya. Editas la línea en config.yaml, cambias la copia en .env y eliminas de la lista de emparejamiento a un usuario de Telegram que ya no debería poder hablar con tu agente. No reinicias nada: Hermes recarga los cambios en caliente y llevas meses confiando en eso. Por la mañana, un profile usa tan tranquilo la clave nueva mientras una sesión de un profile seguidor sigue disparando peticiones con la vieja y llenando el log de 401. ¿Y el usuario que revocaste? Sigue entrando.
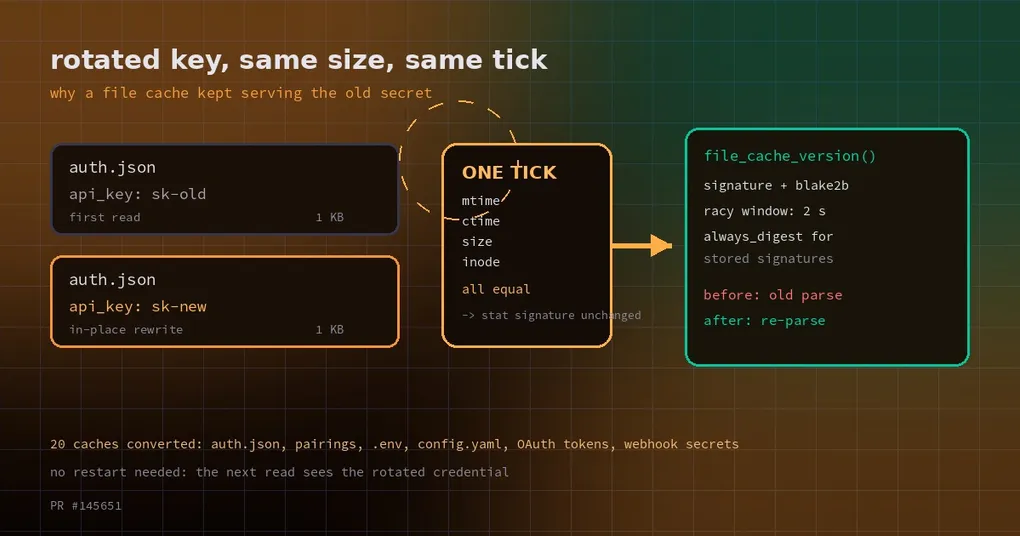
No es que se te haya olvidado guardar. La respuesta del PR #145651, fusionado el 27 de octubre, es algo contraintuitiva: tu edición sí llegó al archivo, pero el proceso creía que el archivo no había cambiado. Y lo creía porque estaba vigilando una huella que no se mueve cuando la lectura y la escritura caen dentro del mismo tick del reloj.
Qué vigila realmente una caché
Hermes mantiene cachés pequeñas por todas partes. Lee auth.json una vez y recuerda el parseo; lee la lista de emparejamiento una vez y recuerda quién está aprobado; lee config.yaml una vez y recuerda las rutas de los providers. Para no reparsear sin motivo, cada caché mira primero una “huella” del archivo. Los cuatro valores de siempre:
mtime: la hora de la última modificaciónctime: la hora de cambio del inodosize: el número de bytesinode: el número del archivo
Misma huella, se reutiliza el parseo. Huella distinta, se vuelve a leer. Eso es correcto casi siempre. Falla cuando se alinean dos detalles.
Detalle uno: misma longitud, sobrescritura en el sitio. Convertir api_key: sk-old en api_key: sk-new deja el número de bytes idéntico, y escribir sobre el mismo sitio —desde un editor o desde un script— también conserva el inodo. Dos de los cuatro valores quedan garantizados como iguales.
Detalle dos: la resolución del timestamp. En muchos kernels (notablemente los runners de CI y algunos hosts antiguos sin timestamps multigrain), mtime y ctime vienen de un reloj bastante grueso. Si la lectura y la escritura caen en el mismo tick, ambas escrituras llevan exactamente la misma (mtime_ns, size, ino, ctime_ns). La caché ve una huella sin cambios y concluye: nada que hacer, me quedo con el parseo viejo.
Así lo detectó el CI. Un test escribe config.yaml con el puerto 3, lo lee y luego lo reescribe en el sitio con el puerto 5: misma longitud, mismo inodo. El fallo de la aserción es de una claridad casi cómica:
E At index 1 diff: 'http://127.0.0.1:3/v1' != 'http://127.0.0.1:5/v1'El puerto 3 y el puerto 5 ocupan un carácter cada uno, así que el archivo mide byte por byte exactamente lo mismo. El test pretendía demostrar que una clave rotada llega a las sesiones de los profiles seguidores; lo que demostró fue que la caché estaba sirviendo la ruta antigua.
Por qué reiniciar lo “arregla” y la recarga en caliente no
Esta es la parte que desespera a la gente: el bug solo existe mientras el proceso está vivo.
Tras un reinicio todas las cachés arrancan vacías, la primera lectura tiene que parsear y ves el valor nuevo. Por eso también el síntoma se diagnostica mal hasta el infinito: “la config no se aplicó”, “la recarga en caliente está rota”, “este profile se quedó atascado”. Todas las explicaciones apuntan al sistema de configuración, cuando el verdadero culpable es cómo se diseñó la clave de caché.
El radio de impacto es mayor que el de una sola caché. Algunas claves usaban la tupla completa de cuatro valores; otras solo mtime; otras mtime + size. Si esquivas una, otro componente puede seguir dándote el valor de ayer.
Un helper en lugar de veinte parches
El arreglo no parchea cada sitio. Añade un único helper en el utils.py de la raíz del repositorio:
def file_cache_version(path, st=None, *, always_digest=False):
    ...
Devuelve dos cosas: la firma del archivo y un digest de su contenido.
- La firma sigue siendo la tupla barata de
stat. - El digest aplica por defecto una política de “ventana de carrera”: si el más reciente de
mtimeyctimetiene menos de dos segundos (RACY_MTIME_WINDOW_NS), se hashean los bytes del archivo con blake2b; una vez que el archivo se ha asentado, el digest pasa a ser una cadena vacía.
En palabras llanas: un archivo recién escrito se juzga por su contenido, y un archivo ya asentado se juzga por su firma de stat. El único coste es un parseo extra para una entrada cacheada mientras el archivo aún estaba en carrera, en el momento en que se asienta. Para una caché que se revalida en cada lectura, eso no es nada.
always_digest=True existe para otro tipo de llamador: aquel que guarda una firma ahora y la compara mucho después. Para esos, un digest que se convierte en cadena vacía parecería un cambio, así que hashean en cada llamada. El PR los enumera:
- la firma del profile servido (un cambio falso reconecta los adaptadores del profile)
- el registro de fallos de parseo (un cambio falso borraría el error mientras el archivo sigue roto)
- el consentimiento de los shell hooks
- el sello del inventario del plan gratuito
- el sello de vencimiento del onboarding
- el manifiesto de skills, que se escribe en disco y lo compara el proceso siguiente
Hay una excepción deliberadamente estrecha: un worker atado a una instantánea de configuración congelada nunca hashea config.yaml. La comprobación vive dentro del helper, así que ningún llamador puede hacer que un worker seguro abra el archivo del profile. Los demás archivos —auth.json, .env, las listas de emparejamiento— mantienen el digest dentro de los workers.
Y nunca lanza excepciones. Dado el stat anterior del llamador, un archivo que ha desaparecido o que ya no se puede leer recibe el nombre del error como digest, y ninguna versión legible puede coincidir con eso. La caché se invalida en lugar de romperse.
Veinte cachés, cualquiera de las cuales podía servir un secreto viejo
Después el PR enumera cada sitio donde una lectura obsoleta podía servir un secreto, un token, una lista de permitidos, una ruta o una config, y convierte los veinte. Unos cuantos que se corresponden con el uso diario:
| Sitio | Qué cachea | Clave anterior |
|---|---|---|
hermes_cli/auth.py almacén global de auth |
el auth.json compartido, tus credenciales |
file_signature |
hermes_cli/auth.py estado de login de Nous |
si tienes sesión iniciada | solo st_mtime, más un TTL de 15 s |
gateway/pairing.py lista de aprobados |
la lista de permitidos de MD | la tupla de cuatro valores |
gateway/platforms/webhook.py rutas dinámicas |
secretos HMAC por ruta | (mtime_ns, size, ino) |
plugins/platforms/feishu/feishu_comment_rules.py |
la lista de permitidos y las reglas de emparejamiento de comentarios de Feishu | solo st_mtime |
tools/mcp_oauth_manager.py |
recarga de tokens OAuth de MCP | solo st_mtime_ns |
providers/__init__.py provider personalizado con nombre |
qué ruta toma una petición | file_signature |
agent/prompt_builder.py manifiesto de skills |
la instantánea de skills en el prompt | file_signature |
Fíjate en lo que toca esa lista: credenciales, listas de permitidos, rutas y el propio prompt. Las dos listas de permitidos son las que deberían hacerte enderezar la espalda: revocar un acceso se supone que surte efecto de inmediato, no en el próximo reinicio.
En concreto, después del arreglo:
- una
api_keyrotada (k-old→k-new) llega a las sesiones de los profiles seguidores sin reiniciar; - un emparejamiento revocado no tiene acceso en la siguiente comprobación;
- un cambio de puerto de la misma longitud (
:3→:5) cambia la ruta al instante; - un token refrescado, o una corrección de config del mismo tamaño, nunca queda tapada por el parseo anterior.
Qué deberías hacer
No hay mucho que hacer, pero hay tres cosas que conviene saber.
Primero, actualiza. Un arreglo así llega a tu instalación con el siguiente tag; quienes usan la CLI pasan por hermes update. Si quieres conocer los matices de ese camino, los cubrimos en nuestra guía de actualización.
Segundo, deja de usar los reinicios como forma de aplicar la config. Si cogiste la costumbre de rebotar el gateway después de cada edición de config porque “si no, a veces no entra”, probablemente estabas topándote con esto. Después de la actualización, la recarga en caliente se comporta como suponías.
Tercero, verifica las revocaciones. Si controlas quién puede hablar con un bot mediante la lista de permitidos del emparejamiento (el mecanismo está descrito en nuestro artículo sobre la allowlist del gateway), manda un mensaje después de revocar y confirma que se rechaza, en vez de dar por hecho que funcionó. Antes de este arreglo, eso de “creía que ya lo había revocado” era un agujero real.
También vale la pena guardar los secretos como es debido. Repasamos la diferencia entre auth.json y .env, y el cifrado con el llavero del sistema, en la guía de secretos y cifrado.
La conclusión
Lo que hace desagradable a este bug no es su dificultad. Es que abre una brecha invisible entre “lo cambié” y “el sistema está usando el valor nuevo”. Tú cambiaste un archivo, el sistema se fiaba de una huella, y la huella no se mueve cuando ambas acciones caen en el mismo tick del reloj. El arreglo sigue un buen instinto: en vez de adivinar qué parser usará cada cliente, haz detectable que “estos dos pueden discrepar”: hashea el contenido donde puedas y hashealo siempre donde no puedas. Una caché debería ser una optimización de rendimiento, no una copia del mundo de la semana pasada.