换了 API Key 却还在用旧的那把:Hermes 修掉了「同一个时间刻度」引发的缓存事故
凌晨一点,你把 OpenRouter 的 key 换了一把新的——旧那把在别处泄露了,必须立刻作废。你打开 config.yaml 改掉那一行,顺手把 .env 里的也换掉,然后在另一个终端把某个已经不该有权限的 Telegram 用户从配对名单里删掉。你没有重启任何东西,因为 Hermes 一向支持热加载,改完就生效。第二天早上你发现:主力 profile 用的是新 key,但另一个跟着 profile 跑的会话还在拿旧 key 发请求,日志里一串 401;那个被删掉的用户,居然还能发消息进来。
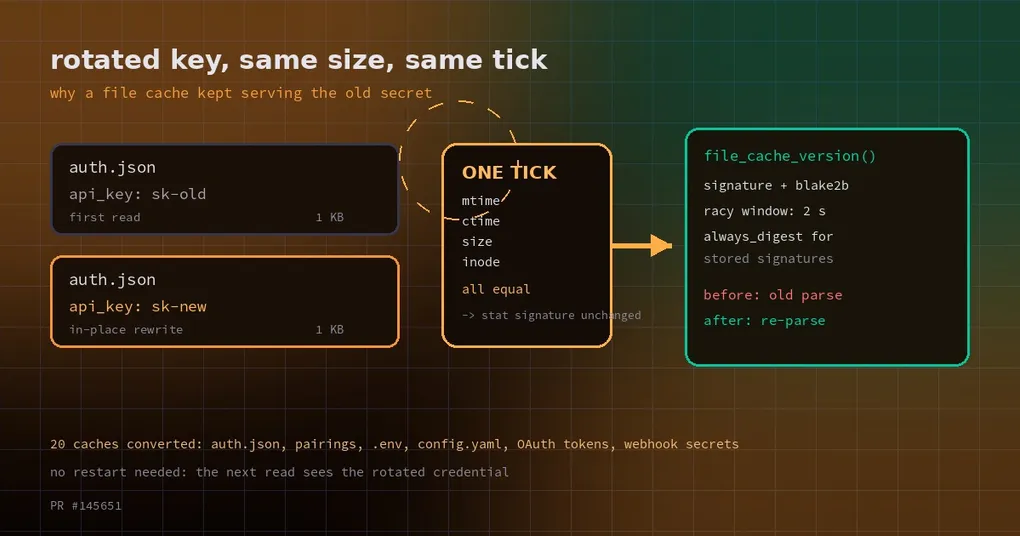
这不是玄学,也不是你没保存。10 月 27 日合入的 PR #145651 给出的答案有点反直觉:你的改动确实写进了文件,但进程里的缓存认为“这个文件没变过”。而它判断“变没变”的依据,是一个在同一次时钟跳动里根本不会变化的指纹。
缓存凭什么认定文件没变
Hermes 里到处都有这种小缓存:读一次 auth.json,把解析结果记住;读一次配对名单,把已批准的用户记住;读一次 config.yaml,把 provider 路由记住。为了不做无谓的重复解析,它们会先看一眼文件的“指纹”,常见的是四个值:
mtime(最后修改时间)ctime(inode 变更时间)size(字节数)inode(文件编号)
指纹没变,就用上次解析出来的结果;指纹变了,才重新读。这个思路在绝大多数场景下都对,问题出在两个细节撞在一起的时候。
第一个细节:同长度、原地覆盖。把 api_key: sk-old 改成 api_key: sk-new,字节数完全一样;用编辑器或脚本原地写回,inode 也不变。四个值里已经有两个注定相同。
第二个细节:时间戳的精度。很多内核(尤其是没开 multigrain timestamps 的 CI 机器和一部分老机器)的 mtime、ctime 来自一个比较粗的时钟。如果“读文件”和“写文件”落在同一个时钟刻度里,两次写入会共享完全相同的 (mtime_ns, size, ino, ctime_ns)。于是缓存看到的是一个一模一样的指纹,得出结论:没变,继续用旧解析。
CI 上就是这么暴露的。一个测试先写 config.yaml 用端口 3,读一次,再原地改成端口 5——长度一样、inode 一样。断言失败的样子非常朴素:
E At index 1 diff: 'http://127.0.0.1:3/v1' != 'http://127.0.0.1:5/v1'端口 3 和端口 5 都是单个字符,文件长度一模一样。测试想证明“轮换后的 key 能到达跟着 profile 跑的会话”,结果它证明的是:缓存把旧路由端了出来。
为什么重启能修好,热加载不能
理解这一点,你就明白为什么这个 bug 让人抓狂:它只在“进程活着”的时候存在。
重启之后,所有缓存都是空的,第一次读文件必然重新解析,所以你看到的是新值。这也解释了为什么这类问题总是被误判成“配置没生效”“热加载坏了”“某个 profile 被冻结了”——你能想到的所有解释都指向配置系统,而真正的凶手是缓存键的设计。
更麻烦的是它的影响面。缓存键不严谨的地方不止一处:有的是完整四元组,有的只看 mtime,有的看 mtime + size。也就是说,即使你绕过了其中一处,别的组件可能还在端旧值。
一个函数把整类问题收口
修复没有逐个打补丁,而是加了一个统一的辅助函数,位置在仓库根目录的 utils.py:
def file_cache_version(path, st=None, *, always_digest=False):
    ...
它返回“文件指纹 + 内容摘要”两样东西:
- 指纹还是原来那个 stat 签名,便宜、快;
- 摘要默认走一个“racy 窗口”策略:如果
mtime和ctime里较晚的那个距离现在不到 2 秒(常量RACY_MTIME_WINDOW_NS就是 2 秒),就顺手算一遍文件内容的 blake2b 摘要;等文件“settle”(落定)之后,摘要置为空字符串。
换句话说,刚写完的文件按内容判断,写稳了的文件按指纹判断。代价只有一次:在文件还“racy”的时候存进缓存的那一条,等文件落定后会多解析一次。这对“每次读都要复检”的缓存是完全可接受的。
而 always_digest=True 是给另一类签名用的:它会被存下来,很久以后才拿来比较。这类签名如果中途从“有摘要”变成“空字符串”,看起来就像文件变了——所以它们每次调用都老实算摘要。PR 里点名了这几个:
- 已服务 profile 的签名(误判会导致 profile 的适配器重连)
- 解析失败记录(误判会在文件还坏着的时候清掉错误状态)
- shell hook 的授权同意
- 免费额度的清单戳
- onboarding 的到期戳
- skills 清单(写到磁盘、由下一个进程比较)
还有一个容易被忽略的边界:绑定在冻结配置快照上的 worker,永远不去哈希 config.yaml。这个判断放在辅助函数内部,所以任何调用方都没法让一个“安全 worker”去打开 profile 配置文件。其它文件(auth.json、.env、配对名单)在 worker 里仍然算摘要。
最后一条是鲁棒性:给定了调用方刚才那次 stat 的结果,这个函数从不抛异常。文件在那次 stat 之后被删掉或读不了,就把错误名当作摘要返回——任何“可读版本”的摘要都不会等于它,所以缓存自然失效,而不是崩溃。
二十处缓存,哪一处都可能端出旧密码
改完之后,PR 列了一张很长的表,把“陈旧的读取可能端出秘密、token、白名单、路由或配置”的调用点全部换掉,一共二十处。挑几个最贴近日常的:
| 位置 | 缓存的是什么 | 改之前靠什么判断 |
|---|---|---|
hermes_cli/auth.py 的全局 auth store |
共享的 auth.json,也就是你的凭据 |
file_signature |
hermes_cli/auth.py 的 Nous 登录状态 |
你的登录状态 | 只看 mtime(外加 15 秒 TTL) |
gateway/pairing.py 的已批准列表 |
DM 白名单 | 四元组 |
gateway/platforms/webhook.py 的动态路由 |
每条路由的 HMAC 密钥 | (mtime_ns, size, ino) |
plugins/platforms/feishu/feishu_comment_rules.py |
飞书评论的配对白名单与规则 | 只看 mtime |
tools/mcp_oauth_manager.py |
MCP OAuth token 的重载 | 只看 st_mtime_ns |
providers/__init__.py 的命名自定义 provider |
走哪条路由 | file_signature |
agent/prompt_builder.py 的 skills 清单 |
写进提示词的技能快照 | file_signature |
你大概能看出这个清单的分量:凭据、白名单、路由、提示词。其中“DM 白名单”和“飞书评论白名单”是最扎眼的两行——收回一个人的权限,本该是立刻生效的事。
具体到行为上,这次修复意味着:
- 轮换过的
api_key(k-old→k-new)能立刻到达跟着 profile 跑的会话,不用重启; - 被撤销的配对,下一次判断就看不到访问权;
- 同长度改一个端口(
:3→:5)能立刻改变路由; - 旋转后的 token、同一大小写下的配置修正,都不会再被“上次的解析”盖住。
你这边要做什么
老实说,作为普通用户你没有太多要做的,但有三件事值得知道:
第一,升级。这类修复在下一个 tag 里才会到你的安装上。按你自己渠道的升级方式走即可,CLI 用户是 hermes update(升级路径的注意事项可以参考我们之前整理的升级指南)。
第二,别再靠重启来“让配置生效”。如果你以前形成了一个习惯——改完配置就重启 gateway,因为“不重启有时候不生效”——那多半就是撞上过这个缓存问题。更新之后,热加载的行为才是你以为的那种行为。
第三,权限回收要验证。如果你用配对白名单控制谁能跟 bot 说话(机制见多 profile 的 allowlist 说明),收回权限之后建议实际发一条消息确认被拒,而不是假设它生效了。这类“我以为已经收回了”的漏洞,在修好之前是真实存在的。
顺带一句:密钥本身怎么存也很重要。auth.json 与 .env 的区别、以及用系统钥匙串加密的做法,我们在密钥与加密那篇里拆过。
一句话总结
这个 bug 的可怕之处不在技术难度,而在它让“我已经改了”和“系统已经在用新值”之间出现了一段看不见的空白:你改的是文件,系统信的是指纹,而指纹在两个动作落到同一个时钟刻度时不会变。修法也很符合工程直觉——不去猜哪个客户端用哪种读法,而是让“可能不一致”这件事本身变得可检测:能算内容摘要的地方就算,算不了的地方就每次算。缓存本该是性能优化,不该是“上一个版本的世界”。