Bloqué au démarrage : deux interblocages internes dans Hermes, et comment ils ont été trouvés
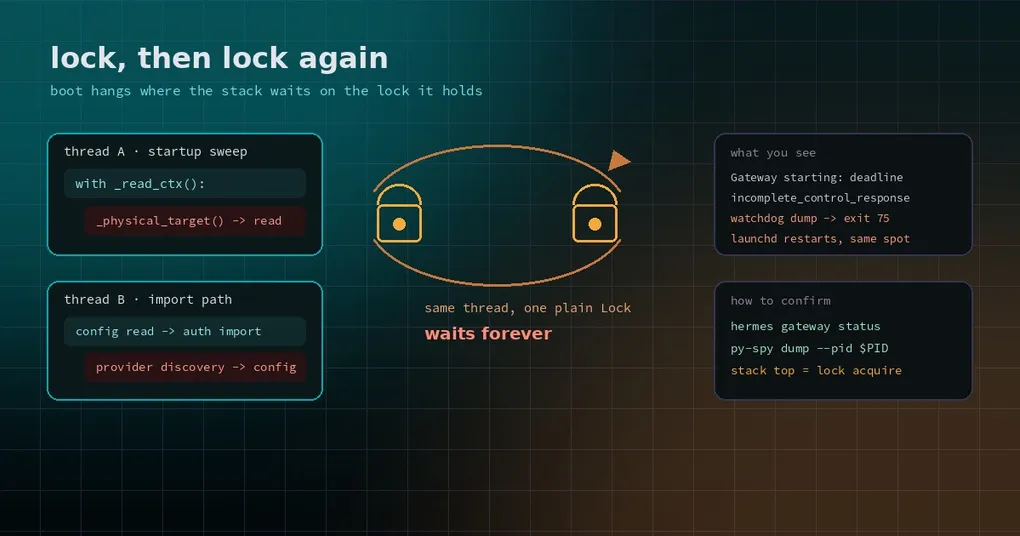
Vous tapez hermes gateway restart et vous attendez. Trois secondes, dix, trente. Le terminal ne vous laisse qu’une ligne : Gateway starting: deadline. L’application de bureau signale Gateway inaccessible: incomplete_control_response, vous cliquez sur réessayer, et vous obtenez la même phrase. Vous redémarrez la machine, le service revient, et se bloque exactement au même point — redémarrage après redémarrage, sans jamais démarrer vraiment.
Le premier réflexe est « ma config doit être cassée », « le disque doit être plein », « cette build est mauvaise ». Un mode de défaillance est plus retors que tous ceux-là : le processus n’a pas planté, le CPU est au repos, le log ne contient aucune erreur — il attend simplement un verrou qu’il détient déjà. C’est un interblocage sur soi-même, et cela se présente comme « bloqué », pas comme « en échec ».
Vers le 2026-10-30, Hermes a corrigé deux interblocages de démarrage de ce type : un dans le balayage de démarrage du gateway, un sur le chemin de démarrage du backend de configuration distante. Ils partagent la leçon à retenir : les deux appelaient, depuis une section critique qui détenait déjà le verrou, quelque chose qui avait besoin de ce même verrou.
D’abord, distinguer « lent » de « mort »
Les deux se ressemblent et appellent des réponses opposées, d’où ce comparatif à garder sous la main :
| Symptôme | Lent (attendez) | Interblocage (attendre ne sert à rien) |
|---|---|---|
| Durée du démarrage | se termine seul en dizaines de secondes | ne dépasse jamais le même point |
| CPU | occupé, en cours d’initialisation | proche de zéro, thread endormi |
| Log | continue d’imprimer des lignes | s’arrête net sur la dernière ligne |
| Redémarrage | généralement OK la deuxième fois | se bloque au même endroit à chaque fois |
| État du thread | attend des IO ou le réseau | attend un verrou (futex, acquisition de lock) |
Le gateway embarque un watchdog de vivacité de la boucle qui vide la pile courante et sort brutalement avec le statut 75 quand la boucle d’événements est coincée, pour que systemd ou launchd le redémarre. Le comportement est juste — un processus redémarré vaut mieux qu’un processus figé — mais il déguise un interblocage en une série d’entrées « le gateway a encore planté ». Ce que vous voyez dans le log, c’est démarrage après démarrage, jamais une erreur claire.
Interblocage un : un contexte de lecture imbriqué dans le balayage de démarrage
Le premier cas est le balayage des orphelins au démarrage du gateway, qui clôt les sessions laissées par un processus précédent. La chaîne est recover_local_sessions() → arm_startup_orphan_closes() → _idle_s(), qui décide depuis combien de temps une session est inactive.
Le code fautif ressemblait à ceci (simplifié) :
with authority.db._read_ctx() as conn:
    row = conn.execute(
        f'SELECT {_sql_session_last_active("s")} FROM sessions s WHERE s.id = ?',
        (_physical_target(authority, session_id),),   # ← opens a SECOND read context
    ).fetchone()
Le problème, c’est l’argument : _physical_target() lit le reçu de session local, et lire le reçu est en soi une lecture de base de données. Donc à l’intérieur d’un bloc qui a déjà ouvert un contexte de lecture, composer un paramètre en ouvre un second.
Normalement, c’est inoffensif, car les lectures passent par le pool de lecture WAL et s’exécutent en parallèle. Mais quand ce pool est indisponible — la base n’est pas en mode WAL (journal DELETE), le home se trouve sur un système de fichiers réseau comme NFS, ou tous les permis de lecture sont épuisés — _read_ctx() dégénère en « utiliser la connexion d’écriture sous SessionDB._lock ». Ce verrou est un simple threading.Lock : non réentrant.
Un thread prend donc le verrou, puis redemande ce même verrou depuis l’intérieur, et attend indéfiniment.
Le correctif est conceptuel plutôt qu’astucieux : calculer la cible d’abord, puis ouvrir le contexte de lecture, pour que la sonde n’en prenne qu’un.
target = _physical_target(authority, session_id)
with authority.db._read_ctx() as conn:
    row = conn.execute(..., (target,)).fetchone()
La preuve en conditions réelles est un cas d’école. Sur un gateway macOS, le thread de démarrage s’est garé exactement là, le socket de contrôle n’a jamais répondu, les clients de bureau ont signalé Gateway inaccessible: incomplete_control_response et Gateway starting: deadline, le watchdog a vidé cette pile et quitté en 75, launchd l’a redémarré, et tout a recommencé. C’est une boucle de démarrage, pas un démarrage lent.
Une précision : le chemin de lecture dégradé est correct tel qu’il est conçu — une lecture plus lente vaut mieux qu’un épuisement des descripteurs de fichiers. Ce qui était faux, c’était d’y imbriquer une seconde lecture.
Interblocage deux : lire la config avant que la config soit lisible
Le second cas est plus subtil et plus instructif, car il s’agit d’une inversion d’ordre de verrous entre modules.
Un agent Cloud dont le backend de configuration est réglé sur distant (HERMES_CONFIG_BACKEND=remote) ne démarre jamais : la première lecture de config de la deuxième étape de démarrage se bloque indéfiniment. Mode d’identifiants Nous uniquement ; le mode IdP n’est pas concerné.
La chaîne :
- La première lecture de config d’un profil prend le verrou de récupération de ce profil, puis lance la récupération de démarrage.
- La récupération résout son bearer — le token d’accès Nous — ce qui importe à froid
hermes_cli.auth. hermes_cli.authimportehermes_cli.configau moment de l’import, et ce module remplissaitOPTIONAL_ENV_VARS(les métadonnées du type « de quelle variable d’environnement ce fournisseur a-t-il besoin ») à partir des profils de fournisseurs.- Lister les fournisseurs lance la découverte des fournisseurs, et la découverte lit la config (
plugins.enabled,plugins.isolation). - Cette lecture demande au backend le même profil et attend le verrou de récupération de l’étape 1 — détenu par le thread même qui fait tout ça.
En une phrase : pour lire la config, il fallait lire la config. Ce n’est pas de la simple réentrance ; c’est un module qui fait des IO à effet de bord à l’import, puis se fait importer par un autre module qui détient déjà un verrou.
Le correctif supprime la lecture de config à l’import plutôt que de la contourner :
- Importer
hermes_cli.configouhermes_cli.authne lit aucune config. Le catalogue d’environnement des fournisseurs est construit à la première lecture : chaque plugin de fournisseur fourni est exécuté dans un module privé, ses enregistrements collectés — sans config, sans découverte, sans mutation du registre — et le résultat est mis en cache de façon idempotente. - Le backend distant résout son identifiant avant de prendre le verrou de récupération, et ne garde ce verrou que pour le GET ; les lecteurs concurrents font la queue à cet endroit et partagent le résultat.
- Rien n’est journalisé pendant qu’un verrou de backend est détenu. Un handler de log peut lire la config, donc les messages sont collectés et émis après libération du verrou.
- Le formateur de logs ne lit aucune config.
RedactingFormatterallait chercher, à chaque enregistrement, la politique de masquage d’un profil routé, sous le verrou du handler de logging lui-même. Il ne lit plus que la portée de secrets active et la politique enregistrée au chargement du.envou de la config de ce profil ; inconnu signifie masquer.
Ce dernier point est discrètement une amélioration de sécurité : « impossible de déterminer la politique » et « la politique est de ne pas masquer » étaient faciles à confondre, et la valeur par défaut est désormais la plus sûre.
Comment confirmer qu’il s’agit d’un interblocage
Ne devinez pas. Un vidage de pile vaut dix lectures de log :
- Trouvez le processus :
hermes gateway statusliste les services et processus en cours. - Prenez un instantané avec
py-spy(profileur tiers,pip install py-spy) :py-spy dump --pid $GATEWAY_PID. - Regardez où se trouve le thread de démarrage. Les premières frames d’un interblocage sont des acquisitions de verrou (
threading.Lock.acquire,futex,_read_ctx,with self._lock), pas des IO réseau ou disque. - Si la pile du même thread montre à la fois le détenteur du verrou et celui qui l’attend — un bloc
withdont le corps appelle quelque chose qui prend le même verrou — vous avez votre réponse.
Il existe aussi un test très pratique : essayez un autre home. Lancez HERMES_HOME=/tmp/hermes-probe hermes gateway sur un home vide. S’il démarre instantanément, le code est correct et le problème vient de l’état ou du système de fichiers de votre home — ce qui est exactement le déclencheur du premier cas (pas de WAL, ou home sur NFS).
Que faire quand ça vous arrive
- Premier cas (auto-verrou du balayage de démarrage) : le déclencheur est un home dont le pool de lecture WAL est indisponible. Si vous êtes épinglé à une build sans le correctif, redémarrer n’aidera pas — le blocage est identique à chaque fois. L’atténuation pratique consiste à garder
HERMES_HOMEsur un disque local en mode WAL, plutôt que sur NFS ou un autre partage réseau. - Second cas (interblocage de démarrage en config distante) : le backend distant n’a pas de repli local, donc remettre
HERMES_CONFIG_BACKENDsurfilene fonctionne que si ce profil a encore unconfig.yamllocal utilisable. Sans cela, le changement ne produit qu’une erreur différente. La vraie réponse est de passer à une build contenant le correctif. - Les deux correctifs sont sur
main(#144845 en P0, #146130 en P2) et figurent dans la v0.22.6 (2026-11-02) ; si vous restez en v0.22.5 ou avant, la mise à jour est la solution.
Ce que cela apprend à quiconque écrit des plugins
Si vous écrivez des plugins ou des backends de configuration pour Hermes, ces deux cas sont de bons modèles :
- Ne lisez pas la config, n’appelez pas le réseau et ne mutez pas les registres globaux à l’import. Vous ne savez jamais qui détient un verrou au moment où il vous importe.
- Ne faites pas d’IO ni de logging en tenant un verrou. Un handler de log est la chose qu’on oublie le plus facilement parmi celles qui lisent la config.
- Préparez les arguments avant d’entrer dans une section critique. C’est exactement ainsi que le premier cas est mort : composer un paramètre a réentré dans la même section.
- Les chemins dégradés sont le terrain de ces bugs. Le chemin rapide était concurrent, donc le bug n’apparaissait que lorsque le pool était indisponible — d’où sa longue survie en production.
Pour les modes de défaillance voisins, lisez les huit raisons pour lesquelles la boucle d’événements du gateway se fige et comment régler les seuils du watchdog de boucle. Avec cet article, ils couvrent l’essentiel de ce que « le gateway ne répond plus » peut vouloir dire.