Beim Booten hängen geblieben: zwei Self-Deadlocks in Hermes und wie man sie fand
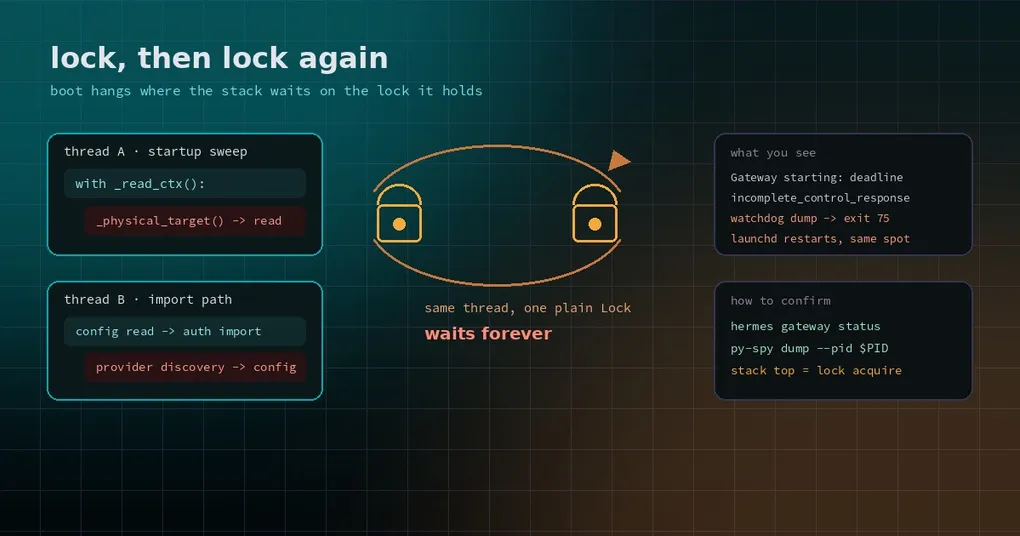
Du tippst hermes gateway restart und wartest. Drei Sekunden, zehn, dreißig. Das Terminal lässt dir eine Zeile: Gateway starting: deadline. Die Desktop-App meldet Gateway inaccessible: incomplete_control_response, du drückst auf Wiederholen und bekommst denselben Satz. Du startest die Maschine neu, der Dienst kommt wieder hoch und hängt an genau derselben Stelle – Restart für Restart, ohne dass er je wirklich bootet.
Der erste Reflex lautet „meine Config ist kaputt“, „die Platte ist voll“, „dieser Build ist Schrott“. Ein Fehlermodus ist schwieriger als alle diese: Der Prozess ist nicht abgestürzt, die CPU dümpelt, das Log enthält keinen Fehler – er wartet einfach auf einen Lock, den er selbst schon hält. Das ist ein Self-Deadlock, und er zeigt sich als „hängt“, nicht als „fehlgeschlagen“.
Rund um den 2026-10-30 hat Hermes zwei solche Boot-Deadlocks behoben: einen im Startup-Sweep des Gateways, einen auf dem Boot-Pfad des Remote-Config-Backends. Gemeinsam ist ihnen die Lehre, die man sich merken sollte: Beide riefen etwas auf, das denselben Lock brauchte, und zwar aus einem kritischen Abschnitt heraus, der ihn bereits hielt.
Zuerst „langsam“ von „tot“ unterscheiden
Beides sieht ähnlich aus und verlangt gegensätzliche Reaktionen, deshalb hier der Vergleich, den man behalten sollte:
| Symptom | Langsam (aussitzen) | Deadlock (Warten ist sinnlos) |
|---|---|---|
| Boot-Dauer | erledigt sich in Zehn-Sekunden-Schritten von selbst | kommt nie an derselben Stelle vorbei |
| CPU | beschäftigt, initialisiert | nahe null, Thread schläft |
| Log | druckt weiter neue Zeilen | bleibt an der letzten Zeile stehen |
| Restart | beim zweiten Mal meistens gut | hängt jedes Mal an identischer Stelle |
| Thread-Zustand | wartet auf IO oder Netzwerk | wartet auf einen Lock (futex, Lock-Acquire) |
Das Gateway betreibt einen Loop-Liveness-Watchdog, der den aktuellen Stack ausgibt und mit Status 75 hart beendet, wenn die Event-Loop feststeckt, damit systemd oder launchd neu starten. Das Verhalten ist richtig – ein neu gestarteter Prozess ist besser als ein eingefrorener –, tarnt aber einen Deadlock als Serie von „das Gateway ist schon wieder abgestürzt“-Einträgen. Was du im Log siehst, ist Boot für Boot, nie ein klarer Fehler.
Deadlock eins: ein verschachtelter Lese-Kontext im Startup-Sweep
Der erste Fall ist der Startup-Orphan-Sweep des Gateways, der Sessions abschließt, die ein vorheriger Prozess hinterlassen hat. Die Kette lautet recover_local_sessions() → arm_startup_orphan_closes() → _idle_s(), das entscheidet, wie lange eine Session untätig ist.
Der beanstandete Code sah so aus (vereinfacht):
with authority.db._read_ctx() as conn:
    row = conn.execute(
        f'SELECT {_sql_session_last_active("s")} FROM sessions s WHERE s.id = ?',
        (_physical_target(authority, session_id),),   # ← öffnet einen ZWEITEN Lese-Kontext
    ).fetchone()
Das Problem ist das Argument: _physical_target() liest den lokalen Session-Receipt, und den Receipt zu lesen ist selbst ein Datenbank-Read. Innerhalb eines Blocks, der bereits einen Lese-Kontext betreten hat, betritt also die Zusammensetzung eines Parameters einen zweiten.
Normalerweise ist das harmlos, weil Reads über den WAL-Read-Pool laufen und parallel arbeiten. Wenn der WAL-Read-Pool aber nicht verfügbar ist – die Datenbank läuft nicht im WAL-Modus (DELETE-Journal), das Home liegt auf einem Netzwerk-Dateisystem wie NFS, oder alle Lese-Permits sind aufgebraucht –, dann degradiert _read_ctx() zu „nutze die Writer-Verbindung unter SessionDB._lock“. Dieser Lock ist ein schlichter threading.Lock: nicht reentrant.
Ein Thread nimmt also den Lock, fragt dann aus seinem Inneren heraus denselben Lock an und wartet für immer.
Der Fix ist konzeptionell statt clever: erst das Ziel berechnen, dann den Lese-Kontext öffnen, damit die Prüfung genau einen nimmt.
target = _physical_target(authority, session_id)
with authority.db._read_ctx() as conn:
    row = conn.execute(..., (target,)).fetchone()
Der Live-Beweis ist Lehrbuch. Auf einem macOS-Gateway parkte der Boot-Thread genau dort ein, der Control-Socket antwortete nie, Desktop-Clients meldeten Gateway inaccessible: incomplete_control_response und Gateway starting: deadline, der Watchdog gab diesen Stack aus und beendete mit 75, launchd startete neu, und das Ganze wiederholte sich. Das ist eine Boot-Schleife, kein langsamer Start.
Erwähnenswert: Der degradierte Lesepfad ist so, wie er gedacht ist, korrekt – ein langsamerer Read ist besser, als die File-Descriptors auszugehen. Falsch war, einen zweiten Read darin zu verschachteln.
Deadlock zwei: Config lesen, bevor Config gelesen werden kann
Der zweite Fall ist subtiler und lehrreicher, denn er ist eine Lock-Order-Inversion über Modulgrenzen hinweg.
Ein Cloud-Agent, dessen Config-Backend auf remote steht (HERMES_CONFIG_BACKEND=remote), bootet nie: Der erste Config-Read in der zweiten Startup-Phase hängt für immer. Betrifft nur den Nous-Credential-Modus; der IdP-Modus ist unberührt.
Die Kette:
- Der erste Config-Read für ein Profil nimmt den Fetch-Lock dieses Profils und führt dann den Boot-Fetch aus.
- Der Fetch ermittelt seinen Bearer – das Nous-Access-Token – und importiert dabei kalt
hermes_cli.auth. hermes_cli.authimportiert beim Importhermes_cli.config, und dieses Modul füllteOPTIONAL_ENV_VARS(die Metadaten „welche Umgebungsvariable braucht dieser Provider“) aus Provider-Profilen.- Provider aufzulisten startet die Provider-Discovery, und die Discovery liest Config (
plugins.enabled,plugins.isolation). - Dieser Read fragt beim Backend nach demselben Profil und wartet auf den Fetch-Lock aus Schritt 1 – gehalten von genau dem Thread, der das alles tut.
In einem Satz: Um Config zu lesen, musste es Config lesen. Das ist keine einfache Reentranz; es ist ein Modul, das beim Import IO mit Nebenwirkungen macht und dann von einem anderen Modul importiert wird, das bereits einen Lock hält.
Der Fix entfernt den Config-Read zur Import-Zeit, statt ihn zu umgehen:
- Der Import von
hermes_cli.configoderhermes_cli.authliest keine Config. Der Provider-Env-Katalog wird stattdessen beim ersten Read aufgebaut: Jedes mitgelieferte Provider-Plugin wird in ein privates Modul ausgeführt, seine Registrierungen werden eingesammelt – keine Config, keine Discovery, keine Registry-Mutation – und das Ergebnis wird idempotent gecacht. - Das Remote-Backend ermittelt seine Credentials, bevor es den Fetch-Lock nimmt, und hält diesen Lock nur für den GET; parallele Leser reihen sich dort ein und teilen das Ergebnis.
- Nichts wird geloggt, solange ein Backend-Lock gehalten wird. Ein Log-Handler kann Config lesen, deshalb werden Meldungen gesammelt und erst nach dem Freigeben des Locks ausgegeben.
- Der Log-Formatter liest keine Config.
RedactingFormatterschlug früher pro Record die Redaction-Policy eines gerouteten Profils nach, unter dem Lock des Logging-Handlers selbst. Jetzt liest er nur den aktiven Secret-Scope und die Policy, die beim Laden der.envoder Config dieses Profils festgehalten wurde; unbekannt heißt redact.
Der letzte Punkt ist stillschweigend eine Sicherheitsverbesserung: „Policy nicht ermittelbar“ und „Policy lautet nicht-redact“ waren früher leicht zu verwechseln, und der Default ist jetzt der sichere.
Wie du bestätigst, dass es ein Deadlock ist
Nicht raten. Ein Stack-Dump schlägt zehn Log-Lektüren:
- Prozess finden:
hermes gateway statuslistet die laufenden Dienste und Prozesse. - Snapshot mit
py-spy(ein Drittanbieter-Profiler,pip install py-spy):py-spy dump --pid $GATEWAY_PID. - Schauen, wo der Boot-Thread sitzt. Bei einem Deadlock sind die obersten Frames Lock-Acquires (
threading.Lock.acquire,futex,_read_ctx,with self._lock), nicht Netzwerk- oder Platten-IO. - Zeigt der Stack desselben Threads sowohl den Lock-Halter als auch den Wartenden – ein
with-Block, dessen Rumpf etwas aufruft, das denselben Lock nimmt –, hast du deine Antwort.
Es gibt außerdem einen sehr praktischen Test: nimm ein anderes Home. Starte HERMES_HOME=/tmp/hermes-probe hermes gateway gegen ein leeres Home. Bootet es sofort, ist der Code in Ordnung und das Problem liegt im Zustand oder Dateisystem deines Homes – was genau der Auslöser in Fall eins ist (kein WAL oder ein Home auf NFS).
Was du tun kannst, wenn es dich erwischt
- Fall eins (Self-Lock im Startup-Sweep): Der Auslöser ist ein Home, dessen WAL-Read-Pool nicht verfügbar ist. Wenn du auf einem Build ohne den Fix festhängst, hilft Neustarten nicht – er hängt jedes Mal identisch. Die praktische Abhilfe ist,
HERMES_HOMEauf einer lokalen Platte im WAL-Modus zu halten statt auf NFS oder einer anderen Netzwerkfreigabe. - Fall zwei (Boot-Deadlock beim Remote-Config): Das Remote-Backend hat keinen lokalen Fallback, ein Zurückstellen von
HERMES_CONFIG_BACKENDauffilefunktioniert also nur, wenn dieses Profil noch eine brauchbare lokaleconfig.yamlhat. Ohne sie erzeugt die Änderung nur einen anderen Fehler. Die echte Antwort ist das Upgrade auf einen Build mit dem Fix. - Beide Fixes sind auf
main(#144845 ist P0, #146130 ist P2) und mit v0.22.6 (2026-11-02) in ein Release gekommen; wer auf v0.22.5 oder älter steht, löst das per Update.
Was das jedem beibringt, der Plugins schreibt
Wenn du Hermes-Plugins oder Config-Backends schreibst, sind diese beiden gute Vorlagen:
- Keine Config lesen, keine Netzwerkaufrufe, keine globalen Registries beim Import verändern. Du weißt nie, wer einen Lock hält, während er dich importiert.
- Kein IO und kein Logging, solange ein Lock gehalten wird. Ein Log-Handler ist das am leichtesten vergessene Ding, das Config liest.
- Argumente vorbereiten, bevor du einen kritischen Abschnitt betrittst. Genau daran ist Fall eins gestorben: Das Zusammensetzen eines Parameters betrat denselben Abschnitt erneut.
- In degradierten Pfaden wohnen diese Bugs. Der schnelle Pfad war nebenläufig, der Bug zeigte sich also erst, als der Pool nicht verfügbar war – deshalb hat er so lange in Produktion überlebt.
Für die benachbarten Fehlermodi lies die acht Gründe, aus denen die Event-Loop des Gateways einfriert und wie man die Schwellen des Loop-Watchdogs justiert. Zusammen mit diesem Artikel decken sie das meiste ab, was „das Gateway antwortet nicht mehr“ bedeuten kann.