Après un kill -9, certains processus ne partent jamais : Hermes fait désormais mourir chaque enfant avec son parent
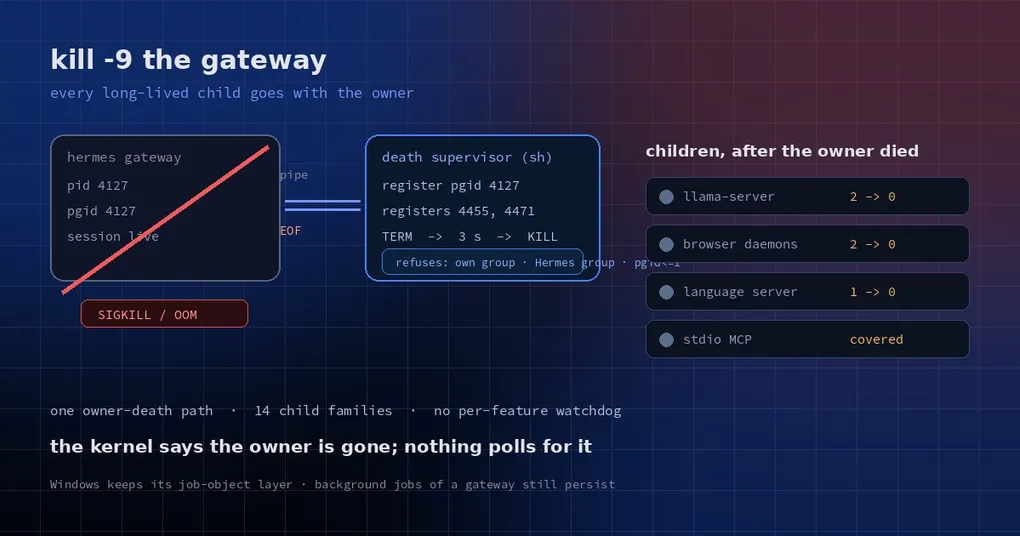
Il est 2 h du matin, les ventilateurs du portable hurlent, et vous passez un kill -9 sur le gateway Hermes qui a déraillé. Le lendemain, ss -ltnp montre toujours le port 8080 occupé, et ps liste un llama-server, deux daemons de navigateur et un language server dont le parent est mort il y a des heures. Aucun n’est parti. Vous les tuez un par un en vous demandant si demain ne sera pas un nouvel épisode du même rituel.
Ce n’est pas une erreur de l’utilisateur, c’est ainsi que fonctionne Unix. Quand un processus parent meurt, ses enfants sont réattachés à init (PID 1) et continuent leur vie. Pour une commande ponctuelle, peu importe. Pour un logiciel comme Hermes, qui lance toute une troupe d’enfants longue durée, c’est un vrai problème. Un changement récent (PR #137057) a remplacé une pile de contournements propres à chaque fonctionnalité par un seul mécanisme : quand le propriétaire meurt, tous les enfants longue durée qu’il a lancés meurent avec lui.
Pourquoi les enfants « oublient » de mourir
Presque tout ce que fait un agent lance un processus : npm run dev, un daemon d’automatisation de navigateur, un routeur de modèle local, un language server, une cellule d’exécution de code, un serveur MCP sur stdio. Ces processus devraient vivre exactement aussi longtemps que le processus Hermes qui les a lancés. Par défaut, ce n’est pas le cas : ils récupèrent simplement un nouveau parent.
La facture arrive de façon très concrète : la mémoire grimpe, les ports restent pris et le démarrage suivant échoue, un modèle local continue de brûler du GPU après la fin de la session, et un vieux daemon se dispute le même fichier pid avec le nouveau. Le débogage est pire encore : vous voyez un processus python inconnu sans avoir la moindre idée de qui l’a lancé.
Hermes rafistolait auparavant ce problème famille par famille : un balayage des orphelins au démarrage suivant, un poller par propriétaire, un watchdog sur le pid parent, un pipe de mort, un hook atexit. Aucun n’agissait au moment où le propriétaire mourait réellement ; chacun attendait le prochain démarrage ou le prochain poll, et chaque copie avait ses propres bugs.
Un seul pipe suffit pour savoir que le propriétaire est parti
La nouvelle conception ne garde qu’un seul mécanisme. Chaque processus Hermes détient l’extrémité d’écriture d’un pipe ; un superviseur (un script sh POSIX, environ 0,5 Mo résident au repos, contre 8,1 Mo pour la version Python précédente) détient l’extrémité de lecture. Quand un enfant démarre, Hermes enregistre son groupe de processus auprès du superviseur ; quand l’enfant se termine normalement, il le désenregistre.
L’astuce, c’est l’EOF. À l’instant où le processus Hermes disparaît — sortie propre, crash, kill -9, OOM killer, arrêt systemd — l’extrémité d’écriture est fermée et le superviseur lit un EOF immédiatement. C’est le noyau qui vous dit que le détenteur de l’extrémité d’écriture n’existe plus, et cela ne peut être ni ignoré ni manqué. À l’EOF, le superviseur envoie TERM à chaque groupe enregistré, attend jusqu’à 3 secondes, puis envoie KILL.
Il refuse aussi les cibles dangereuses : son propre groupe, celui de Hermes, et tout ce qui a un pgid de 1 ou moins. Il démarre paresseusement au premier enregistrement et sort après 30 secondes d’inactivité, pour qu’une commande au premier plan qui enregistre puis libère son groupe ne laisse pas un /bin/sh derrière elle à chaque exécution.
Deux détails d’ingénierie viennent directement d’échecs en production. Les écritures concurrentes du registre de spawn : trois processus lançant chacun 15 enfants ne conservaient que 18 lignes sur 45, parce que le read-modify-write n’était pas sérialisé ; il prend désormais un verrou de fichier inter-processus qui attend au maximum 2 secondes, si bien qu’un écrivain bloqué ne peut plus figer les autres. Le superviseur tué lui-même : pkill -f hermes l’emporte avec lui, il est donc redémarré en rejouant chaque groupe tant que des enregistrements existent — mais un superviseur qui s’arrête de lui-même dans les 5 secondes suivant son démarrage (installation cassée) n’est pas relancé en boucle.
L’API est réduite : spawn_owned() est l’unique façon de lancer un enfant longue durée (il mène son propre groupe de processus, l’enregistre et le note dans le registre) ; own_process_groups() / release_process_groups() adoptent des groupes lancés par autre chose, comme le SDK MCP ou un harnais de navigateur ; release_process_group_once_empty() ne rend un groupe qu’une fois qu’il ne reste plus rien dedans.
14 familles d’enfants migrées
Voici les chiffres du PR. Le test de chaque ligne tue le propriétaire avec kill -9 et compte ce qui reste vivant ensuite ; chaque ligne dispose d’un propriétaire de contrôle vivant, pour qu’un correctif ne puisse pas passer en tuant tout.
| Famille d’enfants | Avant (main) | Après |
|---|---|---|
| Serveurs MCP stdio | couverts par l’ancien superviseur dédié au MCP | couverts par le superviseur partagé |
| Routeur llama-server et modèles | 2 | 0 |
| Daemons de harnais de navigateur | 2 (et 4 restants après une sortie propre) | 0 (0) |
| Language servers (descendants qui ignorent l’EOF de stdin) | 1 | 0 |
| Sous-processus de code-cell dans le kernel | 3/3 | 0/3 |
| Worker de slash-command | 1 | 0 |
| Commande au premier plan du terminal | 2 | 0 |
| Tâches en arrière-plan du terminal (dans un processus non-gateway) | 3 | 0 |
| Ponts WhatsApp / Raft | 1 / 1 | 0 / 0 |
| Serveur d’app verify / commande TTS-STT | 3 / 3 | 0 / 0 |
| cua-driver embarqué (Linux) | 1 | 0 |
| Pont d’appairage WhatsApp du Dashboard | 1 | 0 |
| Maintenance git bornée (repack, commit-graph) | 2 | 0 |
Il y a aussi un cliquet en CI : scripts/check_detached_spawns.py parcourt les arbres de production et fait échouer le build sur tout nouvel appel de spawn détaché (start_new_session, process_group, os.setsid et compagnie), sauf si la ligne ou la ligne au-dessus porte un marqueur detached-spawn: ok — <why>. La référence de départ est vide. Le correctif ne peut donc pas s’éroder en silence plus tard.
Trois familles sont censées survivre au propriétaire
Un nettoyage uniforme ne signifie pas « tuer tout ». Certains processus sont volontairement conservés :
- Les tâches en arrière-plan de n’importe quel gateway. CLI, TUI, Desktop, ACP, cron et messagerie exécutent tous des outils dans un gateway, et chaque démarrage de gateway appelle
recover_from_checkpoint, qui ré-adopte ses tâches avec leurs journaux de sortie. Tuer votrenpm run dev &parce que le gateway s’est mis en veille serait un désastre, donc seul un processus non-gateway possède ses tâches en arrière-plan. - Les tâches
persist_on_release(#41225) : le nom est le contrat, elles sont faites pour survivre. - L’écran du Bot Desktop. Un écran virtuel par profile, partagé entre les tours, ouvert à une reprise en main humaine, rattaché par un gateway redémarré après une vérification d’identité.
- Plus les passations de l’updater et de
/update, les services gateway/dashboard/launchd eux-mêmes, les workers cron et kanban, le daemon d’egress et un Chrome de/browser connect— des choses qui existent précisément parce qu’elles doivent survivre à leur lanceur. Chacune porte une raison écrite dans le code.
Version courte : ce que vous lancez pour une tâche meurt avec Hermes ; ce que vous avez explicitement demandé à conserver survit.
Vérifier sur votre propre machine
Vous pouvez le vérifier dès aujourd’hui, sans nouvelle version. Prenez un instantané avant de redémarrer le gateway, puis comparez après un kill -9 :
# enfants longue durée que Hermes a tendance à laisser derrière lui
ps -eo pid,ppid,pgid,etime,cmd | grep -Ei 'llama-server|chromium|puppeteer|language-server' | grep -v grep

# ports détenus par ces daemons
ss -ltnp | grep -E ':8080|:9222|:8000'
Un ppid à 1 signifie que init l’a adopté : sur une ancienne version, c’est le signal que le nettoyage n’a jamais eu lieu. Si vous voulez balayer ce qui traîne déjà, le tutoriel agent-janitor présente un plugin tiers qui note les orphelins selon les preuves avant de tuer quoi que ce soit. Les deux sont complémentaires : le superviseur empêche les nouveaux résidus, le janitor nettoie l’historique.
Ce qui change au quotidien
Trois différences concrètes :
- Les redémarrages après un crash sont propres. Plus de
pkill -f llama-serveravant de démarrer, plus de « port already in use » causé par un daemon de la version précédente. - Les modèles locaux arrêtent de brûler du GPU. llama-server et ses enfants modèles se terminent avec la session.
- La courbe de mémoire s’aplatit. Chaque crash laissait des résidus ; une journée entière de redémarrages pouvait coûter des gigaoctets.
Quelques limites à connaître : Windows utilise une autre couche (les job objects) et ne change pas ; seuls les enfants longue durée sont possédés, donc les commandes ponctuelles se comportent exactement comme avant ; et les tâches en arrière-plan d’un gateway peuvent toujours survivre à un gateway tué, par conception et non par oubli.
Statut de publication
Le PR #137057 a été fusionné dans main le 2026-10-29 et figure dans la v0.22.6 (2026-11-02) : une mise à jour suffit, sans installation depuis main. Sur une version ancienne, faites la vérification ci-dessus et associez-la au watchdog de boucle du gateway pour qu’un processus bloqué soit au moins redémarré au lieu de pourrir en silence.
Si vous découvrez une nouvelle famille de résidus sur votre machine — le daemon propre à un plugin, par exemple — cela vaut la peine d’ouvrir une issue. Le code du cœur a désormais un garde-fou en CI ; les plugins dépendent encore de la vigilance de leurs auteurs.