Depois de um kill -9, alguns processos nunca vão embora: agora o Hermes faz cada filho morrer junto com o pai
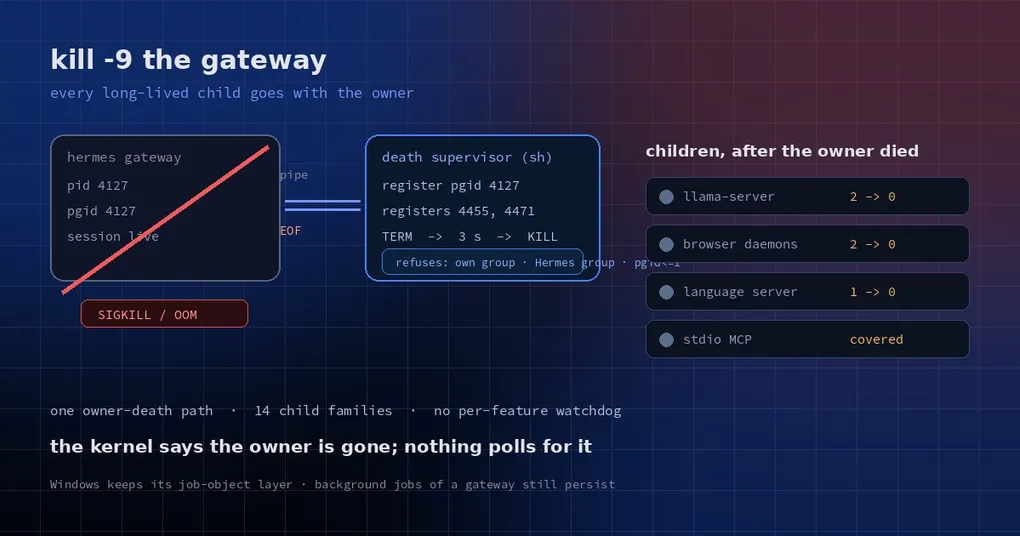
São 2 da manhã, a ventoinha do notebook está gritando e você dá kill -9 no gateway do Hermes que saiu dos trilhos. Na manhã seguinte, ss -ltnp ainda mostra a porta 8080 ocupada, e o ps lista um llama-server, dois daemons de navegador e um language server cujo pai morreu horas atrás. Nenhum deles foi embora. Você mata um por um e se pergunta se amanhã o mesmo ritual se repete.
Isso não é erro de usuário — é assim que o Unix funciona. Quando um processo pai morre, seus filhos são reparentados para o init (PID 1) e seguem vivendo. Para um comando pontual isso é irrelevante. Para algo como o Hermes, que inicia um elenco inteiro de filhos longevos, é um problema de verdade. Uma mudança recente (PR #137057) substituiu uma pilha de gambiarras por recurso por um único mecanismo: quando o dono morre, todo filho longevo que ele iniciou vai junto.
Por que os filhos “esquecem” de morrer
Quase tudo o que um agente faz gera um processo: npm run dev, um daemon de automação de navegador, um roteador de modelos locais, um language server, uma célula de execução de código, um servidor MCP sobre stdio. Esses processos deveriam viver exatamente enquanto durar o processo do Hermes que os iniciou. Por padrão eles não vivem — apenas ganham um pai novo.
A conta chega de formas bem concretas: a memória sobe aos poucos, as portas ficam presas e a próxima inicialização falha, um modelo local continua queimando GPU depois que a sessão acabou, e um daemon antigo briga com o novo pelo mesmo pid file. Depurar é pior ainda: você vê um processo python desconhecido e não faz ideia de quem o iniciou.
O Hermes costumava remendar isso família por família — uma varredura de órfãos na inicialização seguinte, um poller por dono, um watchdog de pid do pai, um death pipe, um hook atexit. Nenhum deles agia no momento em que o dono realmente morria; cada um esperava o próximo boot ou o próximo poll, e cada cópia tinha seus próprios bugs.
Um único pipe avisa que o dono sumiu
O novo desenho mantém exatamente um mecanismo. Todo processo do Hermes segura a ponta de escrita de um pipe; um supervisor (um script POSIX sh, com cerca de 0,5 MB residente quando ocioso, contra 8,1 MB da versão anterior em Python) segura a ponta de leitura. Quando um filho começa, o Hermes registra o grupo de processos dele no supervisor; quando o filho termina normalmente, cancela o registro.
O truque é o EOF. No instante em que o processo do Hermes desaparece — saída limpa, crash, kill -9, o OOM killer, um systemd stop — a ponta de escrita é fechada e o supervisor lê EOF imediatamente. É o kernel avisando que o dono da ponta de escrita não existe mais, e isso não tem como ser ignorado nem perdido. Ao receber EOF, o supervisor manda TERM para todos os grupos registrados, espera até 3 segundos e então manda KILL.
Ele também recusa alvos inseguros: o próprio grupo, o grupo do Hermes e qualquer coisa com pgid 1 ou menor. Sobe de forma preguiçosa no primeiro registro e encerra após 30 segundos ocioso, de modo que um comando em primeiro plano que registra e libera seu grupo não deixa um /bin/sh sobrando a cada execução.
Dois detalhes de engenharia vieram direto de falhas em produção. As escritas concorrentes do spawn ledger: três processos gerando 15 filhos cada um costumavam manter 18 de 45 linhas, porque o read-modify-write não era serializado; agora há um file lock entre processos que espera no máximo 2 segundos, então um escritor travado não congela os outros. O próprio supervisor sendo morto: pkill -f hermes o leva junto, então ele é reiniciado com cada grupo sendo reaplicado enquanto existirem registros — mas um supervisor que sai sozinho em até 5 segundos após subir (instalação quebrada) não entra em loop de reinício.
A API é pequena: spawn_owned() é o único jeito de iniciar um filho longevo (ele lidera o próprio grupo de processos, registra esse grupo e o anota no ledger); own_process_groups() / release_process_groups() adotam grupos que outra coisa iniciou, como o SDK do MCP ou um harness de navegador; release_process_group_once_empty() devolve um grupo só quando não sobrou nada nele.
14 famílias de filhos migradas
Estes são os números do PR. O teste de cada linha mata o dono com kill -9 e conta o que continua vivo depois; toda linha tem um dono de controle vivo, para que uma correção não passe apenas matando tudo.
| Família de filhos | Antes (main) | Depois |
|---|---|---|
| Servidores MCP via stdio | cobertos pelo antigo supervisor exclusivo de MCP | cobertos pelo supervisor compartilhado |
| Roteador llama-server e modelos | 2 | 0 |
| Daemons do harness de navegador | 2 (e 4 sobrando após saída limpa) | 0 (0) |
| Language servers (descendentes que ignoram EOF do stdin) | 1 | 0 |
| Subprocessos de code-cell dentro do kernel | 3/3 | 0/3 |
| Worker de slash command | 1 | 0 |
| Comando em primeiro plano do terminal | 2 | 0 |
| Jobs em segundo plano do terminal (em processo que não é gateway) | 3 | 0 |
| Pontes WhatsApp / Raft | 1 / 1 | 0 / 0 |
| verify app server / comando TTS-STT | 3 / 3 | 0 / 0 |
| cua-driver embutido (Linux) | 1 | 0 |
| Ponte de pareamento do WhatsApp no dashboard | 1 | 0 |
| Manutenção de git limitada (repack, commit-graph) | 2 | 0 |
Há também uma catraca no CI: scripts/check_detached_spawns.py percorre as árvores de produção e quebra o build em qualquer novo detached-spawn (start_new_session, process_group, os.setsid e afins), a menos que a linha ou a linha acima carregue um marcador detached-spawn: ok — <why>. A linha de base está vazia. Ou seja, a correção não pode se degradar silenciosamente depois.
Três famílias devem, por projeto, sobreviver ao dono
Limpeza uniforme não é “matar tudo”. Alguns processos são mantidos de propósito:
- Jobs em segundo plano de qualquer gateway. CLI, TUI, Desktop, ACP, cron e mensageria rodam ferramentas dentro de um gateway, e todo boot de gateway chama
recover_from_checkpoint, que re-adota seus jobs junto com os logs de saída. Matar o seunpm run dev &só porque o gateway ficou ocioso seria um desastre, então apenas um processo que não é gateway é dono dos próprios jobs em segundo plano. - Jobs com
persist_on_release(#41225) — o nome é o contrato; eles existem para sobreviver. - A tela do Bot Desktop. Uma tela virtual por profile, compartilhada entre turnos, aberta a intervenção humana, reconectada por um gateway reiniciado depois de uma checagem de identidade.
- Além do updater e das passagens de
/update, dos próprios serviços de gateway/dashboard/launchd, dos workers de cron e kanban, do daemon de egress e de um Chrome de/browser connect— coisas que existem justamente porque precisam sobreviver ao seu lançador. Cada uma traz o motivo escrito no código.
Resumindo: o que você inicia para uma tarefa morre com o Hermes; o que você pediu explicitamente para persistir, não.
Verificando na sua própria máquina
Você pode comprovar isso hoje, sem release nova. Tire um retrato antes de reiniciar o gateway e compare depois de um kill -9:
# filhos longevos que o Hermes costuma deixar para trás
ps -eo pid,ppid,pgid,etime,cmd | grep -Ei 'llama-server|chromium|puppeteer|language-server' | grep -v grep

# portas que esses daemons seguram
ss -ltnp | grep -E ':8080|:9222|:8000'
Um ppid igual a 1 significa que o init o adotou — em um build antigo, esse é o sinal de que a limpeza nunca aconteceu. Se quiser varrer o que já está lá, o passo a passo do agent-janitor mostra um plugin de terceiros que classifica órfãos por evidência antes de matar qualquer coisa. Os dois se complementam: o supervisor evita sobras novas, o janitor limpa o histórico.
O que muda no dia a dia
Três diferenças práticas:
- Reinícios após crash são limpos. Nada de
pkill -f llama-serverantes de subir, nada de “port already in use” causado por um daemon do build anterior. - Modelos locais param de queimar GPU. O llama-server e seus filhos de modelo terminam junto com a sessão.
- A curva de memória se achata. Todo crash deixava resíduo; um dia inteiro de reinícios podia custar gigabytes.
Limites que vale conhecer: o Windows usa outra camada (job objects) e não mudou; só filhos longevos passam a ter dono, então comandos pontuais se comportam exatamente como antes; e os jobs em segundo plano do gateway ainda podem sobreviver a um gateway morto por projeto, não por descuido.
Status de release
O PR #137057 entrou na main em 2026-10-29 e já está na v0.22.6 (2026-11-02): basta atualizar, sem instalar a partir da main. Em builds antigos, faça a verificação acima e combine com o watchdog de loop do gateway para que um processo travado pelo menos seja reiniciado em vez de apodrecer em silêncio.
Se você encontrar uma nova família de sobras na sua máquina — o daemon de um plugin, por exemplo — vale abrir uma issue. O código principal agora tem uma barreira de CI na frente; os plugins ainda dependem do cuidado de seus autores.