O culpado do OOM das 3h: os processos órfãos que o seu agent deixou
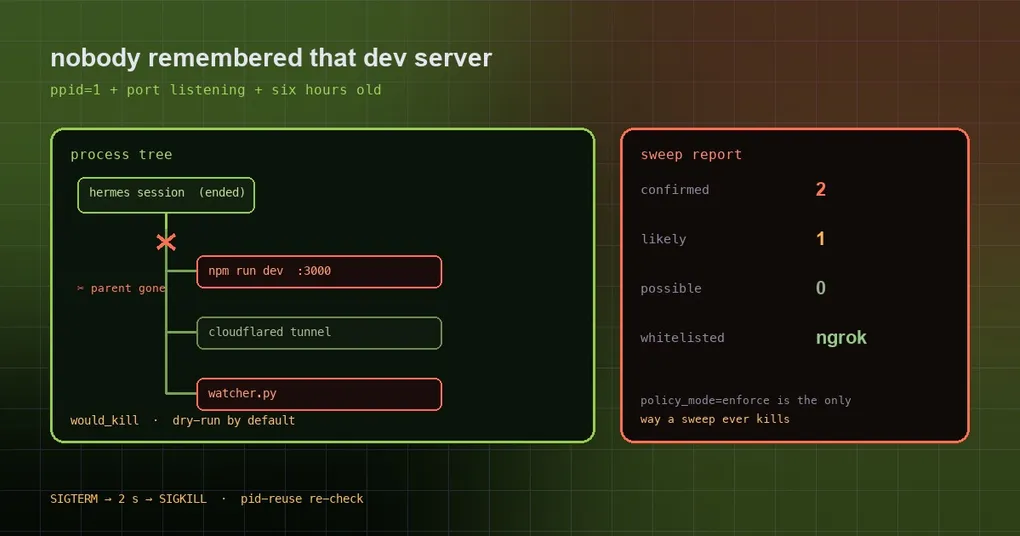
A ventoinha do notebook dispara de novo, o localhost:3000 diz que a porta está ocupada, e o ps aux mostra quatro processos node e python que você não reconhece. No fundo da memória: semana passada você pediu ao agent para “subir um servidor e testar”, a session acabou, o servidor não. O que essas sobras têm em comum é que ninguém se lembra delas e nada presta contas — e esse é exatamente o trabalho do agent-janitor.
De onde vêm os processos órfãos
Uma chamada de tool de um agent se parece muito com você digitando num terminal. Você pede para rodar npm run dev em background, abrir um túnel cloudflared ou anexar um file watcher; o comando retorna e o processo continua vivo. Quando a session termina e o terminal dela vai embora, o Linux re-parenteia o sobrevivente para o PID 1 — é isso que ppid == 1 significa, e é a assinatura de “órfão” mais confiável que existe.
O custo é concreto: portas ocupadas, RAM comida, um OOM às 3h da manhã e, na próxima vez que você sobe o agent, ele não consegue alcançar o próprio serviço. Pior é o custo de triage — você não tem ideia de quem iniciou aquele python app.py.
Ele julga por evidência, não por intuição
O agent-janitor classifica os processos em vez de atirar em tudo que parece suspeito:
| Evidência | Confiança |
|---|---|
| Re-parenteado para o init (ppid=1) e segurando uma porta / traços de dev-server / TTL estourado | confirmed |
| Apenas re-parenteado para o init (ppid=1) | likely |
| Traços de dev e TTL estourado, mas o pai ainda está vivo | possible (nunca varrido automaticamente) |
Tudo o que ele lê é local: ppid e linhas de comando de /proc, sockets em escuta de /proc/net/tcp{,6} e um limite de idade. Só confirmed e likely podem ser mortos.
Duas classes são isentas por nome: daemons de sistema (multipathd, udisksd, ModemManager, systemd-* e companhia) e agents de gestão de host/VM (tailscaled, agents de cloud provider, amazon-ssm-agent, walinuxagent, google_guest_agent). Você adiciona a sua própria infraestrutura a uma whitelist:
janitor whitelist add ngrok
janitor whitelist add cloudflared
janitor whitelist add tmux
As entradas da whitelist são substrings comparadas com a linha de comando (case-sensitive, com regex escapada, sem injeção). Um array vazio ou um arquivo ausente significa que nada está na whitelist.
Instale e escaneie antes de varrer
Ele está no catálogo curado (agent-janitor 0.3.1, nível community, exige Hermes >= 0.21.6). Instale pelo nome se o seu catálogo listar a entrada; caso contrário, a partir do repositório como o README mostra:
git clone https://github.com/ZidoCode/agent-janitor ~/.hermes/plugins/agent-janitor
hermes plugins enable agent-janitor
Agora só escaneie — não limpe nada ainda:
python3 ~/.hermes/plugins/agent-janitor/janitor_cli.py scan
python3 ~/.hermes/plugins/agent-janitor/janitor_cli.py sweep --ttl-h 6
O segundo comando parece assustador, mas é um dry run por padrão: as decisões são impressas e registradas como would_kill, nada morre.
Um único arquivo libera a matança de verdade — <hermes-home>/plugin-data/agent-janitor/policy_mode, cujo conteúdo precisa ser exatamente enforce:
echo enforce > ~/.hermes/plugin-data/agent-janitor/policy_modeEsse design vale ser copiado: seguro por padrão, e o estado arriscado exige uma decisão escrita.
Antes de ativar o enforce, faça estas cinco coisas
- Preencha a whitelist primeiro. Seu túnel, reverse proxy, tmux, qualquer coisa “iniciada pelo agent mas mantida de propósito” entra com
janitor whitelist add. - Leia a saída do dry run como a lista de execução. É exatamente sobre isso que o enforce vai agir, nem mais nem menos.
- Saiba em quem ele acerta. A regra é “re-parenteado para o PID 1 por mais de um minuto, não isento, não na whitelist” — ele não verifica quem iniciou o processo. Um
hermes gatewayrodado comnohupou um servidor tmux está no alvo no modo enforce a menos que você o tenha posto na whitelist, e quando executado como root isso inclui os processos de outros usuários. - Saiba o que ele deixa para trás. O
spawns.jsonlregistra comandos de terminal que pareciam iniciar trabalho em background, e osweeps.jsonlregistra cada decisão (would_killou morto), para você auditar a varredura depois. - Saiba a ordem de kill. SIGTERM, espera dois segundos, SIGKILL — e antes do
kill -9ele relê a linha de comando, abortando se o PID foi reciclado. Nada de fratricídio por reuso de PID.
Combine com o ledger para atribuição
Sozinho, o janitor só consegue dizer “este processo é um órfão”. Com o agent-ledger, do mesmo autor, instalado, ele lê o ledger e transforma um python app.py anônimo em “gerado por esta chamada de tool específica na porta 8080, 12 dias atrás”. A atribuição é aproximada — ele compara pelo basename do executável — então trate como pista, não como prova. O próprio autor a rotula assim.
Três limites que você precisa conhecer
- Só Linux, porque ele lê
/proc. macOS e Windows não são suportados, então num Mac esta ferramenta pertence aos seus servidores, não ao seu notebook. - Suspender o notebook infla o uptime. O uptime é relativo ao boot e continua contando enquanto a máquina dorme, então falsos positivos de TTL são possíveis em máquinas que fecham a tampa. Num servidor — o alvo principal — isso não se aplica.
- A whitelist compara substrings da linha de comando, então um shell na whitelist que depois gera algo perigoso é invisível para ele.
Para reduzir o problema geral de “não sei o que meu agent fez”: o janitor cobre a dimensão de processos, a impressão digital de skills cobre a dimensão de skills, e o cron doctor cobre as tarefas agendadas. Para a rotina geral de instalar e fixar versões, veja o guia do catálogo de plugins.