Job de cron travado não significa mais esperar pelo timeout: o hermes cron cancel para a execução em andamento
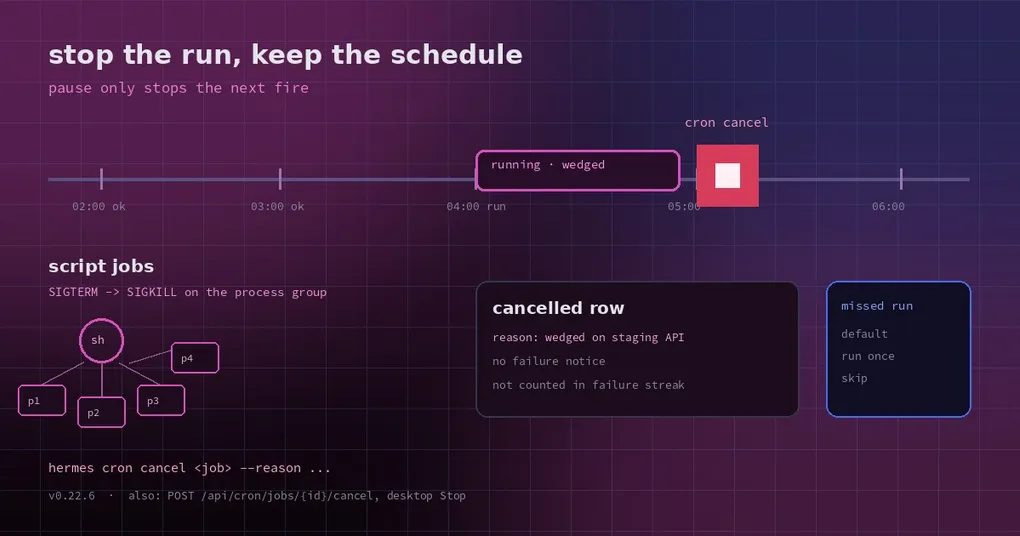
Três da manhã, o celular vibra: um coletor horário está preso numa API upstream que saiu do ar. Ele continua rodando, continua esperando um timeout, continua escrevendo a mesma linha de erro no log. Você abre um terminal e roda hermes cron pause — e descobre que não parou nada. Só significa que não vai haver novo disparo na próxima hora. A execução atual continua ali, queimando tokens linha por linha.
É nessa diferença que as pessoas tropeçam: pause governa o agendamento, não a execução que já está rodando. Antes, suas opções eram "esperar o timeout" ou "apagar o job e recriar". A v0.22.6 acrescenta a terceira: hermes cron cancel.
O que o cancel faz de fato
hermes cron cancel <job_id_or_name>
hermes cron cancel <job_id_or_name> --reason "wedged on the staging API"
A referência do job aceita um ID hexadecimal ou um nome (sem diferenciar maiúsculas de minúsculas). Nomes ambíguos são recusados com a lista dos IDs candidatos, então você não para o job errado por acidente.
O agendamento não é tocado: o job continua habilitado e o próximo disparo acontece como planejado. Só a execução atual muda.
Como ele para depende do tipo de job:
- Jobs de script (
--script, incluindo o modo sem agente): toda a árvore de processos é encerrada —SIGTERMpara o grupo de processos do script, escalando paraSIGKILLdepois de um período de carência, incluindo processos netos em background. É a mesma limpeza que o timeout de um script faz, então nada fica rodando por trás do job. - Jobs de agente: o turno em andamento é interrompido no próximo checkpoint.
Crucialmente, isso é um pedido, não um kill: o cancel é registrado contra o ID de execução daquela run e lido na próxima checagem de cancel da execução (bem menos de um segundo no caso de um script). A execução então grava uma linha cancelled com o seu motivo, então hermes cron runs <job_id> depois mostra "cancelled — travado na API de staging" em vez de deixar um timeout sem explicação ou uma falha seca.
Mais dois detalhes que importam na prática: uma execução cancelada não envia aviso de falha e não conta para a sequência de falhas do job. Algo que você parou de propósito não deveria continuar prejudicando o sinal de saúde do job.
Quatro portas, uma parada
hermes cron cancel <job>(CLI)POST /api/cron/jobs/{id}/cancel(HTTP)- a própria ferramenta
cronjob_managedo agente, comaction: "cancel" - o app desktop: um job com execução em andamento mostra Stop no cabeçalho; ele exibe Stopping… até a linha
cancelledchegar, e então um toast Run cancelled confirma
Remover um job também para a execução em andamento. hermes cron remove (e a exclusão no dashboard/desktop, e a ação remove do agente) cancela uma execução em andamento, registrada como cancelled com o motivo "job removed while running". Antes ela continuava e produzia um resultado que ninguém ia querer.
Cancelar um job que não tem nada rodando é um no-op seguro, que avisa exatamente isso, e um cancel que chega depois de a execução terminar não muda nada.
Uma coisa que ele não faz: desfazer
Seja claro sobre isso. O cancel não desfaz os efeitos colaterais que a execução já produziu — arquivos escritos, APIs chamadas, mensagens enviadas, tudo permanece. Ele para a execução; não restaura o mundo.
Há também um limite de tempo: a interrupção acontece no próximo checkpoint. Se uma chamada de ferramenta está presa num syscall não interrompível, quando ela para depende de quando essa chamada retorna.
A outra metade: o que acontece com um disparo perdido
Assim que você para uma execução, a próxima pergunta vem na hora — se o job venceu enquanto você fazia manutenção, ele se recupera quando o gateway voltar?
Por padrão, sim, uma vez: depois que o gateway volta, um slot perdido dentro da janela de reinício dispara exatamente uma vez, e uma queda longa se resume a uma única execução em vez de uma por slot perdido. Você pode desligar o padrão global:
hermes config set cron.catch_up_missed falseDesde a v0.22.6, um job individual pode sobrescrever a configuração global:
hermes cron create "0 7 * * 1-5" "Morning brief" --catch-up off   # um brief velho é inútil: pule
hermes cron edit <job> --catch-up on                              # sempre rodar uma vez ao voltar
No editor de jobs do desktop isso aparece como Missed runs, com três escolhas: usar o padrão, rodar uma vez ao voltar, pular. A janela de carência padrão é metade do período do job, limitada entre dois minutos e duas horas; --grace-minutes sobrescreve por job (0 significa nunca recuperar, até 1440). A recuperação é visível, não silenciosa: hermes cron list marca como ⚠ late ou ⚠ catch-up after missed fire.
pause, cancel e o pause global
Três comandos são confundidos; a separação é limpa:
hermes cron pause <job>— mantém o job, para de agendá-lo; não toca numa execução em andamento.hermes cron cancel <job>— para apenas a execução atual; o agendamento segue.hermes pause(semcron) — parada de emergência global: nenhum disparo agendado começa em lugar nenhum, mas execuções já em andamento nunca são mortas, e o trabalho vencido se recupera depois dehermes resume.
Para montar um agendamento confiável de ponta a ponta, veja nosso guia completo de automação com cron. Se o seu problema recorrente é "o job deveria ter disparado e não disparou", o post sobre o cron doctor percorre o caminho de diagnóstico, e o post sobre grace-minutes aprofunda a janela de recuperação mencionada aqui.
Tudo acima está na tag v0.22.6 — atualizar já basta para usar.