Ein festgefahrener cron-Job heißt nicht mehr auf den Timeout warten: hermes cron cancel stoppt den laufenden Run
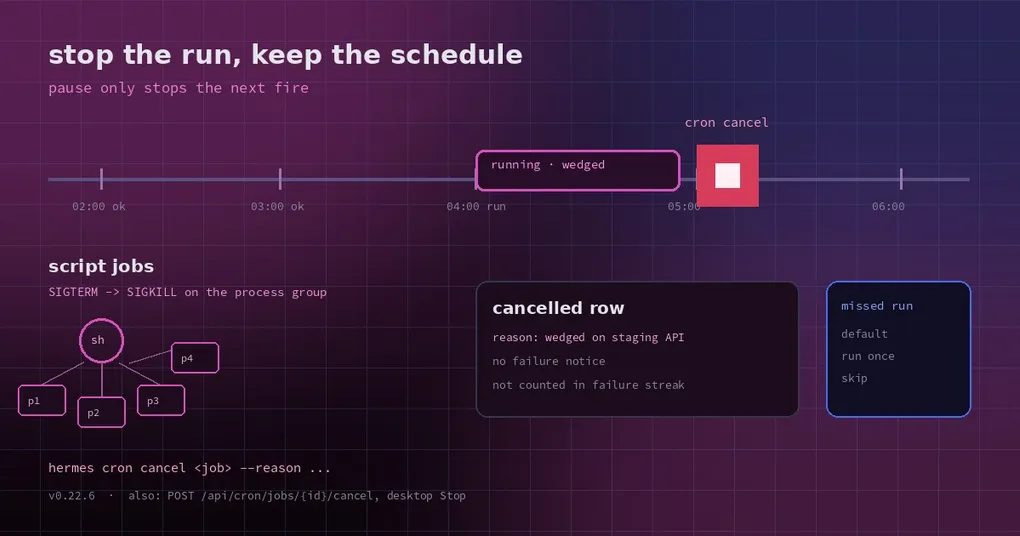
Drei Uhr morgens, dein Handy vibriert: ein stündlicher Collector hängt an einer Upstream-API, die dunkel geworden ist. Er läuft noch, wartet noch auf einen Timeout, schreibt noch dieselbe Fehlerzeile ins Log. Du öffnest ein Terminal und führst hermes cron pause aus — und stellst fest, dass es nichts gestoppt hat. Es bedeutet nur, dass in der nächsten Stunde kein neuer Lauf startet. Der aktuelle Run läuft weiter und verbrennt token Zeile für Zeile.
Das ist der Unterschied, über den Leute stolpern: pause regelt das Scheduling, nicht den bereits laufenden Run. Deine Optionen waren bisher „auf den Timeout warten“ oder „Job löschen und neu anlegen“. v0.22.6 fügt die dritte hinzu: hermes cron cancel.
Was cancel tatsächlich tut
hermes cron cancel <job_id_or_name>
hermes cron cancel <job_id_or_name> --reason "wedged on the staging API"
Die Job-Referenz nimmt eine Hex-ID oder einen Namen (Groß- und Kleinschreibung egal). Mehrdeutige Namen werden mit aufgelisteten Kandidaten-IDs abgelehnt, du kannst also nicht versehentlich den falschen Job stoppen.
Der Schedule bleibt unangetastet: der Job bleibt aktiviert, und sein nächster Lauf findet wie geplant statt. Nur der aktuelle Run ändert sich.
Wie er stoppt, hängt vom Job-Typ ab:
- Script-Jobs (
--script, inklusive no-agent-Modus): der gesamte Prozessbaum wird beendet —SIGTERMan die Prozessgruppe des Scripts, nach einer Gnadenfrist eskaliert zuSIGKILL, in den Hintergrund geschobene Enkelprozesse eingeschlossen. Es ist derselbe Teardown, den ein Script-Timeout ausführt, es bleibt also nichts hinter dem Job zurück. - Agent-Jobs: der laufende Turn wird an seinem nächsten Checkpoint unterbrochen.
Entscheidend: das ist eine Anfrage, kein Kill. Der Cancel wird gegen die Execution-ID dieses Runs vermerkt und beim nächsten Cancel-Check des Runs aufgenommen (bei einem Script deutlich unter einer Sekunde). Danach bucht der Run eine cancelled-Zeile mit deiner Begründung, sodass hermes cron runs <job_id> hinterher „cancelled — wedged on the staging API“ sagt, statt einen unerklärten Timeout oder einen nackten Fehler zu hinterlassen.
Zwei weitere Details, die in der Praxis zählen: ein abgebrochener Run schickt keinen Failure-Hinweis und zählt nicht auf die Failure-Streak des Jobs. Etwas, das du absichtlich gestoppt hast, soll das Health-Signal des Jobs nicht weiter belasten.
Vier Türen, ein Stopp
hermes cron cancel <job>(CLI)POST /api/cron/jobs/{id}/cancel(HTTP)- das
cronjob_manage-Tool des Agent mitaction: "cancel" - die Desktop-App: ein Job mit laufendem Run zeigt Stop in seinem Header; dort steht Stopping…, bis die
cancelled-Zeile landet, dann bestätigt ein Run cancelled-Toast
Einen Job zu entfernen stoppt auch seinen laufenden Run. hermes cron remove (und das Löschen im Dashboard und Desktop, und die remove-Action des Agent) bricht einen laufenden Run ab, gebucht als cancelled mit der Begründung „job removed while running“. Vorher lief er weiter und produzierte ein Ergebnis, das niemand behalten wollte.
Cancel auf einem Job, in dem nichts läuft, ist ein sicherer No-op, der das auch sagt, und ein Cancel, der nach dem Ende des Runs ankommt, ändert nichts.
Eine Sache kann es nicht: zurückrollen
Sei hier klar. Cancel kann Seiteneffekte, die der Run schon ausgeführt hat, nicht rückgängig machen — geschriebene Dateien, aufgerufene APIs, gesendete Nachrichten bleiben alle. Es stoppt den Run; es stellt die Welt nicht wieder her.
Es gibt außerdem eine Timing-Grenze: die Unterbrechung passiert am nächsten Checkpoint. Hängt ein Tool-Aufruf in einem nicht unterbrechbaren Syscall, hängt es davon ab, wann dieser Aufruf zurückkehrt.
Die andere Hälfte: was mit einem verpassten Lauf passiert
Sobald du einen Run stoppst, kommt sofort die nächste Frage — wenn der Job fällig wurde, während du Wartungsarbeiten gemacht hast, holt er das nach, wenn das Gateway zurück ist?
Standardmäßig ja, einmal: nachdem das Gateway wieder da ist, feuert ein Slot, der im Neustart-Fenster verpasst wurde, genau einmal, und ein langes Outage kollabiert zu einem einzigen Run statt zu einem Run pro verpasstem Slot. Du kannst den globalen Default abschalten:
hermes config set cron.catch_up_missed falseSeit v0.22.6 kann ein einzelner Job die globale Einstellung überschreiben:
hermes cron create "0 7 * * 1-5" "Morning brief" --catch-up off   # ein veraltetes Briefing ist wertlos: überspringen
hermes cron edit <job> --catch-up on                              # beim Zurückkommen immer einmal laufen
Im Desktop-Job-Editor heißt das Missed runs mit drei Optionen: Default verwenden, beim Zurückkommen einmal laufen, überspringen. Das Gnadenfenster ist standardmäßig die halbe Periode des Jobs, geklemmt zwischen zwei Minuten und zwei Stunden; --grace-minutes überschreibt es pro Job (0 heißt nie nachholen, bis 1440). Ein Catch-up ist sichtbar, nicht still: hermes cron list markiert ihn mit ⚠ late oder ⚠ catch-up after missed fire.
pause, cancel und der globale pause
Drei Befehle werden verwechselt; die Trennung ist sauber:
hermes cron pause <job>— Job behalten, Scheduling stoppen; fasst eine laufende Ausführung nicht an.hermes cron cancel <job>— nur den aktuellen Run stoppen; das Scheduling läuft weiter.hermes pause(ohnecron) — globaler Not-Aus: kein geplanter Lauf startet irgendwo, aber bereits laufende Runs werden nie gekillt, und fällige Arbeit wird nachhermes resumenachgeholt.
Um einen verlässlichen Schedule von Ende zu Ende zu bauen, sieh dir unseren kompletten Cron-Automation-Guide an. Wenn dein wiederkehrendes Problem „der Job hätte feuern sollen und hat es nicht“ ist, geht der Cron-Doctor-Beitrag den Diagnosepfad durch, und der Grace-Minutes-Beitrag geht tiefer auf das hier erwähnte Catch-up-Fenster ein.
Alles oben Genannte ist im Tag v0.22.6 enthalten — ein Upgrade reicht, um es zu nutzen.