定时任务静默失效的两种方式:线程没启动,和删掉的任务自己回来
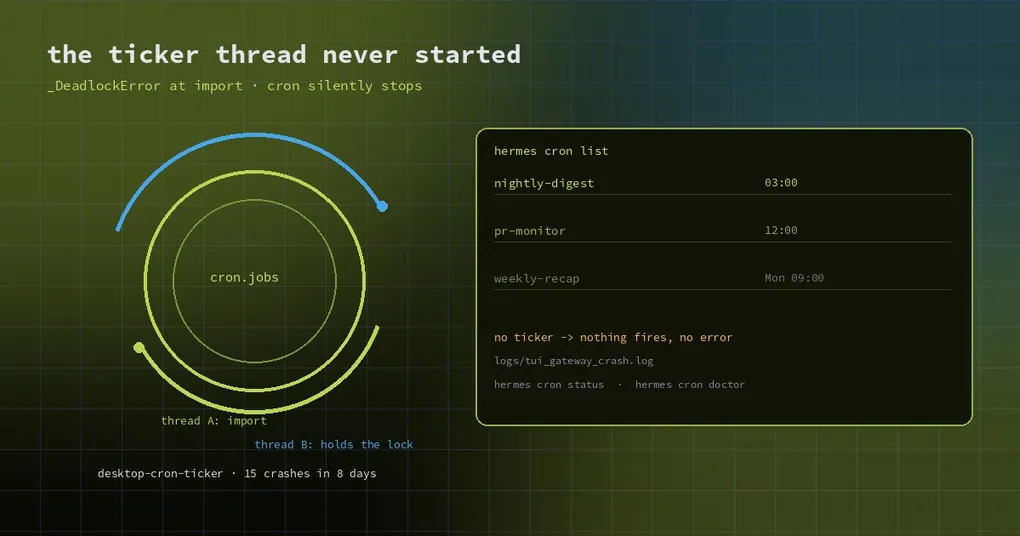
周一早上你打开电脑,周末本该跑的三条定时任务一条都没跑。hermes cron list 里任务都在,状态正常,日志里没有报错,也没有“失败”记录——什么都没发生,因为调度器根本没有运行。
定时任务的失效几乎总是静默的:它不像模型调用失败会重试、会报错、会弹提示,它只是不干活。最近有两起独立报告,正好代表两种最隐蔽的形态:一种是线程从未启动,另一种是你删掉的任务自己长了回来。
形态一:cron 线程在导入时就死了
桌面版的后端(hermes dashboard 进程)里跑着一个进程内 cron ticker,负责在没有 gateway 的情况下也能让定时任务触发。它的入口在 hermes_cli/web_server.py 的 _start_desktop_cron_ticker,第一件事是 from cron.scheduler_provider import ...。
在 Python 3.14 上,这个 import 偶尔会撞上 CPython 的模块导入死锁:
=== thread exception · 2026-10-24 23:23:13 · thread=desktop-cron-ticker ===
  File ".../hermes_cli/web_server.py", line 107, in _start_desktop_cron_ticker
    from cron.scheduler_provider import InProcessCronScheduler, resolve_cron_scheduler
  File ".../cron/__init__.py", line 13, in <module>
    from cron.jobs import (...)
_frozen_importlib._DeadlockError: deadlock detected by _ModuleLock('cron.jobs')关键在最后一行之外:这个异常是在线程的第一条语句里抛出的,所以线程里的重试、降级、告警逻辑一个都没机会跑。ticker 在这个进程里等于不存在,直到进程重启。报告者在一台 macOS 机器上 8 天内撞了 15 次,锁名在 cron.jobs 和 cron.executions 之间跳。
为什么它特别难发现?因为同一个安装里通常还有一个 launchd(或 systemd)托管的 gateway 也在 tick cron 存储,于是任务照常触发,桌面端的死线程毫无症状。只有当“桌面后端是唯一调度者”时——单机、只开 App、没有独立 gateway——才会变成真正的定时任务停摆,而且是静默停摆。
好消息是它有痕迹:崩溃日志在 ~/.hermes/logs/tui_gateway_crash.log,搜 thread exception 和 desktop-cron-ticker 就能找到。这个线程死锁已被记进更早的追踪条目(#134889 的 Lane 3),修法方向也是现成的:把 cron 存储的导入放到主线程、在 ticker 线程创建之前完成,用一个单线程的导入阶段把竞态消掉。
形态二:删掉的定时任务被写回磁盘
第二种更气人:你执行了 hermes cron remove <id>,hermes cron list 里确实没了,两次手动检查都干净。过了一天,它又出现在磁盘上——字节级完全一样,包括 created_at、state=completed、last_run_at。一个已经完成的一次性任务,没有任何路径会重新创建它,所以这只可能是某个“记得它还在”的写入者把自己内存里的旧副本刷回了磁盘。
机制在 cron/jobs.py 的合并逻辑里。_merge_unexpected_disk_jobs / _unmerged_disk_jobs 会保护“磁盘上有、但这次保存没有”的行——这是创建方向的保护,而且会写日志(#80624 加的守卫)。但删除方向(保存里有、磁盘上没有)是无条件写回的,也没有日志。一个在删除之前加载过 jobs.json 的长生命周期写入者,收尾时把整个 store 保存回去,删除就被静默撤销了。
报告里这次事故的代价很具体:那条复活的一次性任务指向一个已经退役的脚本,把一个夜间套件又跑了一遍,触发了两个监控告警和一次 RCA。它发生在 15 个 cron store、一个复用 gateway 的多 profile 环境里——写入者越多,撞上的概率越高。
提出的修法是“删除墓碑”:任何带 removed_ids 的保存,把这些 id 加删除时间写进每个 store 旁边的 cron/jobs.removed.json;之后所有合并式保存都从载荷里减掉墓碑里的 id(除非某行的 created_at 晚于删除时间,允许 id 回收后重建),并且这次要写日志。用旁挂文件而不是 jobs.json 里的元数据,是为了让 replace=True 的修复路径和外部整文件重写都抹不掉删除意图。
出问题时按这个顺序查
三条命令加一个文件,基本能定位到是哪一类:
hermes cron status        # 调度器到底在不在跑
hermes cron doctor        # 常见健康问题体检
hermes cron runs          # durable 执行记录:有没有真的跑过
hermes cron incidents # 失败事件的持久记录再加一条人工检查:~/.hermes/logs/tui_gateway_crash.log 里搜 thread exception。如果 status 说没有调度器、runs 里最近几天一片空白,而崩溃日志里有 desktop-cron-ticker,那就是形态一。如果任务跑过、或者任务“莫名回来了”,看 jobs.json 里那一行的 created_at 和 last_run_at 是否与你知道的一致——那是形态二。
四条预防措施
- 一个 store 只有一个调度者。 桌面后端、launchd gateway、systemd 服务同时 tick 同一个 store,是“看不见的写入者”最主要的来源。留一个,其余停掉。
- 删完等一轮再确认。
hermes cron remove之后,过几分钟(或重启一次调度器)再看hermes cron list,比当场看更可靠——竞态发生在收尾保存,不在删除那一刻。 - 重要任务别只靠 cron 一个信号。 让任务自己往外部发一条“我跑完了”(webhook、消息、写一行文件),比事后查
hermes cron list可靠得多。 - 升级后第一件事是
hermes cron status。 尤其是 Python 版本变了、或者换了调度方式之后。
一句总结
定时任务的失败没有声音,所以你必须主动去听。线程有没有起来、任务有没有真跑、删掉的东西有没有留在磁盘上——这三件事都各有一个廉价检查。把检查做成习惯,比等周一早上发现全都没跑要好得多。