Duas formas de o cron falhar em silêncio: uma thread que nunca inicia e um job que volta
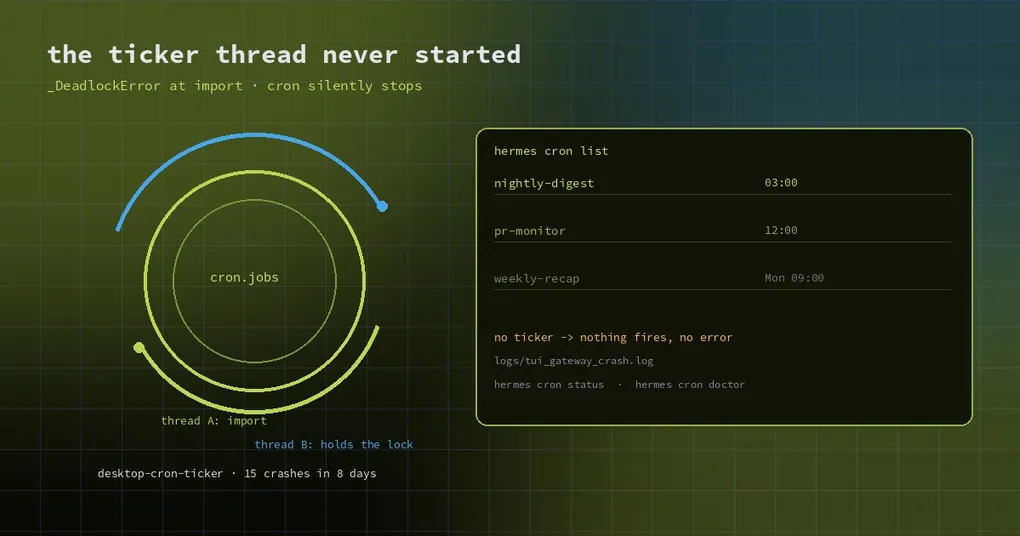
Segunda-feira de manhã. Os três jobs que deveriam ter rodado no fim de semana não rodaram. O hermes cron list mostra todos, saudáveis, e o log não tem erros nem falhas — nada aconteceu, porque o scheduler não estava rodando.
Falhas de cron são quase sempre silenciosas. Uma chamada de modelo tenta de novo, levanta exceção, notifica; um scheduler que nunca dá tick simplesmente não trabalha. Dois relatos independentes desta semana cobrem as versões mais discretas: uma thread que nunca inicia e um job que você apagou e que volta sozinho.
Modo um: a thread do cron morre durante o import
O backend desktop (o processo hermes dashboard) roda um ticker de cron in-process para que jobs agendados ainda disparem quando não há gateway por perto. Seu ponto de entrada é _start_desktop_cron_ticker em hermes_cli/web_server.py, e sua primeira instrução é from cron.scheduler_provider import ....
No Python 3.14 esse import às vezes esbarra no deadlock de import de módulos do CPython:
=== thread exception · 2026-10-24 23:23:13 · thread=desktop-cron-ticker ===
  File ".../hermes_cli/web_server.py", line 107, in _start_desktop_cron_ticker
    from cron.scheduler_provider import InProcessCronScheduler, resolve_cron_scheduler
  File ".../cron/__init__.py", line 13, in <module>
    from cron.jobs import (...)
_frozen_importlib._DeadlockError: deadlock detected by _ModuleLock('cron.jobs')
O detalhe crucial não está no trace: a exceção é levantada dentro da primeira instrução da thread, então a lógica de retry, fallback e alerta nunca chega a rodar. O ticker não existe naquele processo até ele reiniciar. Um dos relatos bateu nisso 15 vezes em oito dias no macOS, com o lock alternando entre cron.jobs e cron.executions.
O que torna isso difícil de notar é um segundo scheduler. A maioria das instalações também roda um gateway gerenciado por launchd ou systemd que dá tick no mesmo store de cron, então os jobs continuam disparando e a thread morta não deixa sintoma. Só quando o backend desktop é o único scheduler — máquina única, só o app, sem gateway separado — isso vira uma queda de cron real e completamente silenciosa.
Ele deixa um rastro: ~/.hermes/logs/tui_gateway_crash.log, procure por thread exception e desktop-cron-ticker. O deadlock está rastreado numa entrada umbrella anterior (#134889, Lane 3), e a direção da correção é direta: importar o store de cron na main thread antes de a thread do ticker existir, para eliminar a corrida em vez de estreitá-la.
Modo dois: um job apagado é escrito de volta no disco
O segundo modo é mais insultante. Você roda hermes cron remove <id>, o job some do hermes cron list e duas checagens manuais confirmam que ele se foi. Um dia depois ele está de volta no disco, idêntico byte a byte — mesmo created_at, mesmo state=completed, mesmo last_run_at. Nenhum caminho de código recria um job one-shot concluído, então a única explicação é um writer que carregou o store antes da remoção e despejou sua cópia em memória depois.
O mecanismo está em cron/jobs.py. _merge_unexpected_disk_jobs / _unmerged_disk_jobs protegem linhas que existem no disco mas faltam no payload de um save — essa é a direção create, e ela registra log (a guarda adicionada para #80624). A direção delete (linhas do payload que sumiram do disco) é escrita de volta sem condição, sem uma linha de log. Um writer de vida longa que carregou o jobs.json antes da sua remoção salva o store inteiro no fim do trabalho, e a remoção é desfeita em silêncio.
O custo no relato foi concreto: o job one-shot ressuscitado apontava para um script aposentado, rodou de novo uma suíte noturna e gerou duas páginas de monitoramento mais um ciclo de RCA. Aconteceu num ambiente com 15 stores de cron atrás de um gateway multiplexado — quanto mais writers, mais provável a corrida.
A correção proposta são tombstones de remoção: qualquer save que carregue removed_ids também persiste esses ids com um timestamp de remoção num sidecar por store, cron/jobs.removed.json; cada save que faz merge então subtrai os ids de tombstones recentes do seu payload, a menos que o created_at da linha seja posterior à remoção (para que uma recriação legítima com id reciclado continue funcionando) — e desta vez registra log. Um sidecar em vez de uma chave de metadados no jobs.json, para que reparos com replace=True e reescritas externas do arquivo inteiro não consigam apagar a intenção de remover.
Como fazer o triage na ordem certa
Três comandos e um arquivo normalmente identificam em qual modo você está:
hermes cron status        # is a scheduler actually running
hermes cron doctor        # common health problems
hermes cron runs          # durable execution attempts: did anything run
hermes cron incidents     # persisted failure incidents
Depois confira à mão: procure thread exception em ~/.hermes/logs/tui_gateway_crash.log. Se o status não reporta scheduler, o runs está vazio há dias e o crash log menciona desktop-cron-ticker, é o modo um. Se o job rodou, ou se um job “voltou”, compare o created_at e o last_run_at dessa linha no jobs.json com o que você sabe — é o modo dois.
Quatro hábitos que evitam os dois
- Um scheduler por store. Um backend desktop, um gateway launchd e um serviço systemd dando tick no mesmo store é a principal fonte de writers invisíveis. Fique com um.
- Confirme remoções depois de um tick, não na hora. Confira o
hermes cron listde novo alguns minutos depois, ou após reiniciar o scheduler. A corrida acontece num save de fechamento, não no momento da exclusão. - Não deixe o cron ser o único sinal. Faça os jobs importantes reportarem a conclusão em algum lugar externo — um webhook, uma mensagem, uma linha num arquivo. Isso vale mais do que ler o
hermes cron listdepois do fato. - Rode
hermes cron statusdepois de cada atualização, especialmente quando a versão do Python ou a topologia de agendamento mudou.
A versão curta
Jobs agendados falham sem fazer barulho, então você precisa escutar de propósito. Um scheduler está rodando, o job rodou de fato, uma linha apagada ainda está no disco — cada uma dessas perguntas tem uma checagem barata. Transforme as checagens em hábito e as segundas-feiras deixam de ser surpresa.
Leitura relacionada: o guia de health-check de cron, cancelar uma execução em andamento, continuidade de memória entre execuções de cron, o que mais existe na janela da v0.22.7.