Jede Session friert gleichzeitig ein, das Log bleibt sauber: Hermes holt acht gemessene Blocker vom Event Loop
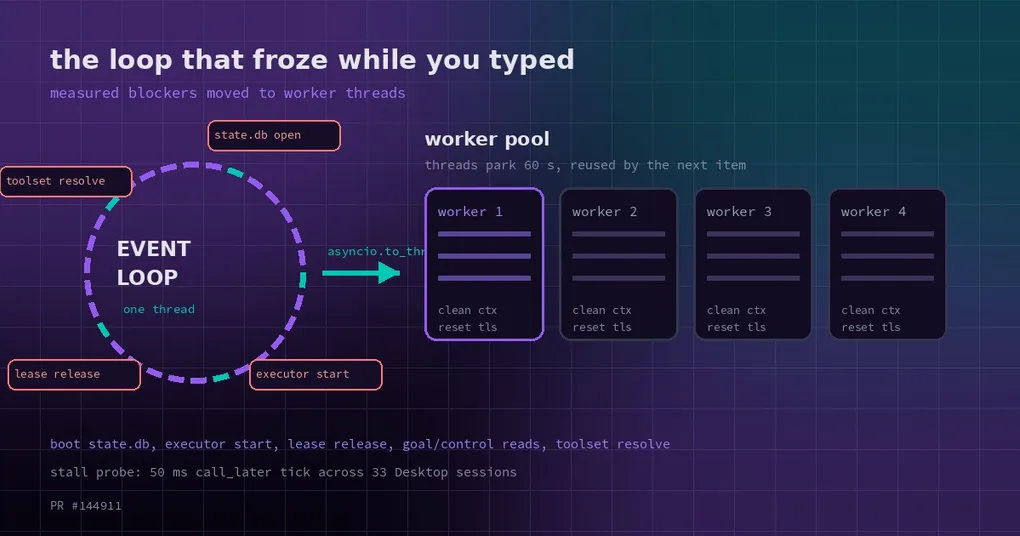
Es ist Mittwochnachmittag, und du bist mitten in einem Satz in Desktop, als das Fenster nicht mehr reagiert: Der Cursor blinkt weiter, aber es kommt nichts an, und die Session-Liste in der Seitenleiste hängt mitten im Scrollen. Du wartest dreißig Sekunden, und es läuft von selbst wieder an — oder du startest neu und es läuft so wieder an. Dann öffnest du das Log, um zu sehen, was passiert ist, und da steht nichts: keine Warnung, keine einzige Zeile. Es war nicht das Modell und nicht das Netzwerk: Das Desktop-Backend, also das Gateway, läuft auf einem single-threaded asyncio Event Loop, und alles, was auf diesem Thread auf die Festplatte wartet, lässt jede Session mitwarten.
Der Event Loop ist ein Kassierer, vor dem alle Sessions anstehen
Das Gateway ist der Prozess hinter Desktop. Ihm gehören die Session-Ablage, die Tool-Aufrufe, cron und die state.db jedes Profils. Es startet nicht einen Thread pro Aufgabe. Es nutzt asyncio, um sich auf einem einzigen Thread abzuwechseln — einen WebSocket-Frame lesen, ein Token schieben, eine Session schreiben, ein Tool ausführen — immer eins nach dem anderen, jedes schnell genug, dass es parallel wirkt.
Dieses Modell ruht auf einer Annahme: Jeder dieser Durchgänge muss schnell sein. In dem Moment, in dem einer davon auf die Festplatte wartet — eine Datenbank öffnen, einen File-Lock nehmen, einen JSON-Blob neu schreiben — steht der Thread still und sonst passiert nichts. Deine Tastendrücke werden nicht mehr gespiegelt, eine streamende Antwort stirbt mitten im Satz, ein fälliger cron-Job feuert nicht. Der Kassierer ist im Lager und sucht Ware. Und blockierende I/O wirft keine Exception: Sie ist einfach langsam. Deshalb ist das Log sauber, und deshalb ist diese Art von Hänger so schwer zu belegen.
Die andere Hälfte der Geschichte — was einen Loop einfängt, der schon hängt — steht in der Analyse zum Gateway-Loop-Watchdog. Hier geht es darum, warum er hängt.
Acht Blocker, alle gemessen
PR #144911 (gemergt am 2026-10-27, Merge-Commit b63fbbac4d27d1e4b8585ff7065e6dceb6207394) hat nicht geraten. Hinter jedem der acht steht ein Pfad, den jemand reproduzieren konnte, und zusammen schließen sie #141966, #142085 und #142061.
-
Session-Reads warteten bis zu 5 Sekunden auf den Token-Writer (#141966).
get_session,list_sessions_rich,get_recent_session_model_routeundlist_gateway_sessionssind reine Lesezugriffe, aber sie warteten auf einen Writer, der gerade ein Token persistierte — im schlimmsten Fall fünf Sekunden. Der Fix gibt Reads einen eigenen Flush-Modus: Auf dem Loop-Thread wartet er nie, außerhalb des Loop-Threads wartet er wie bisher. Nur ein Warten auf dem Loop-Thread kostet allen anderen ihre Zeit, um die eigene zu sparen. -
Die Liveness-Probe hielt den GIL unter Windows (#142085, von Community-Mitwirkendem @zwmaupin). Eine psutil-Probe kann unter Windows den Interpreter-Lock so lange halten, dass der Loop-Thread ihn nicht bekommt — ein Vollstopp für den Event Loop. Dieser Punkt wurde aus @zwmaupins Fork gerettet, die Autorschaft bleibt erhalten.
-
Der Start öffnete die
state.dbjedes Profils auf dem Loop. Jedes Öffnen baut das Schema und den FTS-Index auf — grob eine Sekunde pro Store — und das lief früher auf dem Loop-Thread, also bedeutete mehr Profile eine längere Totzeit beim Start. Jetzt öffnetopen_profile_storein einem Thread, mit dem Profil-Scope in diesem Thread gebunden, sekundäre Profile wärmen parallel vor, und der Store, den der Start tatsächlich braucht, wird von einem Worker umGatewayRunner()festgehalten, sodass das Öffnen des Stores nur noch ein Registry-Treffer ist und die Datei nie anfasst. -
Jeder Executor-Submit startete einen neuen Thread auf dem Loop (#142061).
Thread.start()wartet auf den GIL, heißt: Das Weitergeben von Arbeit kostete selbst Loop-Zeit. Das ist der interessanteste der acht und bekommt unten einen eigenen Abschnitt. -
Das Laden des Goal/Loop-Managers und der Control-Card-Snapshot nach jedem Turn lesen beide
state.db, beide auf dem Loop. -
Die Auflösung von Display/Toolset pro Turn nahm den File-Lock des Auth-Stores. Läuft jetzt über
asyncio.to_thread, wobei der kopierte Kontext den Profil-Scope dieses Turns mitführt. -
restore_local_sessionwartete aufstore._lockbei Live-Sessions. Ein Worker, der instate.dbschreibt, hält diesen Lock, also konnte das Wiederherstellen einer Session den ganzen Loop dahinter aufhängen. Der Fix fand ein präzises Loch: Wenn die Route bereits ein Ziel nennt und dieses Ziel in der Lineage liegt, tut der gelockte Zweig überhaupt nichts — dieser Fall kehrt jetzt zurück, ohne den Lock zu nehmen. -
Das Freigeben des Active-Session-Lease am Ende jedes Turns machte einen File-Lock plus ein JSON-Rewrite. Ebenfalls vom Loop weg.
Sechs der acht waren „auf dem Loop die Festplatte anfassen“, eine war „auf dem Loop um den GIL kämpfen“, eine war „auf dem Loop einen Thread starten“. Wenn du eine Regel daraus mitnimmst: Nichts, was warten kann, gehört auf den Loop-Thread.
Einen Thread für 60 Sekunden parken
Punkt 4 lohnt ein genaueres Hinsehen, weil er keinen Aufruf verschiebt — er ändert das Verhalten eines Pools.
Der Executor war früher einfach: Eine Aufgabe kommt an, ein Thread startet, der Thread wird fertig und stirbt. Der Pool ist per Design unbegrenzt (dieser Vertrag und das OS-Thread-Limit bleiben unverändert), also startete und begrub er unter Last fortlaufend Threads, und jedes Thread.start() stellte sich auf dem Loop-Thread hinter dem GIL an.
Jetzt stirbt ein Worker, der fertig wird, nicht. Er parkt für 60 Sekunden (_IDLE_TIMEOUT_S = 60.0 im Code). Der nächste Submit übergibt seine Aufgabe über eine Queue an einen geparkten Worker; ein Thread entsteht nur, wenn kein Worker geparkt ist. Der Pool bleibt unbegrenzt, der Vertrag hält, und im eingeschwungenen Zustand werden fast gar keine Threads mehr erzeugt.
Die Gefahr beim Wiederverwenden eines Threads ist übrig gebliebener Zustand: eine contextvar, ein Interrupt-Flag, ein Thread-Local vom vorherigen Job, das still den nächsten steuert. Genau dort steckt der Großteil der Sorgfalt in dieser Änderung. Jede Aufgabe läuft in einem leeren contextvars.Context, und gateway/turn_thread_reset.py räumt die Reste dieses Threads ab:
- das
tools.interrupt-Bit des Threads; - Grund und Yield des Turns;
- den Thread-Scope des sudo-Cache;
- den
threading.local-Namespace pro Turn.
Ein Worker, dessen Reset fehlschlägt, geht in Rente statt weitere Arbeit zu nehmen — lieber ein Thread zu wenig als schmutziger Zustand, der in den nächsten Turn leckt. _threads listet weiterhin nur beschäftigte Threads, die Drain-Zählung beim Shutdown bleibt also unberührt.
Spät ist in Ordnung. Durcheinander nicht.
Die Kosten, die man beim Verlagern von Arbeit in Threads vergisst, sind die der Reihenfolge. An drei Stellen wurde hier darum herum gebaut.
Ticketnummern für Snapshots. Der Control-Card-Snapshot wird jetzt in einem Worker gelesen und asynchron veröffentlicht, aber publish_async zieht zuerst ein Ticket auf dem Loop. Ein Snapshot, der spät ankommt und inzwischen von einer neueren Veröffentlichung überholt wurde, wird verworfen, sodass die UI nie alte Daten über neue gemalt bekommt. Das Republish pro Tool bleibt synchron, weil test_session_viewer_automation verlangt, dass es innerhalb eines einzigen Loop-Schritts fertig wird.
Ein geordneter Worker für die Lease-Freigabe. Jede Freigabe (File-Lock plus JSON-Rewrite) geht an denselben geordneten Worker. Kommt eine Freigabe nach dem nächsten Acquire auf derselben Session an, tut sie nichts — Einträge werden anhand der Lease-ID verworfen, eine späte Freigabe kann den Turn, der den Slot gerade übernommen hat, also nicht überschreiben. Der Module-Docstring in gateway/active_lease_io.py benennt die Grenze ausdrücklich: Nur der Dateischreibvorgang wird verzögert, der Lease ist aus Sicht dieses Prozesses bereits freigegeben, wenn release_soon zurückkehrt, sodass der nächste Claim den Slot weiterhin frei sieht; alle Freigaben durch einen Worker zu leiten ist das, was das persistierte Verwerfen in der Reihenfolge der Turn-Abschlüsse hält; und der Registry-Pfad steht zum Zeitpunkt des Acquire fest, der Worker braucht also keinen Profil-Scope.
Kopierte Kontexte tragen den Profil-Scope. Das to_thread aus Punkt 6 ist kein nackter Aufruf — der kopierte Kontext führt den Profil-Scope dieses Turns mit, sonst würde die Display/Toolset-Auflösung im Thread auf das Standardprofil zurückfallen.
Der gemeinsame Faden: Verzögern ist nur dort sicher, wo das Ergebnis auf denselben Zustand zuläuft. Wo Reihenfolge Bedeutung trägt, zieh ein Ticket oder stell dich an.
Wie man es prüft: miss, wie lange der Loop stand, nicht wie langsam eine Anfrage war
Diese Fehlerklasse findest du nicht über Latenz pro Anfrage. Unter Last sieht jede Anfrage bloß langsam aus, während die Nutzererfahrung ist, dass alles gleichzeitig stehen bleibt. Der Messaufbau im PR ist es wert, kopiert zu werden:
Ein echtes gateway run --force im Multiplex-Modus, 11 Profile, 33 gleichzeitige WebSocket-Sessions in Desktop-Form, ein cron-Job pro Profil pro Minute und ein Loopback-Provider für Tool-Aufrufe. Zwei Probes per sitecustomize injiziert: eine Loop-Latenz-Probe mit call_later alle 50 ms und ein Stall-Sampler, der Stacks aufnimmt, wenn der Loop aufhört durchzulaufen — so siehst du, wer wartet. Jede Runde läuft 90 Sekunden, wobei PYTHONPATH den Code-Baum festnagelt, damit du auch den Code misst, den du messen wolltest. Stall-Sekunden = Main-Loop-Stall-Samples × 20 ms.
Der Sinn dieses Aufbaus sind nicht die Zahlen. Er misst, wie lange der Loop nicht durchgelaufen ist, und genau das spüren deine Finger.
Triage läuft genauso. Wenn nur das Tippen stockt, während Antworten weiter ankommen, ist das der Rendering-Pfad — siehe warum das Tippen in langen Sessions schlechter wird. Wenn Tippen und Antworten gemeinsam stoppen, nach zig Sekunden von selbst zurückkommen und ein sauberes Log hinterlassen, war der Loop belegt. Und wenn der langsame Moment der Start ist, ist das ein drittes Problem, behandelt in Startlatenz und Scratch-Cleanup.
Welche Versionen, und was jetzt zu tun ist
Der Fix ist am 2026-10-27 in main gemergt. Wenn du dem Stable-Kanal folgst, erreicht er dich mit dem nächsten Release, das ihn enthält; wenn du ihn heute willst, stelle auf main um. Von den drei Issues ist #142085 der, den Windows-Nutzer sofort wiedererkennen — ein Tool-Aufruf startet und die ganze UI wird hölzern, das ist die Signatur.
Bis dahin gibt es dem Loop etwas mehr Luft: weniger langlebige Desktop-Fenster (jedes ist eine WebSocket-Session, die fortlaufend Nachrichten schiebt), cron für Profile abschalten, die du nicht nutzt, und nicht Dutzende gleichzeitige Sessions auf einem Gateway stapeln. Die Testumgebung für diesen PR waren 11 Profile mit je 3 Sessions — das ist bereits der Stressfall.
Der Fingerabdruck dieser Art von Hänger
Ein langsames Modell und ein stehender Loop fühlen sich völlig unterschiedlich an, und sie auseinanderzuhalten ist der größte Teil des Debuggens. Langsames Modell: Token kommen einzeln an, die UI bleibt bedienbar, du kannst tippen und Sessions wechseln. Stehender Loop: Jede Session friert gleichzeitig ein, auch die, die gar kein Modell aufrufen; das Log hat keine Fehler, weil Blockieren keine Exception ist; und es erholt sich von selbst, weil die Festplattenoperation irgendwann fertig wurde.
Der dritte Fall ist der unangenehmste, weil er nicht langsam ist — er steht. Und ein stehender Event Loop sieht genau wie eine kaputte Maschine aus, dabei wartete er nur auf einen einzigen Dateischreibvorgang. Diese Änderung schickt diesen Schreibvorgang woandershin zum Warten.