Una respuesta en chino acabó siendo el title de la session: el guard de longitud solo cuenta espacios
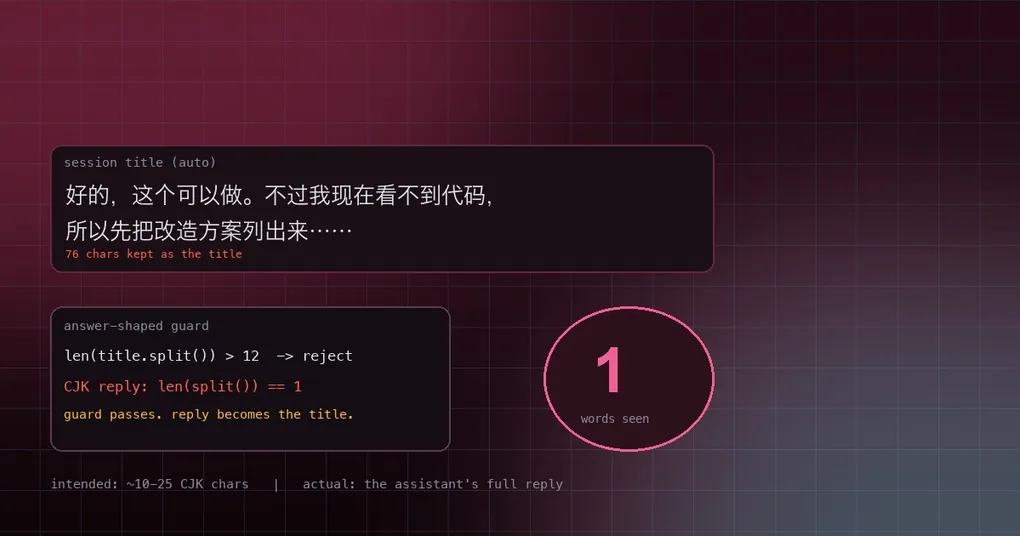
Cambias de modelo, abres unas cuantas sessions nuevas y luego vas a buscar aquella en la que hablaste del plan de despliegue. La barra lateral muestra una frase completa: 好的,这个可以做。不过我现在看不到代码,所以先把改造方案列出来…. Eso no es un title, es la respuesta del modelo. Y todas las sessions nuevas tienen el mismo aspecto, estirando la lista pantalla abajo.
Esto es más que un modelo charlatán. El modelo sí ignoró la instrucción de devolver un title corto, pero Hermes tiene un guard construido justo para ese fallo: simplemente no sabe contar chino. El problema se reportó el 20 de octubre de 2026 (issue #141969). Aquí tienes el mecanismo, la evidencia y tres workarounds que funcionan hoy.
Cómo se genera un title
Los titles se generan en dos pasos. Primero llega un title instantáneo, derivado localmente de tu mensaje inicial sin llamar a ningún modelo. Después llega la mejora por modelo: una llamada en segundo plano recibe una previsualización de la conversación y se le pide devolver un title corto en un campo JSON.
El paso dos normalmente se porta bien. Pero los modelos charlatanes a veces ignoran el formato y le contestan al usuario, devolviendo una respuesta entera como contenido del campo. Eso es lo que el código llama salida con forma de respuesta.
El punto ciego: len(title.split())
Para atrapar eso, agent/title_generator.py tiene un techo sencillo:
_MAX_TITLE_WORDS = 12
...
# Guard de salida con forma de respuesta: un title con muchas palabras es un
# modelo que ignoró la tarea y le contestó al usuario.
if title is not None and len(title.split()) > _MAX_TITLE_WORDS:
    return None
La lógica es razonable: un title de verdad no pasa de doce palabras, mientras que una respuesta suele ir mucho más allá. El problema es str.split(), que parte por espacios en blanco. El inglés, el alemán y el francés delimitan palabras y se comportan; el chino, el japonés y el coreano no, así que una frase entera se tokeniza en una, tres, quizá ocho “palabras”.
Las mediciones del issue vienen directamente de un state.db real:
| Qué se guardó como title | chars | len(split()) |
guard de 12 palabras |
|---|---|---|---|
好的,这个可以做。不过我现在看不到 hermesbubble 的代码… |
76 | 3 | pasa |
可以,直接在这说。先判断一个关键点:登录页本身能打开吗? |
32 | 1 | pasa |
先确认一下:你说的 Hermes 是哪个项目/镜像? |
80 | 8 | pasa |
我是 ChatGPT,由 OpenAI 开发。当前对话里没有提供… |
73 | 4 | pasa |
En la misma máquina, las sessions antiguas creadas antes del cambio de provider tenían todas titles correctos de 17–24 caracteres. Dicho de otro modo: en idiomas delimitados por espacios el guard funciona; en chino, a efectos prácticos, no existe. En un aspecto es peor que inútil: la respuesta aceptada se persiste con title_source='llm', indistinguible de un title real salvo porque tú te acuerdas de lo que era.
La dirección propuesta
El issue propone hacer el guard consciente del sistema de escritura: mantener el conteo de palabras para texto delimitado por espacios y añadir un techo de caracteres para las secuencias CJK. Un title suele tener 10–25 caracteres chinos, mientras que una respuesta pasa de 40, así que 30 deja margen para un title con varias cláusulas:
_MAX_TITLE_WORDS = 12
# El CJK no tiene espacios, así que len(split()) cuenta muy por debajo. Un title
# también es corto en caracteres; una respuesta no. ~30 deja sitio para un title
# real con varias cláusulas.
_MAX_TITLE_CJK_CHARS = 30

def _cjk_char_count(text: str) -> int:
    return sum(1 for ch in text if
               "\u4e00" <= ch <= "\u9fff"      # ideogramas unificados CJK
               or "\u3040" <= ch <= "\u30ff"   # hiragana/katakana
               or "\uac00" <= ch <= "\ud7a3")  # hangul
Para que quede claro el estado: a día de hoy ese issue sigue abierto y no se ha mergeado ningún patch. Así que lo que viene son workarounds que puedes usar ya, no una nota de release.
Tres cosas que puedes hacer ahora
Una: renombrar la session. hermes sessions rename acepta un id de session y el title nuevo:
hermes sessions rename 8f3c1d2a "deploy plan discussion"Para el historial que ya se quedó con una frase como title, esto lo arregla de uno en uno. Los ids de session salen de hermes sessions list, y basta con un prefijo.
Dos: quedarte con el title instantáneo y cortar la mejora por modelo. El title instantáneo se deriva de tu propio mensaje, así que es corto por construcción. Desactiva la llamada al modelo en segundo plano:
hermes config set auxiliary.title_generation.model_upgrade_enabled falseEl precio son titles más planos: reflejan tu primera frase en lugar de resumir la conversación.
Tres: desactivar los auto-titles del todo. Si de todos modos nombras las sessions tú:
hermes config set auxiliary.title_generation.enabled falseLas sessions nuevas ya no reciben title automático y las renombras tú. Ojo: auxiliary.title_generation.language controla el idioma del title (vacío significa seguir la conversación); no arregla la longitud, así que no esperes que rodee este bug.
La lección general
“Estimar la longitud contando palabras” es un reflejo en un código monolingüe y está silenciosamente mal en un producto multilingüe: sin error, sin aviso, solo una comprobación que pasa de largo para ciertos sistemas de escritura. Cualquier guard que estime longitud o complejidad partiendo por espacios en blanco debería preguntarse qué pasa cuando el idioma no tiene espacios.
Si trabajas en chino u otra lengua CJK, hay unas cuantas áreas relacionadas que conviene conocer: los límites y el archivado de sessions se cubren en la guía de límites de session; export, rename y --resume están documentados en la referencia de hermes sessions; y si el idioma de tu UI no coincide con el del modelo, la guía de language packs explica qué superficies siguen el ajuste.
La versión corta
Un title de session se convirtió en una respuesta completa porque el guard de longitud cuenta palabras con split(), que es ciego al texto CJK: 76 caracteres chinos cuentan como tres palabras, así que un techo de doce palabras nunca salta. A corto plazo, renombra las sessions con hermes sessions rename o desactiva auxiliary.title_generation.model_upgrade_enabled y quédate con el title instantáneo; el arreglo de verdad es un guard consciente del sistema de escritura, que todavía no se ha mergeado.