Uma resposta em chinês virou título de sessão: a guarda de comprimento só conta espaços
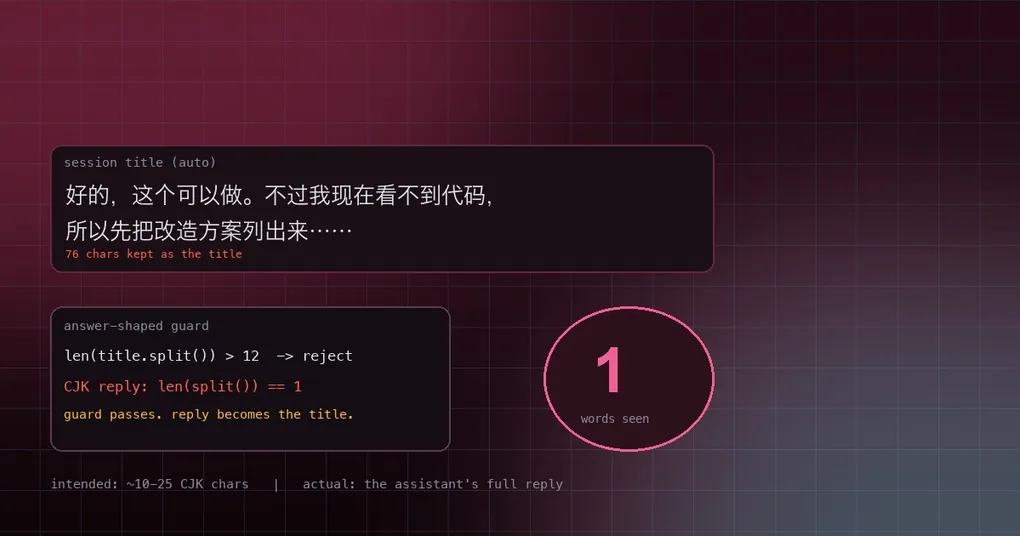
Você troca de modelo, abre algumas sessões novas e depois vai procurar aquela em que discutiu o plano de deploy. A barra lateral mostra uma frase inteira: 好的,这个可以做。不过我现在看不到代码,所以先把改造方案列出来…. Isso não é um título, é a resposta do modelo. E toda sessão nova está assim, esticando a lista tela abaixo.
Isso é mais que um modelo tagarela. O modelo ignorou mesmo a instrução de devolver um título curto, mas o Hermes tem uma guarda feita exatamente para essa falha — só que ela não sabe contar chinês. O problema foi reportado em 20 de outubro de 2026 (issue #141969). A seguir: o mecanismo, as evidências e três contornos que funcionam hoje.
Como um título é gerado
Os títulos são gerados em duas etapas. Primeiro vem um título instantâneo, derivado localmente da sua mensagem de abertura, sem chamar modelo. Depois vem o upgrade por modelo: uma chamada em background recebe um preview da conversa e é instruída a devolver um título curto num campo JSON.
A etapa dois normalmente se comporta. Mas modelos tagarelas às vezes ignoram o formato e respondem ao usuário, devolvendo a resposta inteira como conteúdo do campo. É o que o código chama de saída em formato de resposta.
O ponto cego: len(title.split())
Para pegar isso, agent/title_generator.py tem um teto simples:
_MAX_TITLE_WORDS = 12
...
# Guarda contra saída em formato de resposta: um título com muitas palavras é
# um modelo que ignorou a tarefa e respondeu à mensagem do usuário.
if title is not None and len(title.split()) > _MAX_TITLE_WORDS:
    return None
A lógica é razoável: um título de verdade não passa de doze palavras, enquanto uma resposta costuma ir muito além. O problema é str.split(), que divide por espaço em branco. Inglês, alemão e francês são delimitados por palavra e se comportam; chinês, japonês e coreano não são, então uma frase inteira tokeniza em uma, três, talvez oito “palavras”.
As medições da issue vêm direto de um state.db real:
| O que ficou gravado como título | chars | len(split()) |
guarda de 12 palavras |
|---|---|---|---|
好的,这个可以做。不过我现在看不到 hermesbubble 的代码… |
76 | 3 | passa |
可以,直接在这说。先判断一个关键点:登录页本身能打开吗? |
32 | 1 | passa |
先确认一下:你说的 Hermes 是哪个项目/镜像? |
80 | 8 | passa |
我是 ChatGPT,由 OpenAI 开发。当前对话里没有提供… |
73 | 4 | passa |
Na mesma máquina, sessões antigas criadas antes da troca de provider tinham todas títulos adequados, de 17 a 24 caracteres. Ou seja: em línguas delimitadas por espaço a guarda funciona; em chinês ela praticamente não existe. E há um aspecto em que ela é pior que inútil — a resposta aceita é persistida com title_source='llm', indistinguível de um título real, a não ser pelo fato de você lembrar o que era.
A direção proposta
A issue propõe tornar a guarda ciente do sistema de escrita: manter a contagem de palavras para texto delimitado por espaço e adicionar um teto de caracteres para trechos CJK. Um título costuma ter de 10 a 25 caracteres chineses, enquanto uma resposta passa de 40, então 30 deixa espaço para um título com várias orações:
_MAX_TITLE_WORDS = 12
# CJK não tem espaços, então len(split()) subconta muito. Um título continua
# curto em caracteres também; uma resposta não. ~30 deixa espaço para um título real.
_MAX_TITLE_CJK_CHARS = 30

def _cjk_char_count(text: str) -> int:
    return sum(1 for ch in text if
               "\u4e00" <= ch <= "\u9fff"      # CJK Unified Ideographs
               or "\u3040" <= ch <= "\u30ff"   # Hiragana/Katakana
               or "\uac00" <= ch <= "\ud7a3")  # Hangul
Para deixar o status claro: até o momento em que escrevo, essa issue continua aberta e nenhum patch foi mergeado. Então o que vem a seguir são contornos para usar agora, não uma nota de release.
Três coisas que você pode fazer agora
Um: renomeie a sessão. hermes sessions rename recebe um id de sessão e o novo título:
hermes sessions rename 8f3c1d2a "deploy plan discussion"Para o histórico que já recebeu uma frase como título, isso resolve uma por vez. Os ids de sessão saem de hermes sessions list, e um prefixo basta.
Dois: mantenha o título instantâneo e desligue o upgrade por modelo. O título instantâneo é derivado da sua própria mensagem, então é curto por construção. Desligue a chamada em background ao modelo:
hermes config set auxiliary.title_generation.model_upgrade_enabled falseO trade-off são títulos mais simples — eles refletem sua primeira frase em vez de resumir a conversa.
Três: desligue os títulos automáticos de vez. Se você nomeia as sessões por conta própria:
hermes config set auxiliary.title_generation.enabled falseSessões novas passam a não ter título automático e você renomeia na mão. Note que auxiliary.title_generation.language controla o idioma do título (vazio significa seguir a conversa) — não corrige comprimento, então não conte com ele para contornar este bug.
A lição geral
“Estimar comprimento contando palavras” é um reflexo num código monolíngue e um erro silencioso num produto multilíngue: nenhum erro, nenhum aviso, só uma checagem que passa quietinha para certos sistemas de escrita. Toda guarda que estima comprimento ou complexidade dividindo por espaço deveria se perguntar o que acontece quando a língua não tem espaços.
Algumas áreas relacionadas valem a pena se você trabalha em chinês ou em outra língua CJK: limites de sessão e arquivamento estão no guia de limites de sessão; export, rename e --resume estão documentados na referência de hermes sessions; e se o idioma da sua interface difere do modelo, o guia de language packs explica quais superfícies seguem a configuração.
Resumo rápido
Um título de sessão virou uma resposta completa porque a guarda de comprimento conta palavras com split(), que é cega para texto CJK: 76 caracteres chineses contam como três palavras, então um teto de doze palavras nunca dispara. No curto prazo, renomeie sessões com hermes sessions rename ou desligue auxiliary.title_generation.model_upgrade_enabled e fique com o título instantâneo; a correção de verdade é uma guarda ciente do sistema de escrita, que ainda não foi mergeada.