中文回复被存成了会话标题:一个按空格数词的长度守卫,看不见中日韩文本
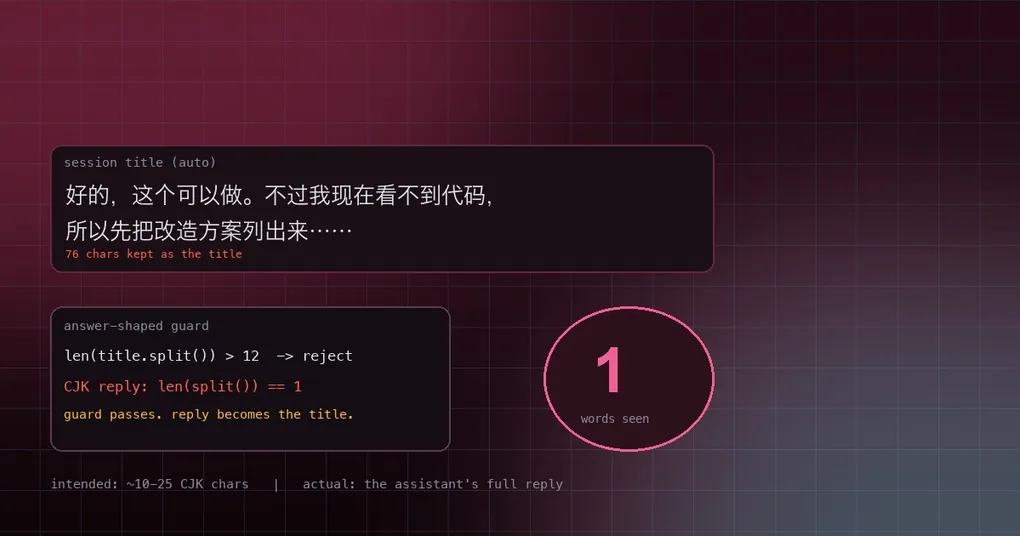
你换了模型,开了几个新会话,回头想从列表里找那次“讨论部署方案”的对话——结果列表里躺着一整句话:好的,这个可以做。不过我现在看不到代码,所以先把改造方案列出来…。那不是标题,那是模型的回复。而且每个新会话都这样,侧边栏被拉得老长。
这不是模型“不听话”这么简单。模型确实违反了“只返回一句短标题”的指令,但 Hermes 本来有一道守卫专门拦这种情况,只是这道守卫数不了中文。问题在 2026 年 10 月 20 日被报出来(issue #141969),本文把机制、复现和三个可用对策讲清楚。
标题是怎么生成的
会话标题分两步。第一步是“即时标题”:不用模型,直接从你第一条消息里推导出一小段。第二步是“模型升级”:后台调一次模型,给它一段对话预览,要求返回一句更贴切的短标题——返回的是 JSON,标题放在固定字段里。
正常情况下第二步很稳。但聊天型模型有时会忽略格式要求,直接回答用户的问题,把整段回复当成字段内容交回来。这就是所谓的“答案形状输出”(answer-shaped output)。
守卫的盲点:len(title.split())
为了拦住这种输出,agent/title_generator.py 里有一道很朴素的上限检查:
_MAX_TITLE_WORDS = 12
...
# Answer-shaped output guard: a title with many words is a model that ignored
# the task and answered the user's message instead.
if title is not None and len(title.split()) > _MAX_TITLE_WORDS:
    return None
逻辑没错:真正的标题不会有 12 个词以上,而一段回复通常远远超过。问题在 str.split()——它按空白字符切分。英文、德文、法文这种用空格分词的书写系统没问题;中文、日文、韩文没有词间空格,一整句话切出来就是 1 个、3 个“词”。
issue 里给的实测数据很直观,全部来自真实的 state.db:
| 被存成标题的内容 | 字符数 | len(split()) |
12 词守卫 |
|---|---|---|---|
好的,这个可以做。不过我现在看不到 hermesbubble 的代码… |
76 | 3 | 通过 |
可以,直接在这说。先判断一个关键点:登录页本身能打开吗? |
32 | 1 | 通过 |
先确认一下:你说的 Hermes 是哪个项目/镜像? |
80 | 8 | 通过 |
我是 ChatGPT,由 OpenAI 开发。当前对话里没有提供… |
73 | 4 | 通过 |
同一台机器上,换模型之前的老会话标题都是 17–24 个字符的正常短句。也就是说:在空格分词的语言里,这道守卫有效;在中文里,它基本等于不存在。 更糟的是,被“接受”的回复带 title_source='llm' 落库,看上去和正常标题没有区别,只有你自己知道那是模型的回答。
报出来的修复方向
issue 提议把守卫改成“按书写系统判断”:文字用空格的继续数词,CJK 文本再用一个字符上限兜底——标题通常 10–25 个汉字,而回复一般 40 字以上,取 30 作阈值留出多从句标题的余量:
_MAX_TITLE_WORDS = 12
# CJK has no spaces, so len(split()) badly undercounts. A title stays short in
# characters too; a reply does not. ~30 leaves room for a real multi-clause title.
_MAX_TITLE_CJK_CHARS = 30

def _cjk_char_count(text: str) -> int:
    return sum(1 for ch in text if
               "\u4e00" <= ch <= "\u9fff"      # CJK Unified Ideographs
               or "\u3040" <= ch <= "\u30ff"   # Hiragana/Katakana
or "\uac00" <= ch <= "\ud7a3") # Hangul要说明的是:截至本文写作,这条 issue 仍然是打开状态,补丁没有合入。 所以下面给的是能立刻用的对策,不是等版本发布。
现在就能用的三个办法
一,改回短标题。 hermes sessions rename 支持直接给会话改名,参数是会话 ID 加上标题本身:
hermes sessions rename 8f3c1d2a "部署方案讨论"历史会话被存成一句话的,这一条能一次修好。会话 ID 用 hermes sessions list 看,也可以用 ID 前缀。
二,只保留即时标题,不让模型插手。 即时标题是从你自己的消息里推导出来的短语,天然不会是一整段回复。把后台的模型升级关掉即可:
hermes config set auxiliary.title_generation.model_upgrade_enabled false代价是标题会朴素一些——它只反映你问的第一句话,不会概括整段对话。
三,彻底关掉自动标题。 如果你习惯自己命名,可以直接停掉这一步:
hermes config set auxiliary.title_generation.enabled false关掉之后新会话不会自动获得标题,需要你手动 rename。另外 auxiliary.title_generation.language 这个键是控制标题语言的(不填就跟随对话语言),它不解决长度问题——别指望用它绕过这个 bug。
这件事的普遍教训
“按词数判断长度”在单语环境里几乎是条件反射,但一旦产品面向多语言用户,它就是一个静默失效的检查:不报错、不告警,只是在某些语言下悄悄放行。凡是“用空白切分来估算长度/复杂度”的守卫,都应该问一句:没有空格的语言怎么办?
中文用户还有几个相关的坑值得顺手了解:会话边界与归档规则见会话边界指南;export、rename、--resume 这些子命令的完整用法在 hermes sessions 命令参考;如果你的界面语言与模型语言不一致,语言包指南解释了哪些地方会跟随语言设置。
小结
标题被写成一整句回复,根因不是模型“太健谈”,而是长度守卫用 split() 数词,对中日韩文本天然失效:76 个汉字只算 3 个词,12 词上限形同虚设。短期内用 hermes sessions rename 改回来,或者把 auxiliary.title_generation.model_upgrade_enabled 关掉只用即时标题;想彻底修好,得等按书写系统判断的守卫合入。