Plus de la moitié de ce state.db, c'étaient des copies de messages déjà remplacés par le prune
Le ventilateur de votre laptop se met à tourner alors que vous ne faites rien. Les backups prennent un peu plus de temps chaque semaine. hermes sessions stats annonce une base de plusieurs gigaoctets — mais votre liste de sessions ne ressemble pas à plusieurs gigaoctets. La plupart des conversations font une douzaine de tours, et leur historique a été compressé depuis longtemps. Alors où est passée la place ?
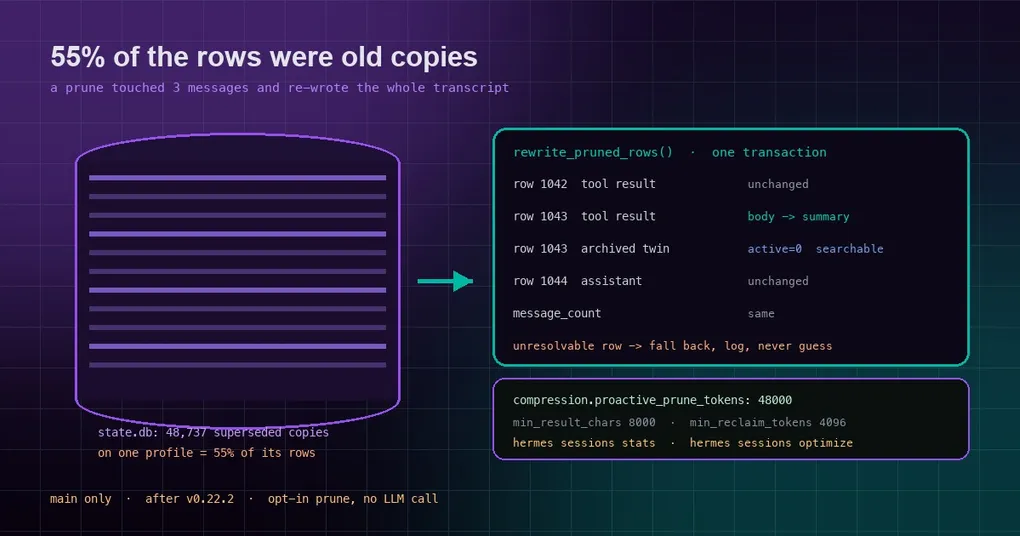
La réponse est un peu contre-intuitive : elle est partie dans les vieux messages que vous aviez déjà purgés. Leur corps complet a été recopié dans des jumeaux « archivés », encore et encore. Sur une installation avec le prune optionnel activé, un profil a accumulé 31 930 de ces copies ; un second profil en avait 48 737 — 55 % de toutes ses lignes.
Ce que fait réellement le prune
Hermes a une fonctionnalité opt-in appelée prune proactif (compression.proactive_prune_tokens, désactivée par défaut). Elle est volontairement modeste : quand l’historique renvoyé dépasse votre seuil de tokens, elle remplace les vieux résultats d’outils volumineux — dumps de terminal, lectures de fichiers, extractions web — par de courts résumés. Aucun appel au modèle n’est impliqué.
Le point important : un prune modifie le corps de quelques messages existants. Il n’ajoute jamais de message, n’en supprime pas, ne les réordonne pas. Du point de vue des données, c’est une édition locale.
L’ancien chemin de commit n’était pas d’accord. Chaque commit passait par l’écrivain complet archive-and-compact : archiver toutes les lignes actives, puis réinsérer la liste entière.
Vous modifiez trois messages ; la base gagne une copie du transcript complet.
Une ou deux fois, ce n’est rien. Mais le prune se déclenche de façon répétée dans une longue session, et les copies s’empilent : chacune est « l’historique complet tel qu’il était alors », et l’essentiel de ce contenu devient la matière première de la copie suivante. Voilà pourquoi le fichier grossit bien plus vite que vos conversations.
Les chiffres mesurés
Pas des estimations — ils viennent de l’issue de suivi :
| Observation | Valeur |
|---|---|
| Copies expirées, premier profil | 31 930 lignes |
| Copies expirées, second profil | 48 737 lignes |
| Part des lignes de ce profil | 55 % |
| Déclencheur | prune proactif activé (exemple de config proactive_prune_tokens: 12000) |
La moitié de cette base ne servait à rien d’autre qu’à ralentir les lectures, les écritures, les backups et l’index full-text.
Ce qui a changé : réécrire sur place
La nouvelle primitive de commit est SessionDB.rewrite_pruned_rows(session_id, changes, model_config_patch=...), et elle s’exécute dans une seule transaction :
- Nommer la ligne. Résolution par
_row_idd’abord ; sinon partool_call_id(résultats d’outils) ou par la liste d’ids d’appels d’outils que porte un tour assistant — unique au sein d’une session ; sinon uniquement la ligne active unique ayant le même rôle et le même contenu stocké. - Prouver qu’elle contient toujours l’original. Même rôle, même id d’appel d’outil, mêmes ids d’appels, et pour les lignes d’outils le même corps stocké. La moindre divergence annule le chemin sur place.
- Laisser un seul jumeau archivé de son état d’avant le prune (
active=0, compacted=1), pour que le corps complet rétrogradé reste cherchable exactement comme avant. Compaction ne veut toujours pas dire perte de données. - Prendre les colonnes modifiées sous son propre id et fusionner le patch de réarmement dans
model_config.
Les lignes inchangées, l’ordre du modèle, les ids de lignes et les lignes ajoutées en parallèle ne sont jamais touchés. Les triggers existants messages_fts_update et messages_display_identity_update maintiennent la cohérence des index full-text et d’affichage, et message_count ne bouge pas puisqu’aucune ligne n’entre ni ne sort de l’ensemble actif.
Un détail qui inspire confiance : quand la ligne ne peut pas être nommée exactement — _absorbed_row_ids fusionnés, zéro ou plusieurs correspondances, une ligne inactive, une ligne utilisateur, un corps déjà modifié — elle ne devine pas. Elle lève PruneRowUnresolvedError avant toute écriture, le journalise en INFO, et retombe sur l’ancien chemin archive-and-compact. Plus lent, mais correct.
L’utiliser, et inspecter votre propre base
1. Voyez si le prune est activé.
hermes config get compression.proactive_prune_tokens0 (ou « Config key not set ») signifie désactivé, et ce mécanisme n’est pas ce qui a fait grossir votre base. Pour l’activer, les trois clés vivent sous compression: :
compression:
  proactive_prune_tokens: 48000        # 0 = off; 48000 is a reasonable start
  proactive_prune_min_result_chars: 8000   # results smaller than this are left alone
  proactive_prune_min_reclaim_tokens: 4096 # do not commit unless it reclaims this much
2. Mesurez la base.
hermes sessions stats
du -sh ~/.hermes/state.db
(Les profils non-défaut gardent leurs données dans leur propre répertoire de profil.)
3. Récupérez de la place — deux opérations différentes, ne les confondez pas.
hermes sessions optimize          # merge FTS5 segments + VACUUM; no session data changes
hermes sessions optimize-storage  # migrate the full-text index to the compact v23 layout
optimize récupère les pages libres ; optimize-storage change la disposition de l’index et peut récupérer une large fraction sur les grosses bases. Aucune des deux ne supprime les vieilles copies à votre place — quoi archiver ou supprimer reste votre décision de rétention. Le correctif empêche la création de nouvelles copies ; il ne nettoie pas celles qui sont déjà là. Les lignes existantes restent jusqu’à ce que vous archiviez ou supprimiez des sessions selon votre propre calendrier.
Une note de statut honnête : le changement a été fusionné sur main le 18 octobre 2026, après la sortie de la v0.22.2 le 15 octobre, donc la release actuelle ne l’inclut pas. Les nouveaux prunes empruntent le chemin sur place après votre prochain hermes update.
Pourquoi ce type de croissance reste invisible
Trois raisons s’additionnent.
- C’est un effet de bord de quelque chose de correct. L’archive-and-reinsert garantissait que chaque commit était un snapshot complet et cohérent. Il n’y avait pas de bug de logique — le coût était simplement imputé au disque.
- Les métriques ne le montrent pas. Nombre de sessions inchangé, nombre de messages inchangé, UI impeccable. Seuls la taille du fichier et les I/O se dégradent lentement.
- Cela évolue avec l’usage. Plus vous avez de longues sessions et de gros résultats d’outils, plus ça grossit vite — et les gros utilisateurs sont les moins susceptibles de le remarquer, parce que leurs machines sont déjà occupées de toute façon.
Ce n’est pas de la corruption de base, et il ne faut pas confondre les deux : un schéma cassé ou une session disparue a son propre chemin de réparation, traité dans récupérer un state.db endommagé. Ici les données étaient parfaitement saines — il y en avait simplement beaucoup trop.
La leçon générale
« Mettre à jour sur place » et « tout réécrire » sont fonctionnellement équivalents et radicalement différents en coût. Beaucoup de systèmes choisissent la réécriture parce que c’est simple et que ça ne peut pas laisser d’état à moitié écrit ; le prix, c’est de copier toutes les données à chaque petite édition. Mettez ça sur un chemin chaud — toutes les quelques tours — et le prix s’accumule plus vite que prévu.
Le test est direct : si vous avez modifié une ligne, devriez-vous en écrire N ? Sinon, ce chemin finit par devenir un problème de capacité. Le correctif a rarement besoin d’un nouveau moteur de stockage ; il suffit en général que l’appelant reconnaisse une mise à jour sur place — ici, en nommant la ligne exacte par son identité d’appel d’outil et en vérifiant que rien d’autre n’a bougé.
Pour maîtriser plus délibérément la taille du contexte et de l’historique, deux articles voisins vont plus loin : la stratégie de compression lean tail explique ce qui survit à une compaction, et reconstruire le prompt après compaction couvre ce que le modèle voit ensuite. Si vous gérez vos sessions depuis un shell, la référence hermes sessions liste toutes les sous-commandes et tous les filtres.
Résumé
- Symptôme : un
state.dbbien plus gros que le volume de vos conversations ; backups lents, I/O lourdes, compteurs de lignes bizarres danshermes sessions stats. - Cause : chaque commit du prune proactif archivait toutes les lignes actives et réinsérait la liste entière — 48 737 copies obsolètes sur un profil, 55 % de ses lignes.
- Correctif :
rewrite_pruned_rows()ne met à jour que les colonnes modifiées, garde un jumeau archivé cherchable, et retombe proprement sur l’ancien chemin quand une ligne ne peut pas être nommée exactement. - Aujourd’hui : vérifiez le commutateur avec
hermes config get compression.proactive_prune_tokens, mesurez la base avechermes sessions stats, récupérez de la place avechermes sessions optimize, et mettez à jour pour obtenir le nouveau chemin de commit.