state.db 里一半以上的行,是你早就「压缩掉」的旧消息副本
你的笔记本风扇开始经常转,备份脚本越来越慢,hermes sessions stats 一看:数据库好几个 GB。可你翻会话列表,并没有那么多内容——大部分对话都只有十几轮,历史也早被压缩过了。空间到底被谁吃了?
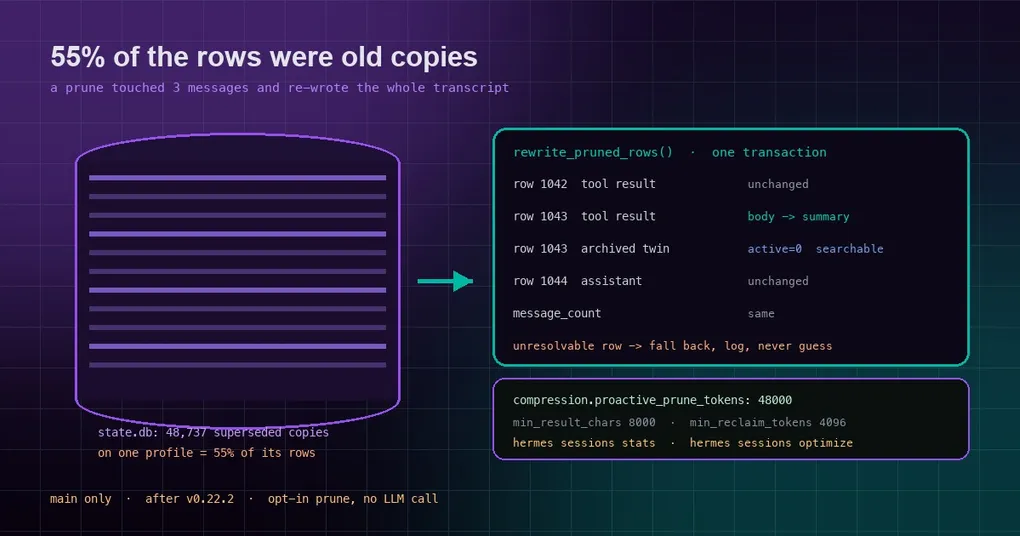
答案有点反直觉:被那些你已经压缩掉的旧消息。它们的完整原文被一遍又一遍地复制成“归档副本”,堆在 state.db 里。在一个开了可选 prune 的安装上,某个 profile 积了 31,930 份这样的副本,另一个 profile 是 48,737 份——占它全部行的 55%。
先解释清楚 prune 在做什么
Hermes 有一个可选的功能叫主动 prune(compression.proactive_prune_tokens,默认关闭)。它做的事情很克制:当重发的历史超过你设的 token 阈值时,它把旧的、体积大的工具结果(终端输出、文件读取、网页抓取)替换成简短的摘要,不做任何模型调用。
关键点是:prune 只改几条已有消息的正文。它不新增消息、不删除消息、也不调整顺序。从数据角度看,这是一次“就地改写”。
但旧的提交路径不是这么做的。每次提交,它都走完整的归档+压缩写入器:把所有活跃行归档一份,再把整个消息列表重新插一遍。于是:
你改 3 条消息,数据库里多出一整份 transcript 的副本。
一次两次无所谓。但当 prune 在一个长会话里反复触发,副本就开始指数式堆积:每一份都是“当时的完整历史”,而其中绝大多数内容在下一次 prune 之后又变成了新的副本。这就是为什么你的数据库膨胀得比对话量快得多。
数字长什么样
这些不是估算,是那个 issue 里实测的:
| 观察项 | 数值 |
|---|---|
| 第一个 profile 的过期副本 | 31,930 行 |
| 第二个 profile 的过期副本 | 48,737 行 |
| 占该 profile 全部行的比例 | 55% |
| 触发条件 | 主动 prune 开启(示例配置 proactive_prune_tokens: 12000) |
也就是说,一个“只有一半是真正有用数据”的数据库,读写、备份、FTS 索引全都在为另一半空转。
现在改成就地重写
新增的提交原语是 SessionDB.rewrite_pruned_rows(session_id, changes, model_config_patch=...),整个过程在一个事务里完成:
- 定位要改的行。先看有没有
_row_id;没有就用tool_call_id(工具结果)或它携带的 tool-call id 列表(assistant 轮次)——这些在一次会话里是唯一的;再不行,就只在“角色相同、存储内容相同”的唯一活跃行里匹配。 - 校验原值还在。这一行必须仍然持有原来那份内容:角色一致、tool call id 一致、call id 列表一致,工具行还要正文一致。任何一处对不上就放弃就地改写。
- 给旧自己留一个归档双胞胎。被替换前的那一份写为
active=0, compacted=1,仍然可被搜索——和今天的行为一致,压缩不等于丢数据。 - 就地接管变化的列,同时把 rearm 补丁合并进
model_config。
没被改的行、模型顺序、行 id、以及并发追加的行都不会被碰。现有的 messages_fts_update 和 messages_display_identity_update 触发器保证全文索引和展示索引一致;message_count 保持不变,因为没有任何行进出活跃集合。
一个值得注意的细节:如果定位不出唯一的那一行(比如 _absorbed_row_ids 合并过的行、匹配到零个或多个、行已不活跃、是用户消息、或正文已变),它不会猜。它会在任何写入发生之前抛出 PruneRowUnresolvedError,记一条 INFO 日志,然后退回旧的归档+压缩路径——慢,但结果正确。
怎么用、怎么查
一、确认自己有没有开 prune。
hermes config get compression.proactive_prune_tokens返回 0 或 “Config key not set” 就表示没开,数据库不会因为这个机制膨胀。想开的话,三个相关键都在 compression: 下面:
compression:
  proactive_prune_tokens: 48000        # 0 = 关闭;开启建议从 48000 起
  proactive_prune_min_result_chars: 8000   # 小于这个体积的工具结果不动
  proactive_prune_min_reclaim_tokens: 4096 # 回收不到这个量就不提交,避免无谓改写
二、看数据库到底多大。
hermes sessions stats它会输出会话存储的统计信息。配合系统层面看一下实际文件大小:
du -sh ~/.hermes/state.db(非默认 profile 的数据目录在各自的 profile 目录下。)
三、回收空间。 这是两个不同的事情,别混:
hermes sessions optimize          # 合并 FTS5 段 + VACUUM,不改动任何会话数据
hermes sessions optimize-storage  # 把全文索引迁移到更紧凑的 v23 布局,大库上能省一大块
optimize 回收的是空闲页,optimize-storage 换的是索引布局。两者都不会替你删掉历史副本——那些副本要不要清、清哪些,仍然由你的归档和删除策略决定。这个修复做的是“不再制造新的副本”,不是“自动清理旧的副本”。 已经堆积的行会留在那里,直到你按自己的策略归档或删除会话。
还有一点需要如实说明:这个改动 2026 年 10 月 18 日合入主分支,晚于 v0.22.2(10 月 15 日发布),当前 release 里还没有它。你下一次 hermes update 到包含该提交的版本后,新产生的 prune 才会走就地重写。
为什么这类膨胀很难被发现
三个原因叠在一起:
- 它是“正确”的副产品。归档+重插保证了每一次提交都是完整一致的快照,逻辑上没有任何 bug,只是代价被记在了磁盘上。
- 指标看不出来。会话数没变、消息数没变、界面一切正常,只有文件体积和 I/O 在慢慢变差。
- 它和用量强相关。你越常开长会话、越常跑大输出的工具,膨胀越快;而恰恰是重度用户最不容易注意到——他们的机器本来就在忙。
这和“数据库损坏”是两件事,别混为一谈:损坏(schema 错乱、会话消失)有独立的修复路径,比如 state.db 损坏后的自愈。这次的问题数据完全健康,只是存了太多份。
从这件事能学到什么
“就地更新”和“整体重写”在功能上等价,在代价上完全不同。很多系统选择整体重写,是因为它简单、不会出现部分写入;代价是每次小改动都要复制全量数据。当这个操作出现在热路径上(每几轮对话就触发一次),代价会以你意想不到的速度累积。
判断标准很朴素:改一行数据,是否应该写 N 行? 如果答案是否定的,那这条路径迟早会变成一个容量问题。修复不一定需要新的存储引擎,往往只是“认出这是原地更新”——本例中就是按 tool call id 精确指名那一行,再校验它没被别人改过。
想更系统地控制上下文与历史体积,可以接着看这两篇:lean tail 压缩策略 讲压缩时保留什么,压缩提示词重建 讲压缩后提示词怎么重建。习惯用命令行管理会话的话,hermes sessions 命令参考 里有完整的子命令与过滤参数。
小结
- 症状:
state.db体积远大于会话量,备份慢、I/O 重;hermes sessions stats能看到行数异常。 - 原因:主动 prune 每次提交都归档全部活跃行再整表重插,一个 profile 积了 48,737 行过期副本(占 55%)。
- 修复:
rewrite_pruned_rows()就地改变化的列,留一个可搜索的归档双胞胎,定位不出唯一行时安全回退。 - 现在做:
hermes config get compression.proactive_prune_tokens确认开关、hermes sessions stats看规模、hermes sessions optimize回收空间;等下一次更新拿到新提交路径。