Trois personnages, une seule gorge : choisir une voix ElevenLabs par appel dans Hermes
Vous doublez un court-métrage de deux minutes. Le script a trois voix : un forgeron dont la voix ressemble à un seau à charbon, un narrateur qui parle comme un cartel de musée, et une fillette avec une seule réplique qui doit sonner comme ses onze ans. Vous collez le tout dans Hermes et demandez l’audio. Il revient en une seule voix — la même pour les trois, parce que l’outil de synthèse n’en avait qu’une à offrir : celle qui traînait dans votre config. Pour la changer, vous éditiez tts.elevenlabs.voice_id, vous redémarriez, vous réessayiez. Et pour savoir quel ID taper, vous ouvriez le site d’ElevenLabs et faisiez défiler quelques centaines de cartes de voix en copiant des chaînes à la main.
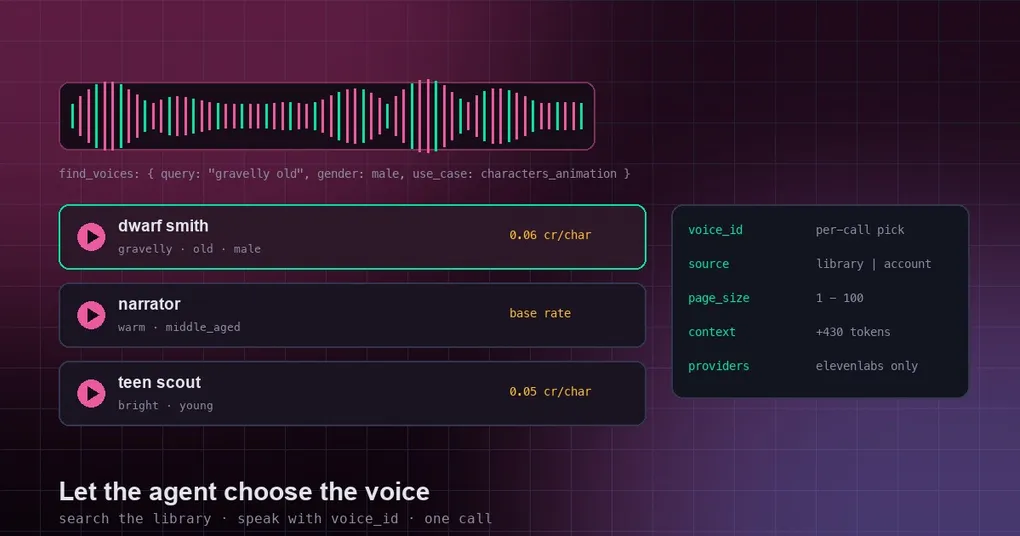
Deux nouveaux champs comblent ce vide. Chez le provider ElevenLabs, text_to_speech accepte maintenant un voice_id par appel, et un objet find_voices qui transforme le même outil en moteur de recherche de voix. Pas de nouvel outil, pas de nouveau provider — deux champs sur un schéma que vous avez déjà.
La configuration que cela remplace
La synthèse vocale est la partie simple : vous donnez une chaîne à un modèle, il vous rend l’audio de cette chaîne lue à voix haute. Hermes n’a pas de voix à lui ; il appelle un provider hébergé. ElevenLabs en est un, sélectionné avec tts.provider: elevenlabs et configuré dans le bloc tts.
La Voice Library est la partie désordonnée : le catalogue public de voix partagées d’ElevenLabs, des milliers d’entrées, chacune avec un ID, un nom, des libellés descriptifs et un court extrait de préécoute. À côté se trouve le catalogue de votre compte — les presets plus tout ce que vous avez enregistré, cloné ou conçu. Avant ce changement, aucun des deux n’était atteignable depuis un appel d’outil : le modèle pouvait parler, mais pas regarder.
Une voix comme décision de déploiement — réglée une fois dans la config, comme un modèle par défaut — convient à un assistant qui lit des notifications. Elle casse dès qu’il y a du dialogue : un script, c’est plusieurs voix, et personne ne redémarre un processus entre deux répliques.
Deux champs sur l’outil que vous avez déjà
Le prérequis est le choix du provider :
tts:
  provider: elevenlabs
  elevenlabs:
    voice_id: 'YOUR_DEFAULT_VOICE_ID'
voice_id au moment de l’appel choisit la voix pour cet appel uniquement. La règle est stricte dans les deux sens : omettez-le et la config s’applique ; passez-le et la valeur vaut pour cette seule synthèse. Une valeur par appel ne réécrit jamais votre config, donc l’appel suivant revient au défaut sauf si vous repassez une voix.
{
  "text": "Coal is hot. Speak your piece while it holds.",
  "voice_id": "YOURCHOSENVOICEID"
}
Voilà toute la fonctionnalité pour une réplique. La moitié la plus difficile, c’est de trouver l’ID : une chaîne alphanumérique de 20 caractères ne se devine pas, et les noms de la bibliothèque ne sont pas assez uniques pour qu’on s’y fie.
Chercher au lieu de parler
find_voices est un objet, et le passer fait basculer l’outil de parler à chercher — la seule configuration où text devient facultatif sur cette variante, puisqu’une recherche n’a rien à dire. Deux catalogues se trouvent derrière l’interrupteur :
source: library(par défaut) appelleGET /v1/shared-voices, la Voice Library publique. Ces voix fonctionnent directement parvoice_idsans être d’abord enregistrées dans votre compte, mais l’API ElevenLabs ne permet qu’aux offres payantes de les utiliser.source: accountappelleGET /v2/voiceset couvre les presets plus chaque voix que vous avez enregistrée, clonée ou conçue.
{
  "find_voices": {
    "query": "gravelly old",
    "gender": "male",
    "age": "old",
    "language": "en",
    "use_case": "characters_animation",
    "page_size": 10
  }
}
Les filtres se répartissent selon le catalogue :
| Champ | Où il s’applique | Remarques |
|---|---|---|
query |
les deux | Correspondance littérale de mots sur le nom et la description, pas sémantique |
gender |
les deux | Libellé de filtre |
age |
les deux | Libellé de filtre |
accent |
les deux | Libellé de filtre |
language |
les deux | Libellé de filtre |
use_case |
library seulement | Par exemple characters_animation |
sort |
library seulement | usage_character_count_1y par défaut ; aussi trending, cloned_by_count, created_date |
page_size |
les deux | 1 à 100, 20 par défaut |
source |
les deux | library par défaut, ou account |
use_case restreint aux voix enregistrées pour l’animation de personnages plutôt que pour la narration d’entreprise — un registre vocal différent.
Les résultats arrivent page par page. next_page renvoie un curseur opaque que le modèle repasse tel quel comme page ; en dessous, l’endpoint du compte utilise un next_page_token et la bibliothèque des numéros de page — c’est pourquoi le curseur reste opaque pour vous.
Chaque ligne porte l’id, un nom, traits, une category, une description tronquée à 240 caractères et une preview_url. Les voix de la bibliothèque facturées au-dessus du tarif par défaut portent aussi credit_rate. La page dans son ensemble indique configured_voice_id, la voix actuellement dans votre config — un petit détail à la valeur réelle, puisqu’il permet au modèle d’éviter de recommander la voix que vous entendez déjà tous les jours.
Un forgeron nain, réellement choisi
La pull request consigne une exécution contre la vraie API : une vraie clé ElevenLabs, eleven_v4, google/gemini-3.8-flash sur l’API d’inférence Nous, et un vrai processus hermes chat -Q côté agent. La tâche portait sur un personnage — trouver une voix pour un forgeron nain buriné par les ans, puis s’en servir pour dire une réplique. La première requête écrite par le modèle :
{
  "query": "dwarf blacksmith gravelly",
  "age": "old",
  "gender": "male",
  "use_case": "characters_animation"
}
Rien d’utilisable n’est revenu. La bibliothèque cherche des mots littéraux dans les noms et descriptions, donc un nom de rôle comme dwarf est une supposition sur des métadonnées souvent absentes : les catalogues de voix décrivent un timbre, pas des personnages.
Le modèle a donc pivoté, de la description de la personne vers la description du son — gravelly, gruff et autres du même ordre — en gardant les filtres d’âge et de genre. Cela a produit des candidats. Il a comparé les traits et les descriptions tronquées à la scène, consulté configured_voice_id pour ne pas rendre la voix déjà utilisée, puis appelé text_to_speech avec le voice_id choisi et la réplique.
Deux habitudes découlent de cette exécution. Décrivez le son, pas le rôle — si une recherche de personnage revient vide, n’ajoutez pas d’autres mots de personnage ; passez aux adjectifs sur la voix et resserrez avec les filtres. Et le modèle n’entend pas : il lit du texte sur de l’audio, donc quand le choix compte, il vous remet les liens preview_url. Une voix choisie sans écoute est un brouillon, pas une décision.
Ce qu’il n’a délibérément pas touché
Les deux champs sont injectés par le hook de schéma dynamique existant _tts_schema_overrides, qui relit votre config à chaque fois que les définitions d’outils sont listées. Le hook n’est pas nouveau ; seule sa branche ElevenLabs a grossi.
Les frontières sont étroites, et c’est pourquoi il s’agit d’un petit changement et non d’une bifurcation du comportement :
- Les schémas de
text_to_speechpour Edge, OpenAI, xAI et les autres sont identiques octet pour octet àmain, et l’instantané de l’invite du provider par défaut est inchangé. - Envoyer
voice_idà un autre provider vous vaut un avertissement et l’argument est ignoré — l’appel produit quand même de l’audio. Cela compte dans exactement un scénario : vous avez mis un schéma en cache, puis changé de provider. - Envoyer
find_voicesà un autre provider échoue proprement avec une erreur disant qu’il exigetts.provider: elevenlabs. Aucun repli silencieux vers la parole. - Un ID malformé est rejeté avant que la moindre requête ne quitte le processus, contre
^[A-Za-z0-9]{8,64}$.
Le coût en contexte est le point où les utilisateurs d’autres providers peuvent respirer. Mesuré avec get_tool_definitions, le schéma text_to_speech dans une session ElevenLabs passe d’environ 410 tokens à environ 840. Dans toute autre session, le coût est de 0 token, parce que les ajouts n’entrent jamais dans le schéma.
Deux correctifs voisins sont arrivés dans le même lot : find_voices={} ne retombe plus sur parler et signifie désormais parcourir, et sur la passerelle audio gérée, tts-1 et tts-1-hd ne sont plus silencieusement dégradés.
Trois pièges
Les voix de la bibliothèque sont une fonction des offres payantes. Synthétiser avec un voice_id de bibliothèque sans l’enregistrer dans votre compte est vraiment pratique, mais le chemin API exige une offre ElevenLabs payante. Avec une clé gratuite, la recherche peut toujours renvoyer des lignes que l’appel de synthèse ne peut pas utiliser. Un credit_rate sur une ligne est le signe que la voix se facture au-dessus du tarif par défaut.
Un bon nom n’est pas une bonne voix. Les noms de la bibliothèque sont écrits par les utilisateurs : deux voix appelées quelque chose comme « Deep Narrator » peuvent différer radicalement en rythme, en souffle et en consonnes. Écoutez la preview_url — une voix délicieuse pendant vingt secondes peut être insupportable sur quatre minutes de dialogue.
Le curseur n’est pas à vous de reconstruire. Parcourez les résultats en renvoyant next_page tel quel comme page, mot pour mot. Reconstituer un offset, ou réutiliser un curseur du catalogue du compte contre la bibliothèque, vous donne des doublons ou une page blanche sans explication.
Ce qu’il faut pour l’utiliser
Le changement a été fusionné le 2026-10-25, après la sortie de la v0.22.5 le 2026-10-23. Il est sur main et dans aucune release étiquetée, donc une installation standard de la dernière release n’aura aucun des deux champs. Pour l’essayer maintenant, il faut tourner depuis main ; le guide d’installation couvre le chemin depuis les sources.
Ensuite le flux est court : chercher par timbre, écouter deux ou trois extraits preview_url, garder les IDs qui vous plaisent, les passer appel par appel. La config reste où elle était, donc une voix pour les notifications et trois pour le court-métrage coexistent dans la même installation — le même principe que les surcharges de modèle par appel, où une sélection ponctuelle ne mute jamais les défauts sur lesquels vous comptez.
Si la latence devient le problème suivant une fois le casting terminé, la mécanique pour garder un pipeline de synthèse chaud et streamer aux frontières de phrase se trouve dans le guide du keep-warm et du streaming par phrase ; choisir une voix n’y change rien. Et brancher la parole dans une conversation à double sens plutôt que dans un rendu unique est une décision distincte — voir le guide du modèle de chat vocal.