一个脚本三个人说话,Hermes 以前只有一个嗓子
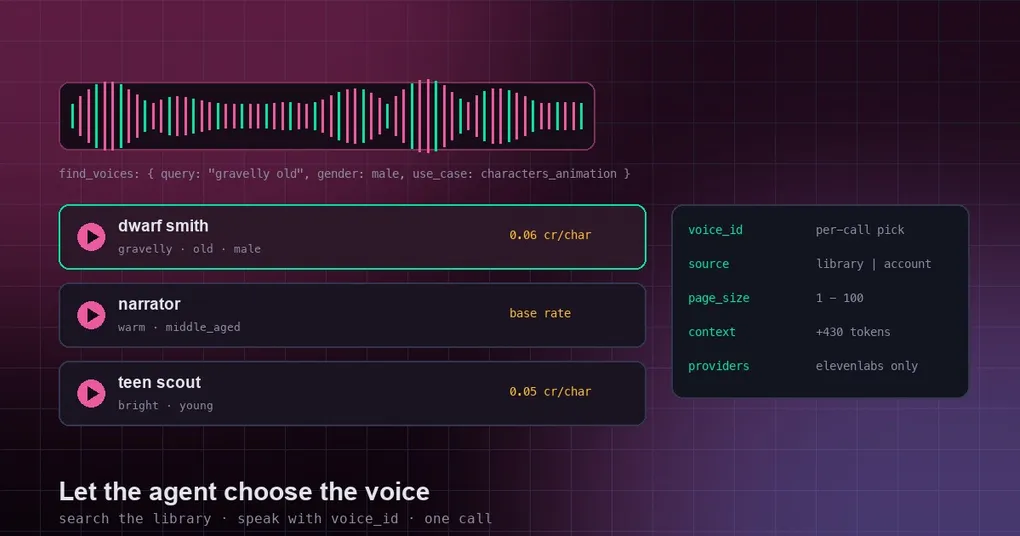
你在给一支两分钟的短片配音。剧本里三个角色:铁匠的嗓子像被煤灰磨过,旁白像博物馆的讲解牌,还有一个只有一句词的少女。你把整份剧本丢给 Hermes 让它出音频,回来的是一把嗓子——三个人全是同一个声音,因为语音工具手里只有一个:配置文件里那个。想换就得改 tts.elevenlabs.voice_id、重启、再试一遍;而想知道该填哪个 ID,你还得打开 ElevenLabs 网站,一节一节往下翻几百张声音卡片,手动复制字符串。
两个新字段把这段流程收掉了。前提是 tts.provider: elevenlabs:text_to_speech 现在接受一个“本次调用”的 voice_id,以及一个 find_voices 对象——传它,同一个工具就从“说话”变成“搜声音”。没有新工具,也没有新 provider,只是你已经有的 schema 上多了两个字段。
先说清楚:TTS 和声音库是什么
语音合成(TTS)是清楚的那一半:给模型一段文本,它返回这段文字被读出来的音频。Hermes 自己不带声音,它调用托管服务,ElevenLabs 是其中之一,在配置的 tts 块里选中并设置。
声音库(Voice Library)是麻烦的那一半:它是 ElevenLabs 的公开共享声音目录,几千条,每条有 ID、名字、若干描述标签和一小段试听。它旁边是你的账号目录——预置声音,加上你自己保存过、克隆过、设计过的那些。在这次改动之前,这两处都没法从工具调用里够到:模型能说话,但看不见。
把声音当成“部署决定”(配置里设一次,像默认模型那样)对“读通知的助手”是对的。一碰到对白就崩:剧本天然是多个说话人,而没人会在两句台词之间改配置文件再重启进程。
两个字段,还是原来那个工具
先切 provider:
tts:
  provider: elevenlabs
  elevenlabs:
    voice_id: 'YOUR_DEFAULT_VOICE_ID'
调用时传 voice_id,只影响这一次。规则两个方向都很硬:不传,用配置里的 tts.elevenlabs.voice_id;传了,值只对这一条合成生效。单次调用的值永远不会改写配置,所以下一次调用又回到默认声音,除非你再传一次。
{
  "text": "煤是热的,有话趁现在说。",
  "voice_id": "YOURCHOSENVOICEID"
}
一句话的活,就这么点事。麻烦的是那个 ID 怎么来:一长串字母数字猜不出来,库里的名字又不够唯一,不能凭感觉填。
传 find_voices 就变成搜声音
find_voices 是一个对象。传它的意思不是“说”,而是“找”——这也是这个变体里 text 变成可选(搜索当然没有文本)的唯一情形。背后是两个目录:
source: library(默认)打GET /v1/shared-voices,也就是公开声音库。库里的声音可以直接用voice_id发声、不需要先保存到账号,但 ElevenLabs API 只允许付费计划这么用。source: account打GET /v2/voices,覆盖预置声音,加上你自己保存、克隆、设计的声音。
{
  "find_voices": {
    "query": "gravelly old",
    "gender": "male",
    "age": "old",
    "language": "en",
    "use_case": "characters_animation",
    "page_size": 10
  }
}
过滤条件按目录分家:
| 字段 | 作用范围 | 说明 |
|---|---|---|
query |
两边 | 按名字和描述里的字面词匹配,不是语义搜索 |
gender |
两边 | 标签过滤 |
age |
两边 | 标签过滤 |
accent |
两边 | 标签过滤 |
language |
两边 | 标签过滤 |
use_case |
仅库 | 例如 characters_animation |
sort |
仅库 | 默认 usage_character_count_1y,另有 trending、cloned_by_count、created_date |
page_size |
两边 | 1–100,默认 20 |
source |
两边 | 默认 library,或 account |
use_case 对虚构内容最有用:它能把范围收到“为角色动画录的声音”,而不是企业宣传片那种腔调——完全是另一种发声位置。
结果一次返回一页。next_page 是不透明游标,模型把它原样当 page 传回来继续翻;底下账号侧叫 next_page_token,库侧是页码,所以对你来说它就该是不透明的。
每行有 id、名字、traits、category、截到 240 字符的描述、preview_url;库里的声音如果计费高于默认费率,还会带 credit_rate。整页还带 configured_voice_id,也就是你配置里当前那个——这个小字段很有用,模型可以据此避开“你天天在听的那把嗓子”。
一次真实的挑选:矮人的铁匠
PR 里记录了一次对真实 API 的实跑:真实 ElevenLabs key、eleven_v4、Nous 推理 API 上的 google/gemini-3.8-flash,agent 那侧是真正的 hermes chat -Q 进程。任务是一个人:给“一个饱经风霜的矮人铁匠”找声音,再用它说一句台词。模型第一版查询写的是:
{
  "query": "dwarf blacksmith gravelly",
  "age": "old",
  "gender": "male",
  "use_case": "characters_animation"
}没有可用结果。库是按名字和描述里的字面词匹配的,dwarf 这种角色词匹配不到——声音目录描述的是音色,不是人物。
于是它换了个方向:不再描述人,改描述声音——gravelly、gruff 这一类,年龄和性别过滤条件保留。这次出了候选。它把 traits 和截断后的描述对着场景比,又看了一眼 configured_voice_id 以免推荐你已经在用的那把,最后用选中的 voice_id 调 text_to_speech 说那句台词。
两个习惯值得留下。描述音色,别描述角色:按角色搜不到时,不要继续堆角色词,换成形容声音的形容词,再用过滤条件收窄。还有——模型听不见声音,它读的是关于音频的文字,所以在这个选择很重要时,它会给出 preview_url 让你自己听。没听过就定下来的声音,算草稿。
只对 ElevenLabs 生效
这两个字段来自已有的动态 schema 钩子 _tts_schema_overrides,它每次列工具时读配置。钩子不是新的,只是它的 ElevenLabs 分支长大了。
边界收得很紧,这也是它属于小改动而不是行为分叉的原因:
- Edge、OpenAI、xAI 等其它 provider 的
text_to_speechschema 与 main 逐字节一致,默认 provider 的 prompt 快照也没有变化。 - 在别的 provider 下发
voice_id:忽略并警告,这次语音不会失败。只会在一种情况下撞上——你先缓存了 schema,然后切了 provider。 - 在别的 provider 下发
find_voices:得到一个干净的 “needstts.provider: elevenlabs” 错误,不会静默退化成“说话”。 - 畸形的 ID 在请求发出去之前就被拒,正则
^[A-Za-z0-9]{8,64}$。
上下文成本:用 get_tool_definitions 实测,ElevenLabs 会话里 text_to_speech 的 schema 从约 410 token 涨到约 840 token;非 ElevenLabs 会话是 0 token,因为这两个字段根本不进 schema。
同一批还有两个小修,各一句:find_voices={} 以前会掉进“说话”,现在按“浏览声音”处理;托管音频网关上,tts-1 / tts-1-hd 不再被降级。
三个坑
库里的声音要付费计划。 不先保存到账号、直接用库里的 voice_id 合成确实方便,但 API 这条路只对付费计划开放。免费 key 下搜索仍可能返回合成用不了的行;某行带 credit_rate,说明这个声音的计费高于默认费率。
名字好听不等于声音好听。 库里的名字是用户自己写的,“Deep Narrator” 这类重名一抓一把,节奏、换气、辅音落点可能完全不同。点开 preview_url 听——二十秒里很好听的嗓子,放进四分钟对白里可能让人受不了。
游标不要自己拼。 翻页就把 next_page 原样当 page 传回去。自己算偏移量,或者拿账号侧的游标去翻库,结果要么是重复,要么是一页空白且不给理由。
现在能用上吗
#144633 合并在 2026-10-25,晚于 v0.22.5(2026-10-23 发布),所以它只在 main 上,还没进正式 release——装最新正式版拿不到这两个字段。想现在试就得跑 main,安装指南 里有源码安装的路径。
之后的流程很短:按音色搜、听两三段 preview_url、把喜欢的 ID 记下来、按次传。配置原地不动,所以“通知用一把嗓子、短片用三把嗓子”能在同一套配置里共存——和 按次覆盖模型 是同一个道理:一次性的选择不动你依赖的默认值。
选角完了如果下一个问题是延迟,保活和句级流式那套机制在 保活与句级流式 里,换声音不改这条管道。而把语音接进双向通话而不是一次性渲染,是另一个决定,见 语音对话模型指南。