Três personagens, uma garganta: escolhendo uma voz ElevenLabs por chamada no Hermes
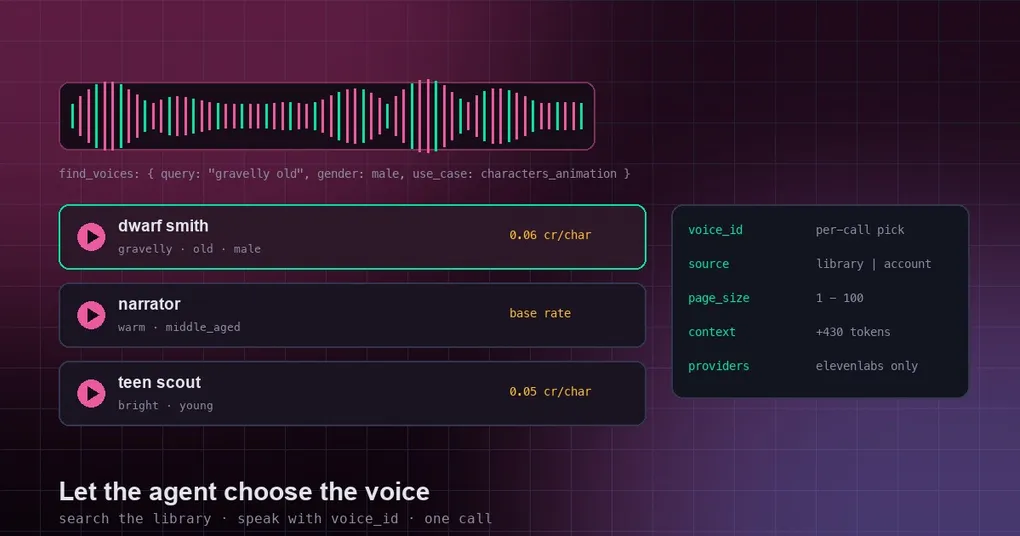
Você está dublando um curta de dois minutos. O roteiro tem três falantes: um ferreiro com voz de balde de carvão, um narrador que soa como placa de museu e uma menina com uma fala só, que precisa soar como onze anos. Você cola tudo no Hermes e pede áudio. Volta uma voz só — a mesma para os três, porque a ferramenta de fala tinha exatamente uma para oferecer: a que estava na sua config. Para mudar, você editava tts.elevenlabs.voice_id, reiniciava e tentava de novo. E para saber qual ID digitar, abria o site da ElevenLabs e rolava algumas centenas de cards de voz, copiando strings à mão.
Dois campos novos fecham essa lacuna. No provider ElevenLabs, o text_to_speech agora aceita um voice_id por chamada e um objeto find_voices que transforma a mesma ferramenta numa busca de vozes. Nenhuma ferramenta nova, nenhum provider novo — dois campos num schema que você já tem.
A configuração que isto substitui
Text-to-speech é a parte simples: você entrega uma string a um modelo e ele devolve o áudio daquela string sendo lida. O Hermes não tem vozes próprias; ele chama um provider hospedado. O ElevenLabs é um deles, selecionado com tts.provider: elevenlabs e configurado no bloco tts.
A Voice Library é a parte confusa: o catálogo público de vozes compartilhadas da ElevenLabs, milhares de entradas, cada uma com um ID, um nome, etiquetas descritivas e um clipe curto de preview. Ao lado dele fica o catálogo da sua conta — os presets e tudo o que você salvou, clonou ou desenhou. Antes desta mudança, nenhum dos dois era alcançável de dentro de uma chamada de ferramenta: o modelo sabia falar, mas não sabia procurar.
Uma voz como decisão de deploy — definida uma vez na config, como um modelo padrão — funciona bem para um assistente lendo notificações. Quebra na hora que existe diálogo: um roteiro tem muitos falantes, e ninguém reinicia um processo entre duas falas.
Dois campos na ferramenta que você já tem
O pré-requisito é a chave do provider:
tts:
  provider: elevenlabs
  elevenlabs:
    voice_id: 'YOUR_DEFAULT_VOICE_ID'
Um voice_id em tempo de chamada escolhe a voz só para aquela chamada. A regra é rígida nos dois sentidos: omita e a config é usada; passe e o valor vale para essa síntese apenas. Um valor por chamada nunca reescreve sua config, então a chamada seguinte volta ao padrão a menos que você passe uma voz de novo.
{
  "text": "Coal is hot. Speak your piece while it holds.",
  "voice_id": "YOURCHOSENVOICEID"
}
Isso é o recurso inteiro para uma fala. A metade mais difícil é achar o ID: uma string alfanumérica de 20 caracteres não é adivinhável, e nomes de biblioteca não são únicos o bastante para confiar.
Buscar em vez de falar
find_voices é um objeto, e passá-lo vira a ferramenta de falar para buscar — a única configuração em que text se torna opcional nesta variante, já que uma busca não tem nada a dizer. Dois catálogos ficam atrás da chave:
source: library(padrão) chamaGET /v1/shared-voices, a Voice Library pública. Essas vozes funcionam direto porvoice_idsem salvá-las antes na sua conta, mas a API da ElevenLabs só permite usá-las em planos pagos.source: accountchamaGET /v2/voicese cobre os presets mais todas as vozes que você salvou, clonou ou desenhou.
{
  "find_voices": {
    "query": "gravelly old",
    "gender": "male",
    "age": "old",
    "language": "en",
    "use_case": "characters_animation",
    "page_size": 10
  }
}
Os filtros se dividem por catálogo:
| Campo | Onde se aplica | Observações |
|---|---|---|
query |
ambos | Casamento literal de palavras no nome e na descrição, não semântico |
gender |
ambos | Etiqueta de filtro |
age |
ambos | Etiqueta de filtro |
accent |
ambos | Etiqueta de filtro |
language |
ambos | Etiqueta de filtro |
use_case |
só library | Por exemplo characters_animation |
sort |
só library | Padrão usage_character_count_1y; também trending, cloned_by_count, created_date |
page_size |
ambos | 1 a 100, padrão 20 |
source |
ambos | library por padrão, ou account |
use_case restringe a vozes gravadas para animação de personagem em vez de narração corporativa — um registro vocal diferente.
Os resultados vêm página a página. next_page devolve um cursor opaco que o modelo repassa direto como page; por baixo, o endpoint de conta usa um next_page_token e a biblioteca usa números de página — e é por isso que o cursor permanece opaco para você.
Cada linha traz o id, um nome, traits, uma category, uma descrição truncada em 240 caracteres e um preview_url. Vozes de biblioteca cobradas acima da tarifa padrão também trazem credit_rate. A página como um todo informa configured_voice_id, a voz que está na sua config agora — um detalhe pequeno com valor real, já que permite ao modelo evitar recomendar justamente a voz que você ouve todo dia.
Um ferreiro anão, escolhido de verdade
O pull request registra uma execução contra a API real: uma chave ElevenLabs de verdade, eleven_v4, google/gemini-3.8-flash na API de inferência da Nous e um processo hermes chat -Q legítimo do lado do agente. A tarefa era um personagem — encontrar uma voz para um ferreiro anão calejado pelo tempo e usá-la para dizer uma fala. A primeira query que o modelo escreveu:
{
  "query": "dwarf blacksmith gravelly",
  "age": "old",
  "gender": "male",
  "use_case": "characters_animation"
}
Nada utilizável voltou. A biblioteca casa palavras literais nos nomes e descrições, então um nome de papel como dwarf é uma aposta sobre metadados que em geral não existem: catálogos de voz descrevem timbre, não personagens.
Então o modelo mudou de descrever a pessoa para descrever o som — gravelly, gruff e afins —, mantendo os filtros de idade e gênero. Isso produziu candidatos. Ele comparou traits e as descrições truncadas com a cena, conferiu configured_voice_id para não devolver a voz já em uso e então chamou text_to_speech com o voice_id escolhido e a fala.
Dois hábitos saem dessa execução. Descreva o som, não o papel — se uma busca por personagem volta vazia, não empilhe mais palavras de personagem; troque por adjetivos sobre a voz e estreite com filtros. E o modelo não ouve: ele lê texto sobre áudio, então quando a escolha importa ele te entrega os links de preview_url. Uma voz escolhida sem escutar é rascunho, não decisão.
O que isto deliberadamente não tocou
Os dois campos são injetados pelo hook de schema dinâmico que já existia, _tts_schema_overrides, que lê sua config toda vez que as definições de ferramentas são listadas. O hook não é novo; só o ramo do ElevenLabs cresceu.
As fronteiras são apertadas, e é por isso que esta é uma mudança pequena em vez de um novo comportamento:
- Os schemas de
text_to_speechpara Edge, OpenAI, xAI e os demais são idênticos aomainbyte por byte, e o snapshot do prompt padrão do provider não mudou. - Enviar
voice_idpara outro provider gera um aviso e o argumento é ignorado — a chamada ainda produz áudio. Isso importa num cenário exato: você guardou um schema em cache e depois trocou de provider. - Enviar
find_voicespara outro provider falha de forma limpa com um erro dizendo que precisa detts.provider: elevenlabs. Nenhum fallback silencioso para falar. - Um ID malformado é rejeitado antes de qualquer requisição sair do processo, contra
^[A-Za-z0-9]{8,64}$.
O custo de contexto é onde quem não usa ElevenLabs pode relaxar. Medido com get_tool_definitions, o schema de text_to_speech numa session ElevenLabs cresce de cerca de 410 tokens para cerca de 840. Em qualquer outra session o custo é 0 token, porque os acréscimos nunca entram no schema.
Duas correções vizinhas caíram no mesmo lote: find_voices={} deixou de cair em falar e agora significa navegar, e no gateway de áudio gerenciado o tts-1 e o tts-1-hd não são mais rebaixados em silêncio.
Três armadilhas
Vozes da biblioteca são recurso de plano pago. Sintetizar com um voice_id da biblioteca sem salvá-lo na sua conta é genuinamente prático, mas o caminho da API exige um plano pago da ElevenLabs. Com uma chave gratuita, a busca ainda pode devolver linhas que a chamada de síntese não consegue usar. O credit_rate na linha é o sinal de que a voz cobra acima da tarifa padrão.
Um bom nome não é uma boa voz. Os nomes da biblioteca são escritos por usuários: duas vozes chamadas algo como “Deep Narrator” podem diferir radicalmente em ritmo, respiração e consoantes. Escute o preview_url — uma voz encantadora por vinte segundos pode ser insuportável ao longo de quatro minutos de diálogo.
O cursor não é seu para montar. Percorra os resultados devolvendo next_page como page, literalmente. Reconstruir um offset, ou reutilizar um cursor do catálogo da conta contra a biblioteca, te dá duplicatas ou uma página em branco sem explicação.
O que você precisa para rodar
A mudança foi mesclada em 2026-10-25, depois da v0.22.5, que saiu em 2026-10-23. Está na main e não numa release com tag, então uma instalação comum da release mais recente não terá nenhum dos dois campos. Para testar agora, você roda a partir da main; o guia de instalação cobre o caminho via código-fonte.
Depois disso o fluxo é curto: buscar por timbre, escutar dois ou três clipes de preview_url, guardar os IDs de que você gostou, passá-los por chamada. A config fica onde estava, então uma voz para notificações e três para o curta coexistem na mesma instalação — o mesmo princípio de overrides de modelo por chamada, onde uma escolha pontual nunca mexe nos padrões em que você confia.
Se a latência virar o próximo problema depois da escalação de elenco, a mecânica de manter um pipeline de síntese aquecido e em streaming nos limites de frase está em o guia de keep-warm e streaming por frase; escolher uma voz não muda nada desse encanamento. E ligar fala a uma conversa de duas vias em vez de uma renderização única é outra decisão — veja o guia do modelo de voice chat.