Toda sessão congela ao mesmo tempo e o log continua limpo: o Hermes tira oito bloqueios medidos de cima do event loop
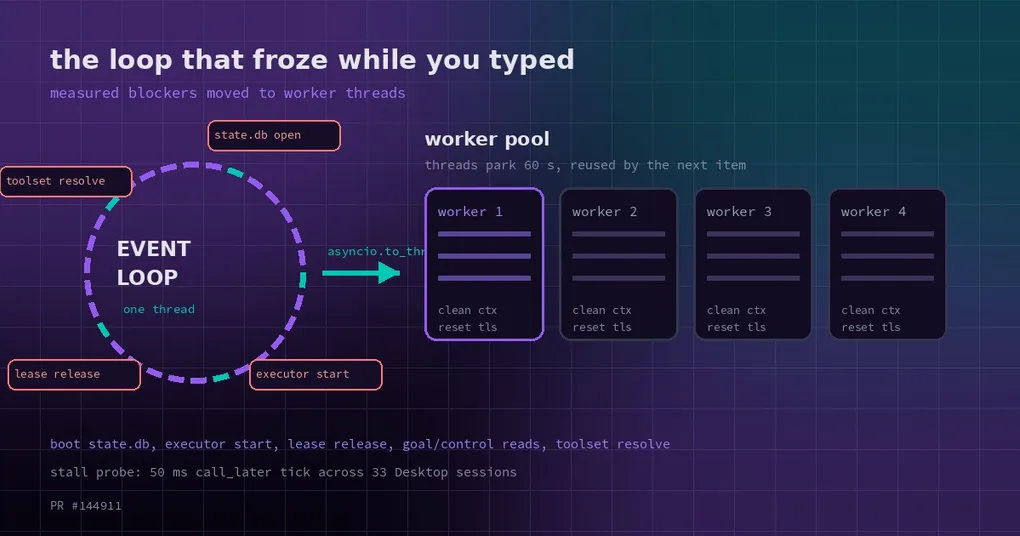
É uma quarta-feira à tarde e você está no meio de uma frase no Desktop quando a janela para de responder: o cursor continua piscando, mas nada chega, e a lista de sessões na barra lateral congela no meio da rolagem. Você espera trinta segundos e ela volta sozinha — ou reinicia o app e ela volta desse jeito. Aí abre o log para ver o que aconteceu e não há nada ali: nenhum aviso, nenhuma linha. Não foi o modelo nem a rede. O backend do Desktop, o gateway, roda em um event loop asyncio de thread única, e qualquer coisa que espere por disco nessa thread faz todas as sessões esperarem junto.
O event loop é um único caixa com todas as sessões na fila
O gateway é o processo por trás do Desktop. Ele cuida do armazenamento de sessões, das chamadas de ferramentas, do cron e do state.db de cada profile. Ele não abre uma thread por tarefa. Usa asyncio para revezar tudo em uma thread só — ler um frame de WebSocket, empurrar um token, gravar uma sessão, executar uma ferramenta — uma coisa por vez, cada uma rápida o bastante para parecer concorrente.
Esse modelo depende de uma premissa: cada uma dessas vezes tem que ser rápida. No instante em que uma delas espera por disco — abrir um banco, pegar um file lock, reescrever um blob JSON — a thread para e nada mais acontece. Suas teclas deixam de ecoar, uma resposta em streaming morre no meio da frase, um cron job que já devia ter rodado não dispara. O caixa foi lá para o fundo da loja procurar o produto. E I/O bloqueante não gera erro: ele só é lento. É por isso que o log fica limpo e por isso esse tipo de travamento é tão difícil de provar.
A outra metade da história — o que pega um loop que já travou — está em o watchdog do loop do gateway. Este texto aqui é sobre por que ele trava.
Oito bloqueios, todos medidos
O PR #144911 (mergeado em 2026-10-27, commit de merge b63fbbac4d27d1e4b8585ff7065e6dceb6207394) não chutou. Cada um dos oito corresponde a um caminho que alguém conseguia reproduzir, e juntos eles fecham as issues #141966, #142085 e #142061.
-
Leituras de sessão esperavam até 5 segundos pelo writer de tokens (#141966).
get_session,list_sessions_rich,get_recent_session_model_routeelist_gateway_sessionssão leituras puras, mas ficavam esperando um writer que estava no meio da gravação de um token — cinco segundos no pior caso. A correção dá às leituras um modo de flush próprio: na thread do loop ela nunca espera; fora da thread do loop, espera como antes. Só uma espera na thread do loop gasta o tempo de todo mundo para economizar o próprio. -
A sonda de liveness segurava o GIL no Windows (#142085, do contribuidor da comunidade @zwmaupin). Uma sonda psutil no Windows pode segurar o lock do interpretador tempo suficiente para a thread do loop não conseguir pegá-lo, o que é uma parada total do event loop. Essa veio de um resgate do fork do @zwmaupin, com a autoria preservada.
-
A inicialização abria o
state.dbde cada profile no loop. Cada abertura monta o schema e o índice FTS — mais ou menos um segundo por store — e isso acontecia na thread do loop, então mais profiles significavam um trecho morto maior na subida. Agoraopen_profile_storeabre dentro de uma thread com o escopo do profile vinculado nessa thread, os profiles secundários esquentam em paralelo, e o store de que a inicialização realmente precisa é fixado por um worker em volta deGatewayRunner(), então a abertura do próprio store vira um acerto no registry e nunca toca o arquivo. -
Cada submit ao executor iniciava uma thread nova no loop (#142061).
Thread.start()espera pelo GIL, ou seja, o próprio ato de repassar o trabalho já consumia tempo de loop. Este é o mais interessante dos oito e ganha uma seção própria abaixo. -
O carregamento do goal/loop manager e o snapshot do control-card depois de cada turn liam o
state.db, os dois no loop. -
A resolução de display/toolset por turn pegava o file lock do auth store. Agora passa por
asyncio.to_thread, com o contexto copiado carregando o escopo de profile daquele turn. -
restore_local_sessionesperava pelostore._lockem sessões vivas. Um worker gravando nostate.dbsegura esse lock, então restaurar uma sessão podia pendurar o loop inteiro atrás dele. A correção achou um buraco bem preciso: quando a rota já nomeia um alvo e esse alvo está na linhagem, o ramo com lock não faz absolutamente nada — esse caso agora retorna sem pegar o lock. -
A liberação do lease da sessão ativa no fim de cada turn fazia um file lock mais uma reescrita de JSON. Também saiu do loop.
Seis dos oito eram “encostar no disco dentro do loop”, um era “brigar pelo GIL dentro do loop” e um era “iniciar uma thread dentro do loop”. Se você guardar uma regra só disso tudo: nada que possa esperar pertence à thread do loop.
Estacionar uma thread por 60 segundos
Vale ler o item 4 com atenção, porque ele não realoca uma chamada — ele muda o comportamento de um pool.
O executor era simples: chega uma tarefa, sobe uma thread, a thread termina e morre. O pool é ilimitado por design (esse contrato, e o limite de threads do SO, continuam iguais), então sob carga ele ficava criando e enterrando threads o tempo todo, e cada Thread.start() entrava na fila atrás do GIL na thread do loop.
Agora um worker que termina não morre. Ele fica estacionado por 60 segundos (_IDLE_TIMEOUT_S = 60.0 no código). O próximo submit entrega a tarefa a um worker estacionado por meio de uma queue; uma thread só é criada quando não há worker parado esperando. O pool continua ilimitado, o contrato se mantém, e em regime estável praticamente nenhuma thread é criada.
O perigo de reaproveitar uma thread é o estado residual: um contextvar, uma flag de interrupt, um thread-local do trabalho anterior guiando silenciosamente o próximo. Foi aí que mora quase todo o cuidado desta mudança. Toda tarefa roda em um contextvars.Context vazio, e gateway/turn_thread_reset.py limpa o resíduo da thread:
- o bit de
tools.interruptda thread; - o reason e o yield do turn;
- o escopo de thread do cache de sudo;
- o namespace
threading.localdo turn.
Um worker que falha no reset se aposenta em vez de pegar mais trabalho — melhor uma thread a menos do que estado sujo vazando para o turn seguinte. O _threads continua listando só threads ocupadas, então a contagem de drenagem no shutdown não muda.
Atrasado tudo bem. Fora de ordem, não.
O custo que as pessoas esquecem ao jogar trabalho para threads é a ordenação. Três pontos aqui foram desenhados em torno disso.
Números de ticket para os snapshots. O snapshot do control-card agora é lido em um worker e publicado de forma assíncrona, mas publish_async pega um ticket no loop primeiro. Um snapshot que chega atrasado e já foi superado por uma publicação posterior é descartado, então a UI nunca vê dado velho pintado por cima do novo. A republicação por ferramenta continua síncrona, porque test_session_viewer_automation exige que ela termine dentro de um único passo do loop.
Um único worker ordenado para liberar lease. Toda liberação (file lock mais reescrita de JSON) vai para o mesmo worker ordenado. Se uma liberação chega depois do próximo acquire na mesma sessão, ela não faz nada — as entradas são descartadas por lease id, então uma liberação atrasada não pode atropelar o turn que acabou de pegar o slot. A docstring do módulo gateway/active_lease_io.py é explícita sobre a fronteira: só a escrita em arquivo é adiada; do ponto de vista deste processo o lease já está liberado quando release_soon retorna, então o próximo claim ainda vê o slot livre; mandar toda liberação por um único worker é o que mantém o descarte persistido na ordem de conclusão dos turns; e o caminho do registry é fixado no momento do acquire, então o worker não precisa de escopo de profile.
Contextos copiados carregam o escopo de profile. O to_thread do item 6 não é uma chamada solta — o contexto que ele copia carrega o escopo de profile daquele turn, senão a resolução de display/toolset dentro da thread cairia no profile padrão.
O fio comum: adiar só é seguro quando o resultado converge para o mesmo estado. Onde a ordem tem significado, pegue um ticket ou entre na fila.
Como verificar: meça quanto tempo o loop ficou parado, não quão lenta foi a requisição
Não dá para achar essa classe de bug com latência por requisição. Sob carga, toda requisição parece apenas lenta, enquanto o que o usuário sente é tudo parando de uma vez. Vale copiar a montagem de medição do PR:
Um gateway run --force de verdade em modo multiplex, 11 profiles, 33 sessões WebSocket simultâneas no formato do Desktop, um cron job por profile por minuto e um provider de tool-call em loopback. Duas sondas injetadas via sitecustomize: uma sonda de latência de loop com call_later de 50 ms, e um sampler de travamento que captura as stacks quando o loop para de girar, para você ver quem está esperando. Cada rodada dura 90 segundos, com PYTHONPATH fixando a árvore de código para você estar medindo o código que queria medir. Segundos de travamento = amostras de travamento do loop principal × 20 ms.
O ponto dessa montagem não são os números. É que ela mede quanto tempo o loop passou sem girar, que é o que seus dedos de fato sentem.
Faça o triage do mesmo jeito. Se só a digitação engasga enquanto as respostas continuam chegando, é o caminho de renderização — veja por que a digitação piora em sessões longas. Se digitação e respostas param juntas, voltam sozinhas depois de dezenas de segundos e deixam o log limpo, o loop estava ocupado. E se o lento é o momento em que você abre o app, aí é um terceiro problema, coberto em latência de startup e limpeza de scratch.
Quais versões, e o que fazer agora
A correção entrou na main em 2026-10-27. Se você acompanha o canal estável, ela chega na próxima release que a incluir; se quer hoje, passe a acompanhar a main. Das três issues, a #142085 é a que usuários de Windows reconhecem na hora — uma tool call começando e a interface inteira travando é essa assinatura.
Até lá, algumas coisas dão mais folga ao loop: menos janelas do Desktop abertas por muito tempo (cada uma é uma sessão WebSocket empurrando mensagens sem parar), desligar o cron dos profiles que você não usa e não empilhar dezenas de sessões simultâneas em um gateway. O ambiente de teste deste PR era de 11 profiles com 3 sessões cada — isso já é o caso de estresse.
A impressão digital desse tipo de travamento
Um modelo lento e um loop travado não se parecem em nada, e distinguir os dois é a maior parte do debugging. Modelo lento: os tokens chegam um a um, a UI segue responsiva, você consegue digitar e trocar de sessão. Loop travado: todas as sessões congelam ao mesmo tempo, inclusive as que não estão chamando modelo nenhum; o log não tem erro, porque bloquear não é exceção; e ele se recupera sozinho, porque a operação de disco acabou.
O terceiro caso é o pior, porque não é lentidão — é parada. E um event loop parado se parece exatamente com uma máquina quebrada, quando tudo o que ele estava fazendo era esperar por uma escrita em arquivo. O que esta mudança faz é mandar essa escrita esperar em outro lugar.