桌面端突然集体卡死,日志里却一片干净:Hermes 把八个实测到的阻塞点搬出了事件循环
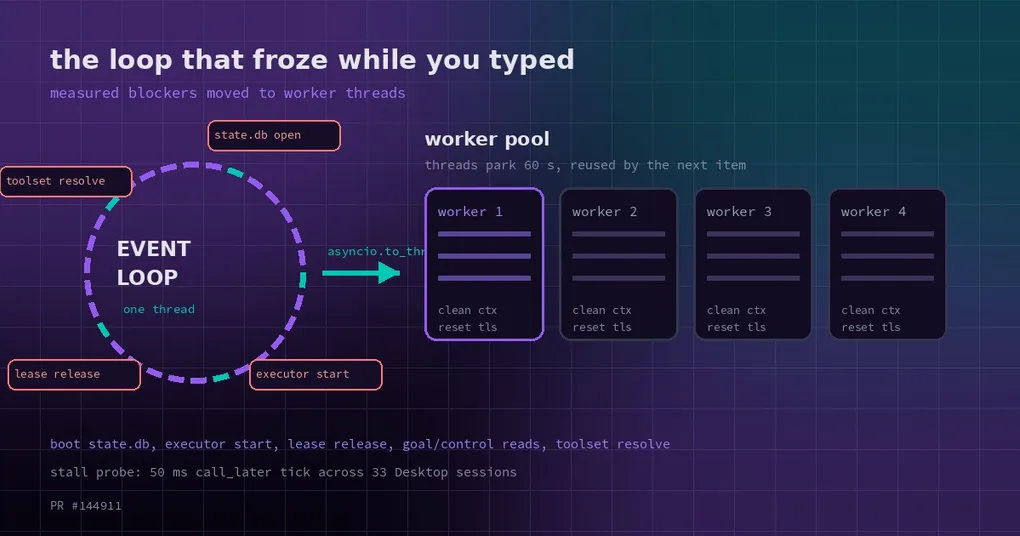
周三下午,你在 Desktop 里敲一句话,敲到一半界面不动了:光标还在闪,字不出来,侧边栏的会话列表也停在原处。你等了半分钟,它自己缓过来了,或者你干脆重启了一遍。然后你去看日志,想找一条错——什么都没有,连一条 warn 都没有。这不是模型慢,也不是网络抖:Hermes 的 Desktop 后端(gateway)跑在一个单线程的 asyncio 事件循环上,只要有谁在这个线程上等一次磁盘,所有会话就得陪着一起排队。
事件循环:一个收银台,后面排着所有会话
gateway 是 Desktop 背后的那个进程。会话的存取、工具调用、cron、每个 profile 的 state.db,都归它管。它没有开一堆线程各干各的,而是用 asyncio 在一个线程里轮流处理所有任务:读一段 WS 消息、推一个 token、写一次会话、跑一次工具——一件一件来,每件都很快,所以看起来像同时在跑。
这个模型有个前提:每一件都必须很快。只要某一件在等磁盘(打开数据库、拿文件锁、重写一个 JSON),这个线程就原地站着,别的什么也做不了。你打字没回显、流式回复断在半句、cron 该触发没触发,全是因为收银员正在后仓找货。而阻塞 I/O 不会抛错,它只是慢——所以日志里什么都不会有,这就是这类卡顿最让人抓狂的地方。
顺带说一句区分:gateway 的循环看门狗讲的是「卡住之后谁来救」,这篇讲的是「为什么会卡」。
八处阻塞点,全是实测出来的
PR #144911(2026-10-27 合入,merge commit b63fbbac4d27d1e4b8585ff7065e6dceb6207394)没有靠猜。八项都对应线上能复现的路径,修掉的是 #141966、#142085、#142061 三个 issue。
-
读会话时会等 token writer,最多 5 秒(#141966)。
get_session、list_sessions_rich、get_recent_session_model_route、list_gateway_sessions这些纯读路径,会等一个正在写 token 的 writer 落盘,最坏情况 5 秒。修法是给读路径单独做一种「读专用 flush」:在循环线程上永不等待,不在循环线程上时照常等待——因为只有循环线程上的等待才是在拿所有人的时间换自己的方便。 -
Windows 上的进程存活探测攥着 GIL(#142085,来自社区贡献者 @zwmaupin)。psutil 的探测在 Windows 上会长时间占住解释器锁,循环线程拿不到 GIL,等于整条循环停摆。这条是从 @zwmaupin 的 fork 分支 salvage 进来的,作者署名保留。
-
启动时在循环上逐个打开 profile 的 state.db。每次打开要建 schema、建 FTS 索引,单个 store 大约 1 秒,而这件事原来就发生在循环线程上——profile 越多,启动那一段「假死」越长。现在
open_profile_store在线程里打开,profile scope 在这个线程内绑定;次要 profile 并发预热;启动真正要用的那个 store 由 worker 在GatewayRunner()外围先固定,于是 store 自己的 open 变成一次 registry 命中,根本不用真去开库。 -
每次往 executor 提交任务,都要在循环上起一个新线程(#142061)。
Thread.start()要等 GIL——也就是说「派活」这个动作本身就在花循环的时间。这条改得最巧,下一节单独讲。 -
每轮结束后的 goal/loop manager 加载与控制卡快照。两件事都要读 state.db,原来都在循环上。
-
每轮的 display/toolset 解析要拿 auth store 的文件锁。现在走
asyncio.to_thread,复制的 context 里带上这一轮的 profile scope。 -
restore_local_session对活会话等store._lock。往 state.db 写东西的 worker 线程会持有这把锁,于是「恢复一个会话」可能把整个循环挂在等锁上。修法挑了一个很精确的漏洞:当路由已经指定了目标、并且目标就在 lineage 里时,那个持锁分支本来什么都不做——这种情形现在直接返回,不取锁。 -
每轮结束时的 active-session lease 释放。释放要做文件锁加 JSON 重写,同样从循环上挪走。
八处里有六处是「在循环上碰磁盘」,一处是「在循环上抢 GIL」,一处是「在循环上起线程」。如果你只记一句:循环线程上不该出现任何会等的东西。
60 秒停驻:把「起线程」这件事摊平
第 4 条最值得看,因为它不是搬走一个调用,而是改了一个池的行为。
原来的 executor 很简单:来一个任务,起一个线程,线程干完就死。线程池本身无上限(这是设计契约,OS 线程上限也照旧),所以负载一高就是持续地起线程、死线程——每次 Thread.start() 都要在循环线程上等一次 GIL。
改完之后,干完活的 worker 不死了,它停驻(park)60 秒(代码里是 _IDLE_TIMEOUT_S = 60.0)。下一次 submit 时,如果队列里有停驻的 worker,就把任务交给它;只有在没有停驻 worker 的时候,才新建线程。池仍然无上限,契约没变,但稳态下几乎没有线程被创建。
复用线程最怕的是脏状态:上一个任务留下的 contextvar、中断标志、线程局部变量,会悄悄影响下一个任务。这块是这次改动里最费心的部分——每个任务都在一个空的 contextvars.Context 里跑,而 gateway/turn_thread_reset.py 负责把本线程上的这些痕迹清掉:
- 本线程的
tools.interrupt位; - 这一轮的 reason 与 yield;
- sudo 缓存里的 thread scope;
- 每轮的
threading.local命名空间。
重置失败的 worker 直接退休,不再接活——宁可少一个线程,也不让脏状态流进下一轮。另外 _threads 仍然只列忙碌线程,所以关闭时那个「静默等待」的计数逻辑不用改。
可以晚,但不能乱
把工作挪到线程里,最容易被忽视的代价是顺序。这次有三处专门为顺序做了设计:
发布快照取号。 每轮结束后的控制卡快照现在在 worker 里读、异步发布,但 publish_async 会在循环上先取一张 ticket。晚到、但已经被更晚一次发布覆盖的快照直接丢弃——所以界面看到的永远是新一轮,而不是老数据盖掉新数据。每工具的重发布仍然保持同步,因为 test_session_viewer_automation 要求它在一个循环步内完成。
lease 释放交给一个 worker。 释放的动作(文件锁 + JSON 重写)全部投给同一个有序 worker。如果某次释放在同一会话的下一次 acquire 之后才落地,就什么都不做——条目按 lease id 丢弃,晚到的释放不会误伤刚拿到槽位的新一轮。gateway/active_lease_io.py 的模块 docstring 把边界写得很清楚:只有那次文件写入被延后,lease 在 release_soon 返回之前就已经从本进程视角释放了,所以下一次 claim 仍然看到槽位空闲;所有释放走同一个 worker,才能保证持久化层面的丢弃按轮结束顺序落地;而 lease 在获取时已经固定了 registry 路径,worker 不需要 profile scope。
复制的 context 带 profile scope。 第 6 条那个 to_thread 不是裸调用,它复制的 context 里带着该轮的 profile scope,否则线程里解析 display/toolset 会落到默认 profile 上。
这三处的共同点:延迟只允许发生在「结果最终收敛到同一个状态」的地方。顺序有语义的,就取号或者排队。
怎么验证:别测单次请求,测循环多久没转
这类问题用「单次请求耗时」是测不出来的——有负载的时候,每个请求看起来都只是慢一点,而用户感受到的是「全体停住」。PR 里的实测方法值得抄:
一次真实的 gateway run --force,multiplex 模式,11 个 profile,33 个并发的 Desktop 形态 WS 会话,每个 profile 每分钟一个 cron 任务,外加一个 loopback 的工具调用 provider。然后用 sitecustomize 注入两个探针:一个 50 ms 的 call_later 环延迟探针,一个 stall 栈采样器(循环卡住时把栈抓下来,看是谁在等)。每一轮跑 90 秒,用 PYTHONPATH 固定代码树,保证测的是你想测的那份代码。stall 秒数 = 主循环 stall 采样数 × 20 ms。
这套 setup 的重点不是数字,而是它测的是「循环有多久没转」,而不是「某个请求有多慢」。前者才是你手指感觉到的东西。
自己排查时也按这个逻辑分诊:只有打字卡、回复照常到,那是渲染路径的问题,看 长会话打字变慢那篇;打字和回复一起停、几十秒后自己恢复、日志干净,才是循环被占住;而如果慢的是「启动那一下」,那是第三个问题,见 启动延迟与 scratch 清理。
受影响版本与你现在能做什么
修复在 2026-10-27 合入 main。如果你的安装跟的是稳定通道,它会在下一个带上这次改动的版本里到你这儿;急着要的话可以切到跟 main 的通道。三个 issue 里,#142085 那条 Windows 上的 GIL 问题对 Windows 用户体感最明显——如果你在 Windows 上遇到「一开工具调用,整个界面就木」,那基本就是它。
在那之前,有几件事能让循环轻松一点:少开几个长期挂着的 Desktop 窗口(每个都是一个持续推消息的 WS 会话)、把不用的 profile 的 cron 关掉、别在同一个 gateway 上堆几十个并发会话——这次 PR 的测试环境就是 11 个 profile × 3 个会话的规模,那已经是压力位了。
这类卡顿的指纹
模型慢和循环卡,症状完全不同,分清楚能省掉一半排查时间。模型慢:token 一个一个来,界面照常响应,你能打字、能切会话。循环卡:所有会话同时冻住,包括那些根本没在调模型的会话;日志里没有错误,因为阻塞不是异常;几十秒后自己恢复,因为那次磁盘操作终于做完了。
第三种情况最坑:它不是「慢」,是「停」。而一个停住的循环,看上去和一台坏掉的机器没有区别——但它其实只是在等一次文件写入。这次改动做的事,就是让那次写入去别的地方等。