Der Stream tröpfelt weiter und endet nie: ein optionales Gesamt-Lebensdauer-Limit für eine Antwort
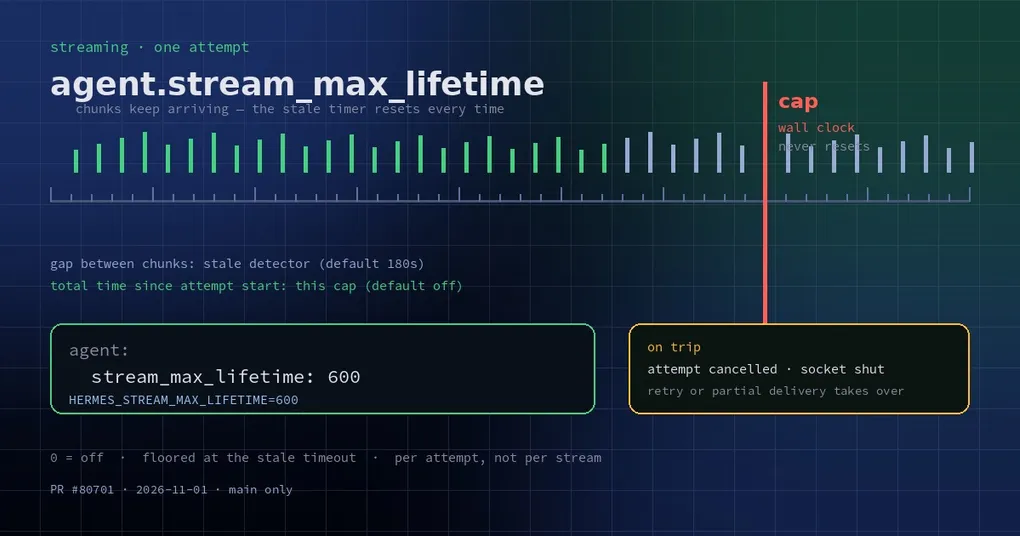
Es ist 22 Uhr. Du schickst eine Anfrage ab, und Text beginnt zu erscheinen. Wort für Wort, brav und ordentlich, und es hört nicht auf. Zwanzig Minuten später blinkt der Cursor immer noch und der Spinner dreht sich weiter — du wagst nicht, Ctrl-C zu drücken (du würdest verlieren, was schon generiert wurde), und du hast keine Möglichkeit zu erkennen, ob da gerechnet wird oder ob es einfach im Kreis läuft.
Dieses Hängen im Zustand „gleich fertig“ ist schlimmer als ein sauberer Fehlschlag. Ein sauberer Fehlschlag hat wenigstens einen Watchdog: Kommen lange genug keine Daten, gilt die Verbindung als tot und wird erneut versucht. Dieser Stream hier gibt aber alle paar Sekunden ein bisschen etwas von sich, also wird der Watchdog jedes Mal gefüttert und schlägt nie an.
Zwei Arten, wie ein Stream hängen kann — nur eine war abgedeckt
Hermes hat mehrere Timeout-Schichten fürs Streaming. Zwei davon sind hier relevant:
- Socket-Read-Timeout (Standard 120s): wie lange ohne jegliche Bytes, bevor die Verbindung als kaputt gilt.
- Stale-Stream-Erkennung (Standard 180s): wie lange ohne neuen Chunk, bevor der Stream als festgefahren gilt und für einen Reconnect gekillt wird.
Wichtig ist die Definition der zweiten: Sie misst den Abstand zwischen Chunks und setzt sich bei jedem Chunk zurück. Das ist Absicht — ein Modell, das intensiv nachdenkt, darf durchaus Dutzende Sekunden still sein, und es für Stille zu killen wäre falsch. Genau das hinterlässt aber einen blinden Fleck:
| Ausfallmuster | Wie es aussieht | Hat die alte Logik es erfasst |
|---|---|---|
| Totale Stille | Überhaupt keine Chunks | Ja — die Stale-Erkennung killt den Stream nach 180s |
| Tröpfeln ohne Ende | Alle paar Sekunden ein bisschen Daten, kein Abschluss | Nein — jeder Chunk setzt die Uhr zurück |
Das zweite Muster kommt in der Praxis vor: ein Relay-Gateway, das die Antwort in winzige Stücke hackt, ein Upstream, der mitten in der Generierung in eine Schleife gerät, eine Proxy-Schicht, die endlos Keep-Alive-Heartbeats schickt, ohne den Inhalt voranzubringen. Dein Turn sitzt da, hält die Session und das Token-Budget und liefert nichts.
Der neue Knopf: ein Limit pro Versuch
Die neu gemergte Änderung führt eine Opt-in-Einstellung ein: agent.stream_max_lifetime bzw. die Umgebungsvariable HERMES_STREAM_MAX_LIFETIME. Sie misst die Wall-Clock-Zeit seit Beginn des aktuellen Streaming-Versuchs und setzt sich nie zurück, wenn ein Chunk ankommt.
agent:
  stream_max_lifetime: 600   # Sekunden; 0 = aus (Standard)
Oder pro Prozess:
HERMES_STREAM_MAX_LIFETIME=600 hermes gatewayDer Standard ist 0, also aus, und dieser Default ist bewusst so gewählt: Ein Modell mit langem Reasoning, das legitim Dutzende Minuten streamt, darf nicht von einer pauschalen Zahl abgeschnitten werden.
Die Verhaltensdetails sind es wert, gekannt zu werden, weil sie entscheiden, ob das Limit dann greift, wenn du es willst:
- Pro Versuch berechnet: Jeder Retry ist ein frischer Versuch mit vollem Budget; die Zeit des vorherigen Versuchs wird nicht übertragen.
- Nach unten auf den Stale-Timeout begrenzt: Das Limit wird auf den effektiven Stale-Stream-Timeout angehoben, sodass es niemals früher greifen kann als die Erkennung, die ohnehin schon wartet, und keinen Stream abschneiden kann, der bloß still ist.
- Wie ein Stale-Stream gekillt: Der Versuch wird abgebrochen, der request-lokale Client abgebrochen, sein Socket geschlossen, und der Cross-Turn-Stale-Breaker zählt es einmal.
- Recovery passiert weiterhin: Die Retry-Schleife verbindet neu, oder die Teilauslieferung läuft mit dem weiter, was schon generiert wurde — der bereits gelesene Text wird nicht weggeworfen.
Wenn es greift, benennt die Fehlermeldung die Einstellung, statt vage den Endpoint zu beschuldigen:
Response still streaming after 612s, cut by agent.stream_max_lifetime (600s).
Raise agent.stream_max_lifetime, or set it to 0 to turn the cap off,
if this model legitimately streams this long.
Wie es sich zwischen die anderen Timeout-Schichten einfügt
Streaming-Timeouts sind in Hermes geschichtet. Man sollte sie nicht zu einer einzigen Zahl zusammenziehen:
| Schicht | Standard | Was sie macht | Wo man sie setzt |
|---|---|---|---|
| Socket-Read-Timeout | 120s | Gar keine Bytes bedeuten eine kaputte Verbindung | HERMES_STREAM_READ_TIMEOUT |
| Stale-Stream-Erkennung | 180s | Zu lange zwischen Chunks bedeutet einen hängenden Stream | HERMES_STREAM_STALE_TIMEOUT |
| Stream Max Lifetime | Aus (0) | Gesamtes Wall-Clock-Limit pro Versuch | agent.stream_max_lifetime / HERMES_STREAM_MAX_LIFETIME |
| Reconnect-Versuche | 3 | Wie oft mitten im Stream neu verbunden wird | HERMES_STREAM_RETRIES |
| Stale-Circuit-Breaker | 5 in Folge | Nach wiederholten Kills ohne fertige Antwort lieber schnell scheitern statt erneut warten | HERMES_STREAM_STALE_GIVEUP |
Das mentale Modell: Der Read-Timeout deckt „gar nichts“, die Stale-Erkennung deckt „zu lange still“, das Max Lifetime deckt „immer in Bewegung, nie fertig“, und der Breaker deckt „das scheitert dauernd, hör auf zu warten“.
Welchen Wert wählen
- Langes lokales Reasoning oder riesige Prefills: bei
0lassen. Solche Streams sind langsam, aber legitim, und ein hartes Limit würde echte Arbeit abschneiden. - Gateway- und Bot-Setups: Die Relay-Qualität liegt nicht in deiner Hand, also setze einen Wert, ab dem weiteres Warten keinen Nutzen mehr hat — 300 bis 900 Sekunden sind ein vernünftiger Bereich. Darüber hinaus ist ein Reconnect meist mehr wert als mehr Geduld.
- Unbeaufsichtigte Automatisierung (Cron, Batch-Jobs): ein explizites Limit setzen, statt später aus Logs rekonstruieren zu müssen, warum ein Turn drei Stunden hing.
- Nicht unter den Stale-Timeout setzen: Es wird ohnehin auf den Stale-Timeout angehoben, eine kleinere Zahl ist also wirkungslos. Willst du aggressiver sein, senke zusätzlich
HERMES_STREAM_STALE_TIMEOUT.
Eine bekannte Grenze: Der Bedrock-Polling-Stream (der Pfad in chat_completion_helpers.py) ist nicht abgedeckt — diese Datei darf nicht wachsen. Auf Bedrock greift diese Schicht also noch nicht.
Es gibt außerdem ein Sicherheitsnetz, das man kennen sollte: Wird derselbe Versuch dreimal gekillt und löst sich trotzdem nicht auf (ein Worker hängt dort, wo Cancellation ihn nicht erreicht), gibt der Monitor den Worker auf und meldet die Anfrage als abgebrochen, statt sie in jedem Fenster erneut zu killen und den ganzen Turn für immer zu blockieren.
Status und weiterführende Lektüre
Die Obergrenze wurde am 2026-11-01 gemergt (PR #80701) und ist mit v0.22.6 (2026-11-02) in ein Release gekommen – ein Update bringt sie; v0.22.5 und älter haben sie nicht.
Eine Klarstellung: Es behebt „wird nie fertig“, nicht „bereits gelesener Text wird verworfen“. Diese zweite Klasse ist ein Problem der Auslieferungsschicht und wird in der Streaming-Delivery-Rundschau behandelt. Wenn dein Stillstand auf einem lokalen Modellserver passiert — der Server selbst hängt, statt dass der Stream tröpfelt —, fang mit einem lokalen Modellserver, der offline geht an. Für das größere Timeout-Bild siehe die Referenz zum config-Befehl und den Gateway-Loop-Watchdog.