Le flux continue de goutter et ne se termine jamais : un plafond optionnel de durée de vie totale pour une réponse
Il est 22 h. Vous envoyez une requête et du texte commence à apparaître. Un mot à la fois, consciencieusement, et ça ne se termine jamais. Vingt minutes plus tard, le curseur clignote encore et le spinner tourne toujours — vous n’osez pas faire Ctrl-C (vous perdriez ce qui a déjà été généré), et vous n’avez aucun moyen de savoir s’il calcule ou s’il tourne simplement à vide.
Ce blocage « toujours presque fini » est pire qu’un échec net. Un échec net a au moins un chien de garde : si aucune donnée n’arrive pendant assez longtemps, la connexion est déclarée morte et retentée. Mais ce flux-là laisse échapper un petit quelque chose toutes les quelques secondes, donc le chien de garde est nourri à chaque fois et ne se déclenche jamais.
Deux façons pour un flux de se bloquer, et une seule était couverte
Hermes dispose de couches de timeout pour le streaming. Deux comptent ici :
- Timeout de lecture du socket (120 s par défaut) : combien de temps sans aucun octet avant que la connexion soit considérée comme rompue.
- Détection de flux bloqué (180 s par défaut) : combien de temps sans nouveau chunk avant que le flux soit déclaré bloqué et tué pour une reconnexion.
Le point important, c’est la définition de la seconde : elle mesure l’écart entre les chunks, et elle se réinitialise à chaque chunk. Cette conception est délibérée — un modèle qui réfléchit intensément peut légitimement se taire pendant des dizaines de secondes, et le tuer pour son silence serait une erreur. Mais elle laisse un angle mort :
| Mode de défaillance | À quoi ça ressemble | L’ancienne logique l’attrapait-elle |
|---|---|---|
| Silence total | Aucun chunk du tout | Oui — la détection de flux bloqué le tue après 180 s |
| Goutte-à-goutte sans fin | Un peu de données toutes les quelques secondes, aucune fin | Non — chaque chunk remet l’horloge à zéro |
Le second mode arrive dans la vraie vie : une gateway relais qui découpe la réponse en menus morceaux, un amont qui tombe dans une boucle au milieu de la génération, une couche proxy qui envoie des heartbeats keep-alive sans faire avancer le contenu. Votre tour reste là, à occuper la session et le budget de tokens, sans rien livrer.
Le nouveau réglage : un plafond par tentative
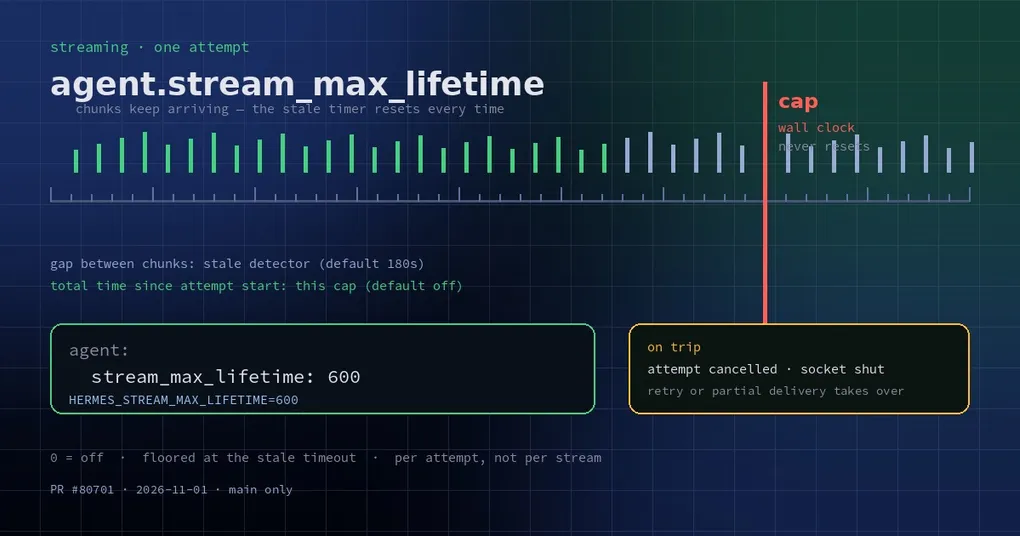
Le changement récemment fusionné ajoute un paramètre optionnel : agent.stream_max_lifetime, ou la variable d’environnement HERMES_STREAM_MAX_LIFETIME. Il mesure le temps réel écoulé depuis le début de la tentative de streaming en cours, et il ne se réinitialise jamais à l’arrivée d’un chunk.
agent:
  stream_max_lifetime: 600   # secondes ; 0 = désactivé (par défaut)
Ou par processus :
HERMES_STREAM_MAX_LIFETIME=600 hermes gatewayLa valeur par défaut est 0, c’est-à-dire désactivé, et ce choix est intentionnel : un modèle à raisonnement long qui streame légitimement pendant des dizaines de minutes ne doit pas être coupé par un chiffre universel.
Les détails de comportement valent la peine d’être connus, car ils décident si le plafond se déclenche quand vous le voulez :
- Facturé par tentative : chaque retry est une nouvelle tentative avec un budget complet ; le temps de la tentative précédente n’est pas reporté.
- Plancher au timeout de flux bloqué : le plafond est relevé jusqu’au timeout effectif de flux bloqué, il ne peut donc jamais se déclencher avant le détecteur déjà en attente, ni couper un flux simplement silencieux.
- Tué comme un flux bloqué : la tentative est annulée, le client local à la requête abandonné, son socket fermé, et le disjoncteur inter-tours le compte une fois.
- La reprise a toujours lieu : la boucle de retry se reconnecte, ou la livraison partielle continue depuis ce qui a déjà été généré — le texte que vous avez déjà lu n’est pas jeté.
Quand il se déclenche, l’erreur nomme le paramètre au lieu de blâmer vaguement l’endpoint :
Response still streaming after 612s, cut by agent.stream_max_lifetime (600s).
Raise agent.stream_max_lifetime, or set it to 0 to turn the cap off,
if this model legitimately streams this long.
Comment il se situe parmi les autres couches de timeout
Les timeouts de streaming dans Hermes sont empilés en couches. Ne les réduisez pas à un seul chiffre :
| Couche | Défaut | Ce qu’elle fait | Où la régler |
|---|---|---|---|
| Timeout de lecture du socket | 120 s | Aucun octet du tout signifie une connexion rompue | HERMES_STREAM_READ_TIMEOUT |
| Détection de flux bloqué | 180 s | Trop longtemps entre deux chunks signifie un flux coincé | HERMES_STREAM_STALE_TIMEOUT |
| Durée de vie max du flux | Désactivé (0) | Plafond total en temps réel par tentative | agent.stream_max_lifetime / HERMES_STREAM_MAX_LIFETIME |
| Tentatives de reconnexion | 3 | Combien de fois se reconnecter en cours de flux | HERMES_STREAM_RETRIES |
| Disjoncteur de flux bloqué | 5 consécutifs | Après des kills répétés sans réponse complétée, échouer vite au lieu d’attendre encore | HERMES_STREAM_STALE_GIVEUP |
Le modèle mental : le timeout de lecture couvre « rien du tout », la détection de flux bloqué couvre « silencieux trop longtemps », la durée de vie max couvre « toujours en mouvement, jamais fini », et le disjoncteur couvre « ça n’arrête pas d’échouer, arrête d’attendre ».
Quelle valeur choisir
- Raisonnement local long ou préfills énormes : laissez à
0. Ces flux sont lents mais légitimes, et un plafond dur couperait du vrai travail. - Configurations gateway et bot : la qualité du relais ne dépend pas de vous, fixez donc une valeur au-delà de laquelle attendre plus n’a aucune valeur — 300 à 900 secondes est une plage raisonnable. Au-delà, une reconnexion vaut généralement mieux que plus de patience.
- Automatisation sans surveillance (cron, jobs batch) : fixez un plafond explicite plutôt que de reconstituer depuis les logs pourquoi un tour est resté bloqué trois heures.
- Ne le réglez pas sous le timeout de flux bloqué : il est de toute façon relevé au niveau du timeout de flux bloqué, donc un chiffre plus petit ne fait rien. Pour être plus agressif, baissez aussi
HERMES_STREAM_STALE_TIMEOUT.
Une limite connue : le flux par polling de Bedrock (le chemin chat_completion_helpers.py) n’est pas couvert — ce fichier n’a pas le droit de grossir. Sur Bedrock, cette couche ne s’applique pas encore.
Il y a aussi un filet de sécurité à connaître : si la même tentative est tuée trois fois et ne se dénoue toujours pas (un worker coincé là où l’annulation ne peut pas l’atteindre), le moniteur abandonne le worker et signale la requête comme abandonnée au lieu de la re-tuer à chaque fenêtre et de bloquer tout le tour indéfiniment.
Statut et lectures associées
La limite a été fusionnée le 2026-11-01 (PR #80701) et figure dans la v0.22.6 (2026-11-02) : une mise à jour suffit ; la v0.22.5 et les versions antérieures ne l’ont pas.
Une clarification : il corrige « ne se termine jamais », pas « le texte déjà lu est jeté ». Cette seconde catégorie est un problème de couche de livraison, traité dans le tour d’horizon de la livraison en streaming. Si votre blocage se produit sur un serveur de modèle local — le serveur lui-même figé plutôt que le flux qui goutte — commencez par un serveur de modèle local hors ligne. Pour une vue d’ensemble des timeouts, voir la référence de la commande config et le watchdog de boucle de la gateway.