El stream sigue goteando y nunca termina: un límite de vida total opcional para una respuesta
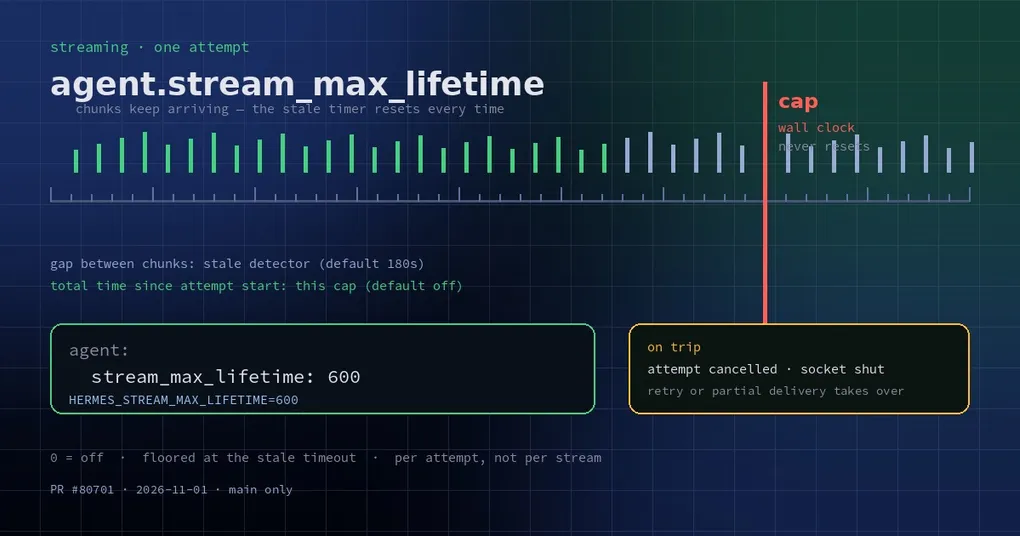
Son las 10 de la noche. Envías una petición y el texto empieza a aparecer. Una palabra cada vez, con toda la diligencia del mundo, y no termina nunca. Veinte minutos después el cursor sigue parpadeando y el spinner sigue girando: no te atreves a pulsar Ctrl-C (perderías lo ya generado) y no tienes forma de saber si está calculando o simplemente girando en el sitio.
Ese cuelgue de “siempre a punto de acabar” es peor que un fallo limpio. Un fallo limpio al menos tiene un vigilante: si no llega ningún dato durante el tiempo suficiente, la conexión se declara muerta y se reintenta. Pero este stream suelta un poquito cada pocos segundos, así que el vigilante recibe comida cada vez y nunca salta.
Dos formas de que un stream se cuelgue, y solo una estaba cubierta
Hermes tiene varias capas de timeout para streaming. Aquí importan dos:
- Timeout de lectura del socket (120 s por defecto): cuánto tiempo sin ningún byte antes de considerar que la conexión está rota.
- Detección de stream estancado (180 s por defecto): cuánto tiempo sin un fragmento nuevo antes de declarar que el stream está atascado y matarlo para reconectar.
Lo importante es la definición de la segunda: mide el hueco entre fragmentos y se reinicia con cada fragmento. Ese diseño es deliberado: un modelo que piensa mucho puede callarse legítimamente durante decenas de segundos, y matarlo por silencio sería un error. Pero deja un punto ciego:
| Modo de fallo | Cómo se ve | ¿Lo detectaba la lógica anterior? |
|---|---|---|
| Silencio total | Ningún fragmento | Sí: la detección de estancamiento lo mata a los 180 s |
| Goteo sin final | Un poco de datos cada pocos segundos, sin final | No: cada fragmento reinicia el reloj |
El segundo modo ocurre en el mundo real: una gateway intermedia que trocea la respuesta en pedazos diminutos, un upstream que entra en algún bucle a mitad de la generación, una capa de proxy que sigue enviando heartbeats de keep-alive sin hacer avanzar el contenido. Tu turno se queda ahí, ocupando la sesión y el presupuesto de tokens, sin entregar nada.
La nueva opción: un límite por intento
El cambio recién fusionado añade un ajuste opcional: agent.stream_max_lifetime, o la variable de entorno HERMES_STREAM_MAX_LIFETIME. Mide el tiempo de reloj de pared desde que empezó el intento de streaming actual, y nunca se reinicia cuando llega un fragmento.
agent:
  stream_max_lifetime: 600   # seconds; 0 = off (default)
O por proceso:
HERMES_STREAM_MAX_LIFETIME=600 hermes gatewayEl valor por defecto es 0, es decir, desactivado, y ese valor es intencionado: un modelo de razonamiento largo que transmite legítimamente durante decenas de minutos no debe quedar cortado por una cifra única para todos.
Los detalles de comportamiento merecen conocerse, porque deciden si salta cuando tú quieres:
- Se cuenta por intento: cada reintento es un intento nuevo con un presupuesto completo; el tiempo del intento anterior no se arrastra.
- Tiene un suelo en el timeout de estancamiento: el límite se eleva hasta el timeout efectivo de stream estancado, así que nunca puede saltar antes de lo que habría saltado el detector que ya estaba esperando, ni cortar un stream que solo está callado.
- Se mata como un stream estancado: se cancela el intento, se aborta el cliente local de la petición, se cierra su socket, y el disyuntor de estancamiento entre turnos lo cuenta una vez.
- La recuperación sigue ocurriendo: el bucle de reintentos reconecta, o la entrega parcial continúa desde lo ya generado; el texto que ya leíste no se tira.
Cuando salta, el error nombra el ajuste en lugar de culpar vagamente al endpoint:
Response still streaming after 612s, cut by agent.stream_max_lifetime (600s).
Raise agent.stream_max_lifetime, or set it to 0 to turn the cap off,
if this model legitimately streams this long.
Cómo encaja entre las demás capas de timeout
Los timeouts de streaming en Hermes van por capas. No las reduzcas a un solo número:
| Capa | Por defecto | Qué hace | Dónde se configura |
|---|---|---|---|
| Timeout de lectura del socket | 120 s | Ningún byte significa conexión rota | HERMES_STREAM_READ_TIMEOUT |
| Detección de stream estancado | 180 s | Demasiado tiempo entre fragmentos significa stream atascado | HERMES_STREAM_STALE_TIMEOUT |
| Vida máxima del stream | Desactivado (0) | Límite total de reloj de pared por intento | agent.stream_max_lifetime / HERMES_STREAM_MAX_LIFETIME |
| Reintentos de reconexión | 3 | Cuántas veces reconectar a mitad de stream | HERMES_STREAM_RETRIES |
| Disyuntor de estancamiento | 5 consecutivos | Tras varios cortes sin respuesta completa, fallar rápido en lugar de volver a esperar | HERMES_STREAM_STALE_GIVEUP |
El modelo mental: el timeout de lectura cubre “nada en absoluto”, la detección de estancamiento cubre “silencio demasiado largo”, la vida máxima cubre “siempre moviéndose, nunca terminando” y el disyuntor cubre “esto falla una y otra vez, deja de esperar”.
Qué valor elegir
- Razonamiento local largo o prefills enormes: déjalo en
0. Esos streams son lentos pero legítimos, y un límite duro cortaría trabajo real. - Montajes con gateway y bots: la calidad del relay no está en tu mano, así que pon un valor a partir del cual esperar más no aporte nada; entre 300 y 900 segundos es un rango razonable. Más allá, normalmente vale más una reconexión que más paciencia.
- Automatización sin supervisión (cron, trabajos por lotes): pon un límite explícito en lugar de reconstruir a partir de los logs por qué un turno estuvo colgado tres horas.
- No lo pongas por debajo del timeout de estancamiento: de todos modos se eleva hasta ese timeout, así que un número menor no hace nada. Para ser más agresivo, baja también
HERMES_STREAM_STALE_TIMEOUT.
Un límite conocido: el stream de sondeo de Bedrock (la ruta de chat_completion_helpers.py) no está cubierto; ese archivo no puede crecer. En Bedrock, esta capa todavía no se aplica.
También hay una red de seguridad que conviene conocer: si el mismo intento se mata tres veces y sigue sin desenrollarse (un worker atascado donde la cancelación no llega), el monitor abandona el worker e informa la petición como abandonada, en lugar de volver a matarlo en cada ventana y bloquear el turno para siempre.
Estado y lecturas relacionadas
El límite se fusionó el 2026-11-01 (PR #80701) y ya está en la v0.22.6 (2026-11-02): actualizando lo tienes; la v0.22.5 y anteriores no.
Una aclaración: arregla el “nunca termina”, no el “se descarta el texto ya leído”. Esa segunda clase es un problema de la capa de entrega, tratado en el repaso de entrega de streaming. Si tu bloqueo ocurre en un servidor de modelos local —el servidor mismo se quedó trabado, no el stream goteando—, empieza por un servidor de modelos local caído. Para el panorama general de timeouts, consulta la referencia del comando config y el vigilante del bucle de la gateway.