Code-Ausführung vom Laptop auslagern: persistente Sandboxen und parallele Batches mit Hermes + Flame
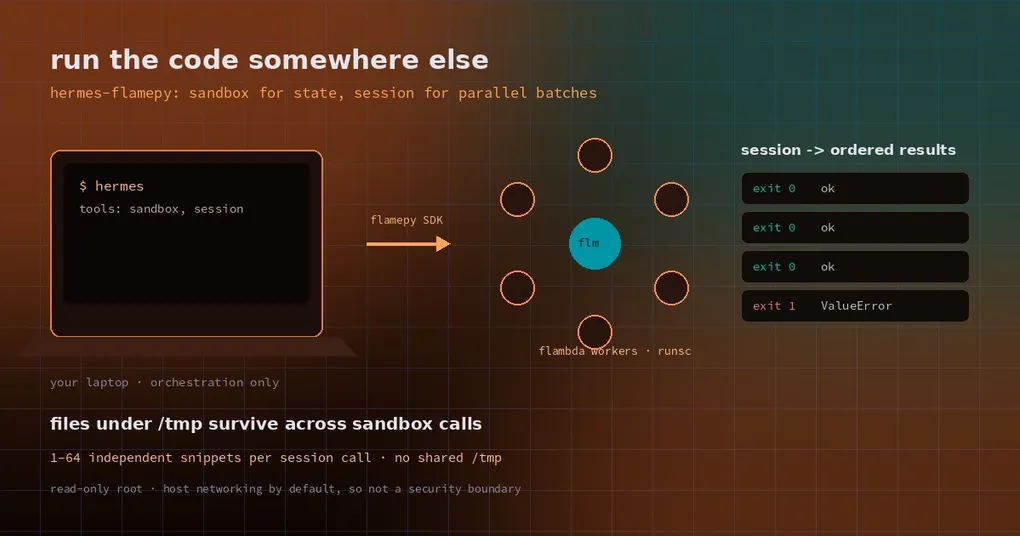
Du bittest den Agenten, ein 200 MB großes Log zu verarbeiten: bereinigen, aggregieren, als Diagramm aufbereiten. Jeder Schritt ist schnell genug – bis du drei Parameterkombinationen auf einem 16-GB-Laptop noch einmal durchlaufen lassen willst. Die Lüfter drehen auf, du beobachtest den Speicher nervös, und jeder Kandidat importiert pandas wieder von Null. Oder du möchtest acht Hypothesen gleichzeitig prüfen, und der Agent arbeitet sie nacheinander ab, weil eine lokale Shell nicht mehr hergibt.
Remote-Ausführungscluster lösen genau das, aber einen Agenten daran anzubinden heißt meistens, selbst Klebecode zu schreiben. Das Community-Plugin hermes-flamepy geht einen anderen Weg: Es ergänzt Hermes um zwei Tools, die Code-Snippets an einen Flame-Cluster übergeben – deine Maschine orchestriert nur noch und liest die Ergebnisse ab.
Drei Grenzen bei lokaler Ausführung
Das Kontextbudget. Wenn jeder Schritt Daten und Zwischenergebnisse durch das Kontextfenster des Modells schickt, ist nach wenigen Runden Schluss. Sinnvoll ist das Gegenteil: Dateien in der Ausführungsumgebung liegen lassen und dem Modell nur Zusammenfassungen geben. Nur ist lokale Ausführung ein Prozess pro Aufruf – Zustand geht dabei schnell verloren.
Die Rechenleistung. Deine Parallelität entspricht deiner Kernzahl. Parameter-Sweeps verbringen mehr Zeit in der Warteschlange als mit Rechnen.
Eine zugemüllte Umgebung. Nach Monaten von pip install-Experimenten auf dem Host weiß niemand mehr, welches Paket zu welchem Lauf gehörte.
Eine Remote-Sandbox greift alle drei Probleme gleichzeitig an: Dateien bleiben remote, die Parallelität kommt vom Cluster, und die Umgebung ist ein Wegwerf-Image.
Zwei Tools, eine Entscheidungsregel
Das Plugin stellt genau zwei Tools bereit, und die Wahl dazwischen hängt an einer einzigen Frage: Braucht der nächste Schritt die Dateien des vorherigen?
| Werkzeug | Eingabe | Ausführung | Wofür |
|---|---|---|---|
sandbox |
ein code-String |
sequenzielle Aufrufe in einer persistenten Sandbox; Dateien unter /tmp überleben zwischen den Aufrufen |
voneinander abhängige Mehrschritt-Arbeit: bereinigen → aggregieren → visualisieren |
session |
codes-Liste mit 1–64 Snippets |
jedes Snippet auf einem eigenen Executor, gleichzeitig ausgeführt, kein gemeinsames /tmp |
unabhängige Kandidaten: Sweeps, direkte Vergleiche |
Beide nehmen language (python oder shell, Standard python) und ein optionales timeout in Sekunden.
Die Regel folgt der Korrektheit, nicht dem Stil. Snippets in einer session können auf verschiedenen Workern landen, deshalb scheitert „hier eine Datei schreiben, im nächsten Snippet lesen“ zufällig. Umgekehrt verschenkt man die Parallelität, für die man bezahlt hat, wenn man unabhängige Arbeit in sandbox stopft.
Installation
hermes plugins install xflops/hermes-flamepy
hermes plugins enable hermes-flamepy
hermes tools enable flamepy
Zwei Voraussetzungen, beide zwingend:
- ein Flame-Cluster, in dem die Anwendung
flmboxregistriert ist und auf den Executorenrunsc(gVisor) läuft; flamepyab Version 0.7.0 in der Hermes-Umgebung, konfiguriert für genau diesen Cluster.
Das Plugin plant selbst nichts – es übersetzt Tool-Aufrufe in Flame-SDK-Aufrufe; Warteschlange, Worker-Zuweisung und Image-Pulls sind Sache des Clusters. Das heißt: Die Obergrenze der Zuverlässigkeit ist dein Flame-Deployment, nicht das Plugin.
Szenario eins: mehrere Schritte teilen sich Dateien
Erster Aufruf: sandbox mit shell, um die Eingabe anzulegen.
mkdir -p /tmp/demo
printf 'region,revenue,cost\neast,120,75\nwest,80,55\n' > /tmp/demo/sales.csv
Zweiter Aufruf: wieder sandbox, diesmal Python, das die Datei liest und eine Zusammenfassung schreibt.
import csv, json
from pathlib import Path

work = Path("/tmp/demo")
rows = list(csv.DictReader((work / "sales.csv").open()))
revenue = sum(int(r["revenue"]) for r in rows)
profit = revenue - sum(int(r["cost"]) for r in rows)
summary = {"rows": len(rows), "revenue": revenue, "profit": profit}
(work / "summary.json").write_text(json.dumps(summary))
print(json.dumps(summary))
Der dritte Aufruf liest sie zurück und belegt damit, dass die Datei überlebt hat. Was nicht überlebt, sind Python-Variablen oder Shell-Einstellungen – nur das Dateisystem. Eine Sandbox gibt dir dieselbe Maschine, nicht denselben Interpreter.
Wegen dieses schreibgeschützten Root-Dateisystems setzt das Plugin PIP_TARGET und PYTHONPATH auf /tmp/site-packages: Nur /tmp ist beschreibbar, also funktioniert ein normales pip install weiterhin, und spätere Aufrufe können das Paket importieren. Das Image kommt ohne uv, deshalb stehen die Inline-Abhängigkeiten nach PEP 723 nicht zur Verfügung.
Szenario zwei: vier Kandidaten in einem Aufruf
Vergleiche drei Rabattstrategien plus eine ungültige Eingabe. Jedes Programm ist unabhängig, also gehen alle vier in einen session-Aufruf:
import json

revenues = [120, 80, 150, 100]
costs = [75, 55, 90, 70]
discount = 0.1          # andere Snippets nutzen 0.0 / 0.2 / 1.2

if not 0 <= discount <= 1:
    raise ValueError("discount must be between 0 and 1")

revenue = round(sum(revenues) * (1 - discount), 2)
print(json.dumps({"discount": discount, "revenue": revenue,
                  "profit": round(revenue - sum(costs), 2)}))
Das Ergebnis ist ein Array in Einreichungsreihenfolge, ein Objekt pro Snippet:
[
  {"exit_code": 0, "stdout": "{\"discount\": 0.0, \"revenue\": 450.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.1, \"revenue\": 405.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.2, \"revenue\": 360.0, ...}\n", "stderr": ""},
  {"exit_code": 1, "stdout": "", "stderr": "ValueError: discount must be between 0 and 1\n"}
]
Beachte den letzten Eintrag: Ein fehlschlagendes Snippet lässt die anderen nicht scheitern. Ein exit_code ungleich Null heißt, dieses Programm ist gescheitert. Konnte ein Snippet gar nicht starten (Infrastruktur- oder SDK-Fehler), steht exit_code auf -1 und der Fehler in stderr. Diese Unterscheidung ist bei Batch-Validierung entscheidend: Das eine ist deine Antwort, das andere ein Umgebungsproblem.
Ergebnisse lesen, ohne sich selbst etwas vorzumachen
- Prüfe
exit_codevor der Ausgabe.0ist Erfolg,1ist meist Programmlogik,-1heißt: den Cluster-Betreiber anrufen, nicht den Debugger. - Verlass dich auf die Reihenfolge. Die Abschlussreihenfolge ist nichtdeterministisch; das Ergebnis-Array steht immer in Eingabereihenfolge, Kandidat 3 ist also immer Element 3.
- Mach Seiteneffekte idempotent. Bei einer veralteten Session wiederholt das Plugin die Einreichung einmal; war die erste Einreichung teilweise erfolgreich, können frühere Snippets erneut laufen. Schreibvorgänge und ausgehende Aufrufe sollten eine Wiederholung vertragen.
Sechs Grenzen, die man kennen sollte
- Die Sandbox ist nicht netzwerkisoliert. Die eingebaute Anwendung
flmboxstartet mit--network=host, Code erreicht also alles, was der Worker erreicht – interne Dienste eingeschlossen. Isolation ist eine Änderung an der Cluster-Konfiguration, kein Standard. - Das Root-Dateisystem ist schreibgeschützt. Beschreibbar ist nur
/tmp; exportiere alles, was du brauchst, bevor die Session endet. - Weder
sandboxnochsessionschließen sich selbst. Die Ids leiten sich aus der MAC-Adresse der Maschine ab (hermes-sandbox-<mac>,hermes-session-<mac>), sie überleben deshalb Hermes-Neustarts – und das Plugin schließt sie nie. Räum auf der Cluster-Seite auf mitflmctl list -s,flmctl close -s <id>,flmctl delete -s <id>. Ein Netzwerkadapter-Wechsel oder das Andocken an ein Dock ändert die MAC – damit ändert sich die Sandbox, und die alten Dateien sind weg. - Eine geschlossene Sandbox rutscht auf eine neue Id. Wer eine geschlossene Id weiterverwendet, öffnet
...-1,...-2, und die vorherigen Dateien sind fort. - Lösch Proxy-Variablen im richtigen Prozess. SDK-Aufrufe erben die Umgebung des Prozesses, der sie ausführt. Bei einem persistenten Gateway bringt das Ändern des Proxys in deiner CLI nichts für die Umgebung, die das Gateway bereits geerbt hat.
- Es gibt keine Mandantentrennung. Das ist ein Werkzeug für den eigenen Cluster, kein Multi-Tenant-Dienst.
Wann man es lieber nicht nutzt
- Kleine Einmal-Rechnungen. Lokales
execute_codeist weniger Zeremonie als ein RPC-Roundtrip. - GPU-Arbeit. Die veröffentlichten Messungen betreffen ausschließlich CPU-Worker; einen GPU-Pfad gibt es nicht.
- Nicht vertrauenswürdiger Code, der echte Isolation braucht. Host-Networking als Standard macht das zu einer schlechten Idee.
- Du hast eine Maschine und keinen Cluster. Dann willst du eigentlich ein lokales Container-Backend – siehe den Beitrag zur Docker-Sandbox oder die Optionen im Leitfaden zu Terminal-Backend-Plugins.
Wie man die Performance-Zahlen liest
Der Autor hat in seinem eigenen Cluster mit seinem eigenen Image gemessen – behandle die Werte als Anhaltspunkte, nicht als Versprechen: Median der ersten Sandbox-Zuweisung 148 ms mit neuem Executor und Service, 79 ms mit einem bereits vorhandenen; warme Aufrufe etwa 26 ms für Python und 8 ms für shell, rund 24 ms / 8 ms für eine session mit einem Worker. Eine Zahl zum parallelen Speedup gibt es nicht – der Beitrag sagt ausdrücklich, dass der Durchsatz nicht gemessen wurde; zitiere die Werte also nicht als „schneller als lokal“. Der Nutzen von Remote-Ausführung liegt in Kapazität und Isolation, nicht in der Latenz pro Aufruf.
Status
hermes-flamepy steht bei 0.2.0 und ist nicht im offiziellen Katalog, installiert wird also aus Git mit den drei Befehlen oben. Es verlagert die Ausführung in den Cluster, lässt aber die Beurteilung bei dir und dem Modell: Was darf parallel laufen, was muss sequenziell sein. Das ist dieselbe Arbeitsteilung wie bei austauschbaren Delegations-Backends: Das Tool schickt die Arbeit hinaus, die Orchestrierung bleibt deine Aufgabe.