Tire a execução de código do seu notebook: sandboxes persistentes e lotes paralelos com Hermes + Flame
Você pede ao agente que processe um log de 200 MB: limpar, agregar, gerar o gráfico. Cada etapa é rápida — até você querer rodar três combinações de parâmetros em um notebook de 16 GB. As ventoinhas aceleram, você acompanha a memória com apreensão e cada candidato reimporta o pandas do zero. Ou você quer oito hipóteses testadas de uma vez, e o agente roda uma por vez, porque é tudo o que um shell local consegue fazer.
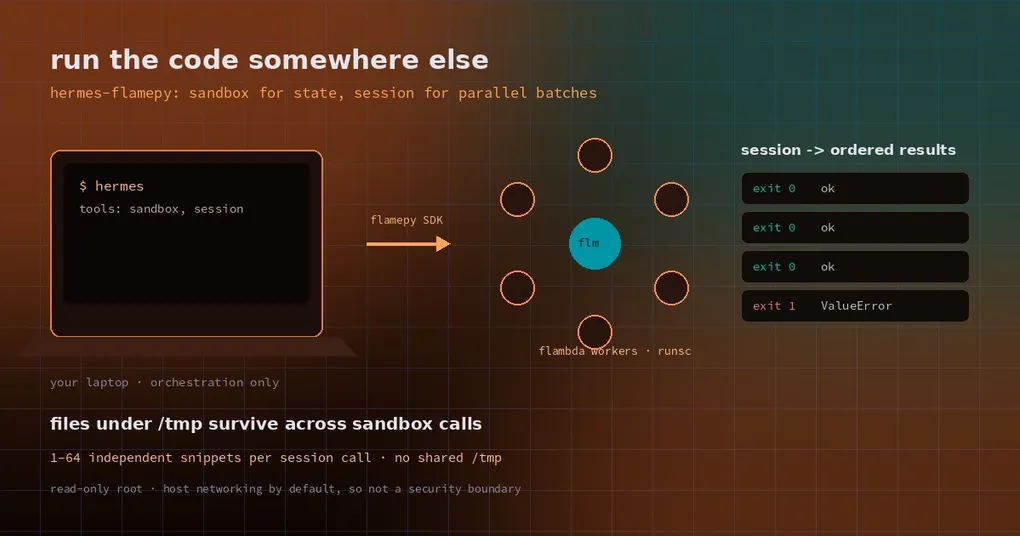
Clusters de execução remota resolvem isso, mas ligar um agente a um deles normalmente significa escrever cola. O plugin da comunidade hermes-flamepy segue outro caminho: adiciona duas ferramentas ao Hermes que enviam trechos de código para um cluster Flame, deixando a sua máquina apenas para orquestrar e ler resultados.
Três paredes que você encontra ao rodar código localmente
Orçamento de contexto. Se cada etapa devolve dados e resultados intermediários pela janela de contexto do modelo, em poucas rodadas ela está cheia. O formato certo é deixar os arquivos no ambiente de execução e entregar ao modelo só resumos — mas a execução local é um processo por chamada, então o estado se perde com facilidade.
Poder de processamento. Seu paralelismo é a quantidade de núcleos. Varreduras de parâmetros passam mais tempo na fila do que calculando.
Um ambiente sujo. Meses de experimentos com pip install na máquina e ninguém lembra mais qual pacote pertencia a qual execução.
Um sandbox remoto ataca as três de uma vez: os arquivos ficam remotos, o paralelismo vem do cluster e o ambiente é uma imagem descartável.
Duas ferramentas, uma regra de dependência
O plugin expõe exatamente duas ferramentas, e a escolha entre elas se resume a uma pergunta: a próxima etapa precisa dos arquivos da etapa anterior?
| Ferramenta | Entrada | Execução | Use para |
|---|---|---|---|
sandbox |
uma string code |
chamadas sequenciais em um sandbox persistente; arquivos em /tmp sobrevivem entre chamadas |
trabalho encadeado com dependências: limpar → agregar → gerar gráfico |
session |
lista codes de 1 a 64 trechos |
cada trecho em seu próprio executor, rodando em paralelo, sem /tmp compartilhado |
candidatos independentes: varreduras, comparações lado a lado |
As duas aceitam language (python ou shell, padrão python) e um timeout opcional em segundos.
A regra é de correção, não de estilo. Trechos em uma session podem cair em workers diferentes, então “gravo um arquivo aqui e leio no próximo trecho” falha de forma aleatória. Por outro lado, enfiar trabalho independente dentro de sandbox joga fora o paralelismo que você pagou para ter.
Instalando
hermes plugins install xflops/hermes-flamepy
hermes plugins enable hermes-flamepy
hermes tools enable flamepy
Dois pré-requisitos, ambos obrigatórios:
- um cluster Flame com a aplicação
flmboxregistrada erunsc(gVisor) nos executores; flamepy0.7.0 ou superior instalado no ambiente do Hermes, configurado para alcançar esse cluster.
O plugin não faz escalonamento nenhum — ele traduz chamadas de ferramenta em chamadas ao SDK do Flame; enfileiramento, atribuição de workers e pull de imagens são responsabilidade do cluster. Ou seja: o teto de confiabilidade dele é o seu deployment do Flame, não o plugin.
Cenário um: várias etapas compartilhando arquivos
Primeira chamada: sandbox com shell para criar a entrada.
mkdir -p /tmp/demo
printf 'region,revenue,cost\neast,120,75\nwest,80,55\n' > /tmp/demo/sales.csv
Segunda chamada: ainda sandbox, agora Python, que lê o arquivo e grava um resumo.
import csv, json
from pathlib import Path

work = Path("/tmp/demo")
rows = list(csv.DictReader((work / "sales.csv").open()))
revenue = sum(int(r["revenue"]) for r in rows)
profit = revenue - sum(int(r["cost"]) for r in rows)
summary = {"rows": len(rows), "revenue": revenue, "profit": profit}
(work / "summary.json").write_text(json.dumps(summary))
print(json.dumps(summary))
A terceira chamada lê o arquivo de volta para provar que ele sobreviveu. O que não sobrevive são variáveis Python ou configurações de shell — apenas o sistema de arquivos. Um sandbox entrega a mesma máquina, não o mesmo interpretador.
É por causa desse sistema de arquivos raiz somente leitura que o plugin define PIP_TARGET e PYTHONPATH para /tmp/site-packages: só /tmp é gravável, então um pip install comum continua funcionando e as chamadas seguintes conseguem importar o pacote. A imagem não traz uv, então metadados de dependência inline no estilo PEP 723 não estão disponíveis.
Cenário dois: quatro candidatos em uma chamada
Compare três políticas de desconto mais uma entrada inválida. Cada programa é independente, então os quatro vão em uma única chamada session:
import json

revenues = [120, 80, 150, 100]
costs = [75, 55, 90, 70]
discount = 0.1          # os outros trechos usam 0.0 / 0.2 / 1.2

if not 0 <= discount <= 1:
    raise ValueError("discount must be between 0 and 1")

revenue = round(sum(revenues) * (1 - discount), 2)
print(json.dumps({"discount": discount, "revenue": revenue,
                  "profit": round(revenue - sum(costs), 2)}))
O resultado é um array na ordem de envio, com um objeto por trecho:
[
  {"exit_code": 0, "stdout": "{\"discount\": 0.0, \"revenue\": 450.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.1, \"revenue\": 405.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.2, \"revenue\": 360.0, ...}\n", "stderr": ""},
  {"exit_code": 1, "stdout": "", "stderr": "ValueError: discount must be between 0 and 1\n"}
]
Repare na última entrada: um trecho que falha não derruba os outros. Um exit_code diferente de zero significa que aquele programa falhou. Se o trecho nem chegou a rodar (erro de infraestrutura ou do SDK), exit_code é -1 e o erro está em stderr. Essa distinção importa na validação em lote: o primeiro caso é a sua resposta, o segundo é um problema de ambiente.
Lendo resultados sem se enganar
- Confira
exit_codeantes da saída.0é sucesso,1costuma ser lógica do programa,-1significa acionar o operador do cluster, não o debugger. - Confie na ordenação. A ordem de conclusão é não determinística; o array de resultado está sempre na ordem de entrada, então o candidato 3 é sempre o elemento 3.
- Torne os efeitos colaterais idempotentes. Em uma session obsoleta o plugin reenvia a submissão uma vez; se a primeira submissão havia funcionado em parte, trechos anteriores podem rodar de novo. Escritas e chamadas externas devem tolerar uma repetição.
Seis limites que vale conhecer
- O sandbox não é isolado de rede. A aplicação
flmboxembutida inicia com--network=host, então o código alcança tudo o que o worker alcança, inclusive serviços internos. Isolamento é uma mudança na configuração do cluster, não o padrão. - O sistema de arquivos raiz é somente leitura. Só
/tmpé gravável; exporte o que precisar antes que a session termine. - Nem sandbox nem session se encerram sozinhos. Os ids derivam do endereço MAC da máquina (
hermes-sandbox-<mac>,hermes-session-<mac>), então persistem entre reinícios do Hermes — e o plugin nunca os fecha. Faça a limpeza do lado do cluster comflmctl list -s,flmctl close -s <id>,flmctl delete -s <id>. Trocar o adaptador de rede ou desconectar um notebook da dock muda o MAC, o que muda o sandbox e perde os arquivos antigos. - Um sandbox fechado passa para um novo id. Reutilizar um id fechado abre
...-1,...-2e os arquivos anteriores se foram. - Limpe variáveis de proxy no processo certo. Chamadas ao SDK herdam o ambiente do processo que as executa. Com um gateway persistente, editar o proxy no seu CLI não altera o ambiente que o gateway já herdou.
- Não existe isolamento por tenant. É uma ferramenta para o seu próprio cluster, não um serviço multiusuário.
Quando não usar
- Cálculos pequenos e pontuais. O
execute_codelocal tem menos cerimônia que uma ida e volta por RPC. - Trabalho com GPU. As medições publicadas são todas de workers de CPU; não há caminho para GPU.
- Código não confiável que exige isolamento de verdade. A rede em modo host por padrão torna isso uma má ideia.
- Você tem uma máquina só e nenhum cluster. O que você quer, na prática, é um backend de container local — veja o artigo sobre o sandbox do docker ou as opções em o guia de plugins de backend de terminal.
Como ler os números de desempenho
O autor mediu dentro do próprio cluster, com a própria imagem — trate isso como referência, não como promessa: mediana de primeira alocação do sandbox de 148 ms com um executor e serviço novos, 79 ms com um já existente; chamadas quentes em torno de 26 ms para Python e 8 ms para shell, e cerca de 24 ms / 8 ms para uma session de um único worker. Não há número de ganho de paralelismo — o texto diz explicitamente que a vazão não foi medida, então não cite isso como “mais rápido que local”. O valor da execução remota está em capacidade e isolamento, não na latência por chamada.
Status
O hermes-flamepy está na 0.2.0 e não está no catálogo oficial, então instala-se pelo Git com os três comandos acima. Ele leva a execução para o cluster, mas deixa o julgamento com você e o modelo — o que pode rodar em paralelo, o que precisa ser sequencial. É a mesma divisão de trabalho de backends de delegação plugáveis: a ferramenta despacha o trabalho, a orquestração continua sendo sua.