Sacar la ejecución de código de tu portátil: sandboxes persistentes y lotes en paralelo con Hermes + Flame
Le pides al agente que procese un log de 200 MB: limpiarlo, agregarlo, graficarlo. Cada paso es rápido, hasta que quieres volver a ejecutar tres combinaciones de parámetros en un portátil de 16 GB. Los ventiladores se aceleran, miras la memoria con nervios y cada candidato vuelve a importar pandas desde cero. O quieres comprobar ocho hipótesis a la vez y el agente las ejecuta una por una, porque es todo lo que puede hacer un shell local.
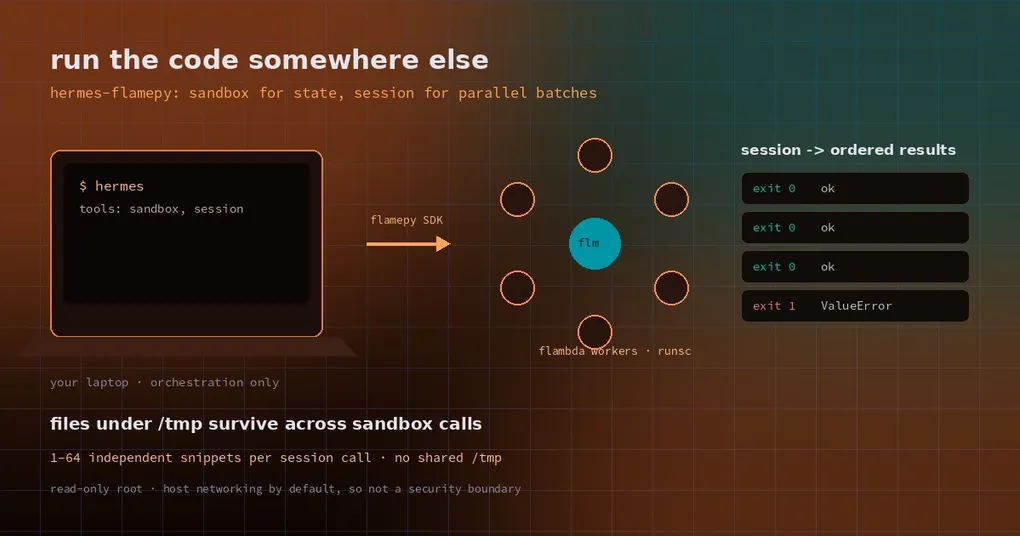
Los clústeres de ejecución remota resuelven esto, pero conectar un agente a uno de ellos suele implicar escribir pegamento. El plugin de la comunidad hermes-flamepy toma otro camino: añade dos herramientas a Hermes que envían fragmentos de código a un clúster de Flame, y deja que tu máquina se limite a orquestar y leer resultados.
Tres muros con los que chocas al ejecutar código en local
El presupuesto de contexto. Si cada paso devuelve los datos y los resultados intermedios a la ventana de contexto del modelo, a las pocas rondas está llena. La forma correcta es dejar los archivos en el entorno de ejecución y entregarle al modelo solo resúmenes, pero la ejecución local es un proceso por llamada, así que el estado se pierde con facilidad.
La potencia de cálculo. Tu paralelismo es tu número de núcleos. Los barridos de parámetros pasan más tiempo en cola que calculando.
Un entorno sucio. Meses de experimentos con pip install en el host y ya nadie recuerda qué paquete pertenecía a qué ejecución.
Un sandbox remoto ataca los tres frentes a la vez: los archivos se quedan en remoto, el paralelismo viene del clúster y el entorno es una imagen desechable.
Dos herramientas, una sola regla de dependencia
El plugin expone exactamente dos herramientas, y elegir entre ellas es responder una pregunta: ¿el siguiente paso necesita los archivos del paso anterior?
| Herramienta | Entrada | Ejecución | Úsala para |
|---|---|---|---|
sandbox |
una cadena code |
llamadas secuenciales en un mismo sandbox persistente; los archivos bajo /tmp sobreviven entre llamadas |
trabajo de varios pasos con dependencias: limpiar → agregar → graficar |
session |
lista codes de 1 a 64 fragmentos |
cada fragmento en su propio ejecutor, en ejecución concurrente, sin /tmp compartido |
candidatos independientes: barridos, comparaciones lado a lado |
Ambas aceptan language (python o shell, por defecto python) y un timeout opcional en segundos.
La regla tiene que ver con la corrección, no con el estilo. Los fragmentos de una session pueden caer en workers distintos, así que “escribo un archivo aquí y lo leo en el siguiente fragmento” falla de forma aleatoria. Y al contrario: meter trabajo independiente dentro de sandbox tira a la basura el paralelismo que ya pagaste.
Instalación
hermes plugins install xflops/hermes-flamepy
hermes plugins enable hermes-flamepy
hermes tools enable flamepy
Dos requisitos previos, ambos obligatorios:
- un clúster de Flame con la aplicación
flmboxregistrada yrunsc(gVisor) en los ejecutores; flamepy0.7.0 o posterior instalado en el entorno de Hermes, configurado para llegar a ese clúster.
El plugin no planifica nada por su cuenta: traduce las llamadas de herramienta en llamadas al SDK de Flame; las colas, la asignación de workers y la descarga de imágenes son cosa del clúster. Es decir, su techo de fiabilidad es tu despliegue de Flame, no el plugin.
Escenario uno: varios pasos que comparten archivos
Primera llamada: sandbox con shell para crear la entrada.
mkdir -p /tmp/demo
printf 'region,revenue,cost\neast,120,75\nwest,80,55\n' > /tmp/demo/sales.csv
Segunda llamada: sigue siendo sandbox, ahora Python, que lo lee y escribe un resumen.
import csv, json
from pathlib import Path

work = Path("/tmp/demo")
rows = list(csv.DictReader((work / "sales.csv").open()))
revenue = sum(int(r["revenue"]) for r in rows)
profit = revenue - sum(int(r["cost"]) for r in rows)
summary = {"rows": len(rows), "revenue": revenue, "profit": profit}
(work / "summary.json").write_text(json.dumps(summary))
print(json.dumps(summary))
La tercera llamada lo lee de vuelta para demostrar que el archivo sobrevivió. Lo que no sobrevive son las variables de Python ni la configuración del shell: solo el sistema de archivos. Un sandbox te da la misma máquina, no el mismo intérprete.
Ese sistema de archivos raíz de solo lectura explica que el plugin fije PIP_TARGET y PYTHONPATH en /tmp/site-packages: lo único escribible es /tmp, así que un pip install normal sigue funcionando y las llamadas posteriores pueden importar el paquete. La imagen no incluye uv, de modo que los metadatos de dependencias en línea de PEP 723 no están disponibles.
Escenario dos: cuatro candidatos en una sola llamada
Compara tres políticas de descuento más una entrada inválida. Cada programa es independiente, así que los cuatro van en una única llamada a session:
import json

revenues = [120, 80, 150, 100]
costs = [75, 55, 90, 70]
discount = 0.1          # otros fragmentos usan 0.0 / 0.2 / 1.2

if not 0 <= discount <= 1:
    raise ValueError("discount must be between 0 and 1")

revenue = round(sum(revenues) * (1 - discount), 2)
print(json.dumps({"discount": discount, "revenue": revenue,
                  "profit": round(revenue - sum(costs), 2)}))
El resultado es un array en el orden de envío, con un objeto por fragmento:
[
  {"exit_code": 0, "stdout": "{\"discount\": 0.0, \"revenue\": 450.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.1, \"revenue\": 405.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.2, \"revenue\": 360.0, ...}\n", "stderr": ""},
  {"exit_code": 1, "stdout": "", "stderr": "ValueError: discount must be between 0 and 1\n"}
]
Fíjate en la última entrada: un fragmento que falla no hace fallar a los demás. Un exit_code distinto de cero significa que ese programa falló. Si un fragmento no pudo ejecutarse en absoluto (error de infraestructura o del SDK), exit_code vale -1 y el error aparece en stderr. La distinción importa cuando validas por lotes: lo primero es tu respuesta, lo segundo es un problema del entorno.
Leer los resultados sin engañarte
- Mira
exit_codeantes que la salida.0es éxito,1suele ser lógica del programa y-1significa llamar al operador del clúster, no al depurador. - Confía en el orden. El orden de finalización es no determinista; el array de resultados siempre sigue el orden de entrada, así que el candidato 3 es siempre el elemento 3.
- Haz idempotentes los efectos secundarios. Con una session obsoleta el plugin reintenta el envío una vez; si el primer envío se había completado en parte, es posible que los primeros fragmentos se ejecuten de nuevo. Las escrituras y las llamadas salientes deberían tolerar una repetición.
Seis límites que conviene conocer
- El sandbox no está aislado de la red. La aplicación
flmboxintegrada arranca con--network=host, así que el código alcanza todo lo que alcanza el worker, incluidos servicios internos. El aislamiento es un cambio de configuración del clúster, no algo que venga por defecto. - El sistema de archivos raíz es de solo lectura. Solo se puede escribir en
/tmp; exporta lo que necesites antes de que termine la session. - Ni el sandbox ni la session se cierran solos. Los ids se derivan de la dirección MAC de la máquina (
hermes-sandbox-<mac>,hermes-session-<mac>), así que persisten entre reinicios de Hermes, y el plugin nunca los cierra. Limpia del lado del clúster conflmctl list -s,flmctl close -s <id>yflmctl delete -s <id>. Cambiar de adaptador de red o desacoplar el portátil cambia la MAC, lo que cambia el sandbox y hace perder los archivos antiguos. - Un sandbox cerrado pasa a un id nuevo. Reutilizar un id cerrado abre
...-1,...-2y los archivos anteriores ya no están. - Limpia las variables de proxy en el proceso correcto. Las llamadas al SDK heredan el entorno del proceso que las ejecuta. Con un gateway persistente, editar el proxy en tu CLI no toca el entorno que el gateway ya heredó.
- No hay aislamiento entre inquilinos. Es una herramienta para tu propio clúster, no un servicio multiinquilino.
Cuándo no usarlo
- Cálculos puntuales y minúsculos. Un
execute_codelocal tiene menos ceremonia que un viaje de ida y vuelta por RPC. - Trabajo con GPU. Todas las mediciones publicadas son con workers de CPU; no hay ruta para GPU.
- Código no confiable que necesita aislamiento real. Con red de host por defecto, eso es una mala idea.
- Tienes una sola máquina y ningún clúster. Lo que quieres en realidad es un backend de contenedores local: mira el artículo sobre el sandbox de Docker o las opciones de la guía de plugins de terminal backend.
Cómo leer las cifras de rendimiento
El autor midió dentro de su propio clúster, con su propia imagen: toma estos números como referencias, no como promesas. La primera asignación de un sandbox tiene una mediana de 148 ms con un ejecutor y un servicio nuevos, y de 79 ms si se reutilizan; las llamadas en caliente rondan los 26 ms en Python y los 8 ms en shell, y unos 24 ms / 8 ms para una session de un solo worker. No hay ninguna cifra de aceleración en paralelo: el texto dice explícitamente que no se midió el rendimiento, así que no los cites como “más rápido que en local”. El valor de la ejecución remota es la capacidad y el aislamiento, no la latencia por llamada.
Estado
hermes-flamepy está en la versión 0.2.0 y no figura en el catálogo oficial, así que se instala desde Git con los tres comandos de arriba. Mueve la ejecución al clúster pero te deja el criterio a ti y al modelo: qué puede ir en paralelo y qué debe ser secuencial. Es la misma división del trabajo que en los backends de delegación conectables: la herramienta saca el trabajo de casa, la orquestación sigue siendo tu tarea.