把代码执行搬出笔记本:Hermes + Flame 的持久沙箱与并行批量执行
你让 agent 处理一份 200 MB 的日志:第一步清洗、第二步统计、第三步出图。每一步都还算快,可一旦要在同一台 16 GB 的笔记本上重跑三种参数组合,风扇就开始尖叫,而你还得盯着它别把内存吃干净。更常见的情况是:你想同时验证 8 个假设,agent 只能一个一个排队,每个都从头 import 一遍 pandas。
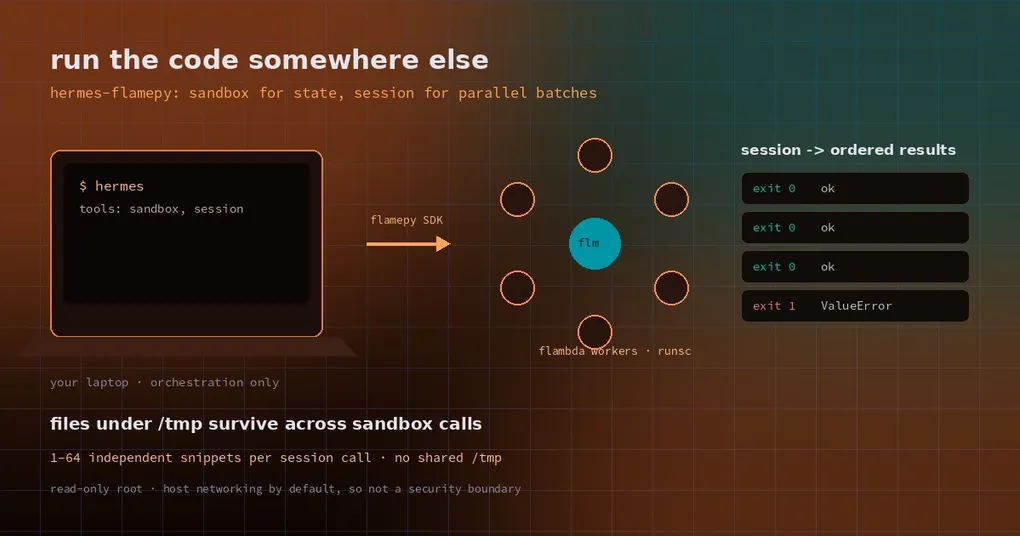
远程执行集群是这类问题的标准答案,但把 agent 接上去通常意味着一堆胶水代码。hermes-flamepy 这个社区插件走的是另一条路:给 Hermes 加两个工具,把代码片段直接提交到 Flame 集群上跑,本地只负责编排和读结果。
本地跑代码的三块天花板
先把问题说清楚,才知道什么时候该换工具。
**一是上下文预算。**如果每一步都把数据和中间结果塞回模型上下文,几轮下来窗口就满了。正确的做法是让文件留在执行环境里,模型只看摘要——但本地执行环境是“一次调用一个进程”,中间状态很容易丢。
**二是算力。**本地能起的并行度就是你机器的核数,跑参数扫描时排队时间比计算时间还长。
**三是环境脏。**在宿主机上 pip install 各种实验依赖,几个月后你自己都不知道哪个包是哪个实验装的了。
远程沙箱把这三个问题一起解决:文件留在远端、并行度由集群给、环境是一次性的镜像。
两个工具,一条依赖规则
插件只暴露两个工具,区别就一条:后一步要不要用前一步的文件。
| 工具 | 输入 | 执行方式 | 适合 |
|---|---|---|---|
sandbox |
一段 code |
同一个持久沙箱里顺序执行,/tmp 下的文件跨调用保留 |
有依赖的多步任务:清洗 → 统计 → 出图 |
session |
codes 列表(1–64 段) |
每段提交到独立执行器并行跑,不共享 /tmp |
相互独立的候选:参数扫描、多方案对比 |
两个都接受 language(python 或 shell,默认 python)和可选的 timeout(秒)。
这条依赖规则不是风格问题,是正确性问题。session 里的片段可能落到不同 worker 上,所以任何“我先在这里写个文件、下一步读它”的写法都会随机失败;反过来,明明互不依赖却塞进 sandbox 顺序跑,就是把并行度白白浪费掉。
装起来
hermes plugins install xflops/hermes-flamepy
hermes plugins enable hermes-flamepy
hermes tools enable flamepy
前置条件有两块,缺一个都跑不起来:
- 一个注册了
flmbox应用的 Flame 集群,执行器上装了 gVisor 的runsc; - Hermes 的环境里装好
flamepy0.7.0 或更新版本,并且能连上集群。
插件本身不做调度,它只是把工具调用翻译成 Flame SDK 的调用;真正的排队、分配 worker、拉镜像是集群的事。这一点挺重要:它的可靠性上限由你的 Flame 部署决定,不是装上就自动拥有一切。
场景一:连续几步共用文件
假设要让 agent 处理一份销售数据,并且希望中间文件留在远端。第一次调用 sandbox,用 shell 写文件:
mkdir -p /tmp/demo
printf 'region,revenue,cost\neast,120,75\nwest,80,55\n' > /tmp/demo/sales.csv
第二次调用仍然是 sandbox,这次用 Python 读它并写出汇总:
import csv, json
from pathlib import Path

work = Path("/tmp/demo")
rows = list(csv.DictReader((work / "sales.csv").open()))
revenue = sum(int(r["revenue"]) for r in rows)
profit = revenue - sum(int(r["cost"]) for r in rows)
summary = {"rows": len(rows), "revenue": revenue, "profit": profit}
(work / "summary.json").write_text(json.dumps(summary))
print(json.dumps(summary))
第三次再读回来,验证文件确实还在。三次调用之间,Python 变量和 shell 环境不会保留——能保留的只有文件系统里的东西。理解这一点很关键:沙箱给你的是“同一台机器”,不是“同一个解释器”。
也正因为如此,插件设了 PIP_TARGET 和 PYTHONPATH 指向 /tmp/site-packages:根文件系统是只读的,只有 /tmp 可写,直接 pip install 也能装进可写目录,之后的调用还能 import 到。镜像里没有 uv,所以 PEP 723 那种内联依赖声明用不了。
场景二:一次提交四个候选
假设要比较 0%、10%、20% 三档折扣,外加一个非法输入 120% 的健壮性检查。四段程序互相独立,一次 session 调用全提交:
import json

revenues = [120, 80, 150, 100]
costs = [75, 55, 90, 70]
discount = 0.1          # 另一段改成 0.0 / 0.2 / 1.2

if not 0 <= discount <= 1:
    raise ValueError("discount must be between 0 and 1")

revenue = round(sum(revenues) * (1 - discount), 2)
print(json.dumps({"discount": discount, "revenue": revenue,
"profit": round(revenue - sum(costs), 2)}))返回的是一个数组,顺序和提交顺序一致,每项是 {"exit_code", "stdout", "stderr"}:
[
  {"exit_code": 0, "stdout": "{\"discount\": 0.0, \"revenue\": 450.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.1, \"revenue\": 405.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.2, \"revenue\": 360.0, ...}\n", "stderr": ""},
  {"exit_code": 1, "stdout": "", "stderr": "ValueError: discount must be between 0 and 1\n"}
]注意最后一项:一段失败不影响其它段,非零 exit_code 是“这段程序自己失败了”;如果某段压根没能执行(基础设施或 SDK 错误),exit_code 是 -1,错误写在 stderr 里。这个区分在做批量验证时很有用:前者是你要的结果,后者是环境问题。
结果怎么读
三条实践规则:
- 先看
exit_code,再看输出。0才是成功;1通常是程序逻辑;-1意味着该找运维而不是改代码。 - **按顺序对应。**并行执行完成顺序是乱的,但结果数组始终按输入顺序返回,所以“第 3 个候选”永远是第 3 项,不用自己配对。
- **有副作用的代码要防重放。**会话过期时插件会重试一次提交;如果第一次提交其实已经部分成功,早先的片段可能被再执行一遍。写文件、发请求这类操作要幂等。
六个必须知道的边界
- **沙箱不是网络隔离的。**内置
flmbox应用以--network=host启动,沙箱里的代码能访问 worker 能访问的一切,包括内网服务。想要隔离得自己改集群配置,别指望默认安全。 - **根文件系统只读。**只有
/tmp可写,需要落盘的东西都往那里放,并在会话结束前导出。 - **沙箱和会话不会自动关闭。**插件用机器 MAC 地址生成固定 id(
hermes-sandbox-<mac>、hermes-session-<mac>),跨 Hermes 会话复用,但从不主动关。要清理在集群侧做:flmctl list -s、flmctl close -s <id>、flmctl delete -s <id>。另外,换了网卡或插拔扩展坞会换 MAC,等于换一个沙箱,旧文件就找不回来了。 - **关掉的沙箱会顺延新 id。**同一个 id 被关闭后再用,插件会开
...-1、...-2,旧文件视为丢失。 - **代理变量要清干净。**SDK 调用走的是执行调用的那个进程的环境;如果你的网关是常驻的,在 CLI 里改代理不改变网关已经继承的环境变量。要直连就在真正执行 SDK 的那个进程上去掉代理。
- **它没做租户隔离。**这是给“我自己的集群”用的工具,不是多租户 SaaS 沙箱。
什么时候别用它
- **一次性、几秒钟的小计算。**本地
execute_code更省事,不用等远程 RPC。 - **需要 GPU 的任务。**插件文档里的测量全部是 CPU worker,没有 GPU 路径。
- **需要强隔离处理不受信代码。**默认网络是 host 模式,跑别人的代码就是给自己开后门。
- **只有一台机器又没有集群。**这时候你真正想要的是本地容器沙箱,比如 docker 后端 或 终端后端插件 里的那些方案。
性能数字怎么看
原作者在集群内测过一组数(他们的环境、他们的镜像,只能当参考):沙箱首次分配(含新执行器与服务)中位数 148 ms,复用执行器时 79 ms;预热后单次调用中位数,Python 约 26 ms、shell 约 8 ms,session 单 worker 的 Python 约 24 ms、shell 约 8 ms。没有并行加速比的数字——原文明确说没测吞吐,所以别拿这些数当“比本地快多少”的证据。远程执行的价值在容量和隔离,不在单次延迟。
状态
hermes-flamepy 目前是 0.2.0,插件不在官方目录里,需要从 Git 安装(上面的三条命令)。它把执行搬到了集群,但把“什么时候该并行、什么时候必须顺序”的判断留给了你和模型——这一点上,可插拔委托后端那套思路是一样的:工具负责把活送出去,编排责任还在你手里。